
Один сисадмин может поддерживать рабочие места, серверы и сеть, но не должен единолично определять допустимый простой бизнеса, бюджет и приоритеты всех подразделений. Если сотрудники обращаются вразнобой, руководитель узнаёт о копиях только после сбоя, а изменения выполняются без окна работ, замена специалиста не исправит сам процесс.
Ниже — практический порядок организации ИТ в небольшой компании: реестр сервисов, приоритеты, заявки, обслуживание, изменения и проверка восстановления. Он применим к штатному специалисту и совместной работе с MSP. Сроки и состав работ устанавливаются под инфраструктуру; универсального числа компьютеров «на одного администратора» здесь нет.
1. Начните с сервисов, а не списка оборудования
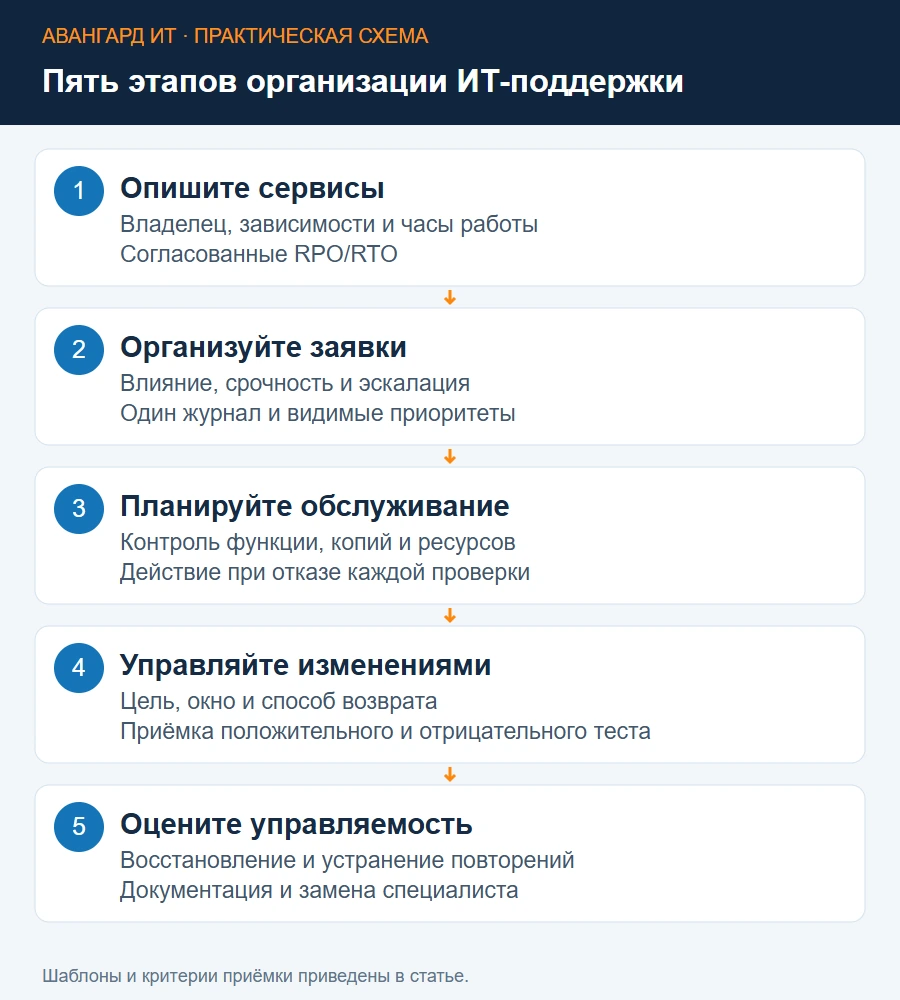
Назначьте бизнес-владельца каждому критичному сервису: 1С, почта, телефония, файловые ресурсы, сайт, интернет и удалённый доступ. Запишите пользователей, часы работы, зависимости, допустимый простой и ответственного за техническую поддержку.
Практический пример: работа отдела продаж зависит от CRM, DNS/AD, сети и провайдера. Зелёный статус сервера не подтверждает доступность CRM. Поэтому контроль должен включать вход тестового пользователя и проверку основной операции, не только ping.
Минимальная карточка сервиса:
Сервис: корпоративный файловый ресурс
Бизнес-владелец: руководитель соответствующего подразделения
Технический ответственный и замена: назначенные сотрудники/MSP
Путь и зависимости: AD/DNS, сервер, хранилище, сеть
Часы использования: согласованный график
Допустимый простой / потеря данных: утверждённые RTO / RPO
Копия: задание, хранилище, ответственный, последний тест восстановления
Контроль: доступ к ресурсу и операция с тестовым документом
Не помещайте пароли в эту карточку. Хранилище секретов указывайте отдельной ссылкой с ограниченными правами. Реестр должен принадлежать компании и быть доступен замещающему специалисту.
2. Разделите обязанности и решения
Сисадмин описывает технические варианты, риски и работы. Бизнес-владелец определяет допустимые ограничения и принимает результат. Руководитель согласует приоритеты, бюджет и ответственность. Пользователь сообщает воспроизводимый симптом и проверяет работу своей функции.
Закрепите, кто отвечает за инфраструктуру, приложение, данные, провайдера и закупки. Например, остановившееся регламентное задание 1С может требовать одновременно администратора сервера и специалиста по конфигурации. Без границы ответственности каждый видит только свой зелёный участок.
Не требуйте от одного человека одинаковой глубины в AD, сетях, СУБД, разработке 1С и информационной безопасности. Для сложных направлений назначьте эскалацию к профильному инженеру. При совместной модели заранее определите, кто имеет право менять production и кто принимает изменение.
3. Введите один канал заявок и понятные приоритеты
Заявка должна содержать сервис, пользователей, время начала, влияние, точный текст ошибки, последние изменения и способ связи. Скриншоты очищают от секретов и лишних персональных данных. Для массового сбоя создают один инцидент с привязанными обращениями.
Сервис и рабочее место:
Когда началась проблема:
Кто затронут: один пользователь / отдел / вся компания
Что не получается сделать:
Точный текст ошибки и воспроизведение:
Работало ли раньше, какие изменения были:
Есть ли допустимый обходной путь:
Контакт и время доступности:
Приоритет определяют влияние и срочность, а не должность автора и количество сообщений. Недоступность оплаты всей компании обычно отличается от запроса на новый принтер. Численные сроки реакции и восстановления согласуйте с реальными часами поддержки и зависимостями.
Для аварии оставьте отдельный канал эскалации, но после звонка зарегистрируйте событие. «Напишите администратору лично» без общего журнала делает работу невидимой и не позволяет передать незавершённые задачи на время отпуска.
4. Отделяйте восстановление от устранения причины
При инциденте сначала определите затронутые сервисы и ограничьте дальнейший ущерб. Затем восстановите согласованный минимум работы, используя подходящий обходной путь. После стабилизации разберите первопричину и заведите отдельную задачу с владельцем и сроком.
Пример: повторный restart почтовой службы временно возвращает доставку. Инцидент закрывается после проверки получения и отправки, но задача по причине повторений остаётся открытой. В ней фиксируются журналы, временная шкала, изменения и план проверки гипотезы.
Не превращайте restart «раз в сутки» в незаметную штатную эксплуатацию. У каждого обходного решения должны быть область, риск, ограниченный срок и задача удаления. Руководитель помогает выделить окно и ресурсы на исправление, а не только требует перестать получать жалобы.
5. Сделайте регулярное обслуживание проверяемым
Ежедневно или с нужной частотой контролируйте аварийные сигналы, копии, свободное место, доступность критичных функций и состояние защиты. Частота зависит от допустимого времени обнаружения: критичная система может нуждаться в автоматическом контроле чаще одного раза в день.
Раз в неделю разбирайте повторные инциденты, незавершённые изменения, рост хранилищ, состояние обновлений и доступы уволенных сотрудников. Раз в месяц проверяйте восстановление выбранного сервиса, риски, истечение сертификатов/лицензий и ближайшие проекты. Это пример календаря, который нужно адаптировать, а не обещание достаточности для любой компании.
У каждой проверки должен быть ожидаемый результат и действие при отказе. «Проверить резервное копирование» недостаточно. Полезная запись: последнее успешное задание не старше согласованного интервала, копия находится в нужном хранилище, при превышении срока создаётся инцидент с ответственным.
6. Как принимать резервные копии и восстановление
Согласуйте RPO — допустимую потерю данных по времени, и RTO — целевое время возвращения функции. Если копия запускается ночью, это не обеспечивает часовой RPO. Если восстановление занимает два дня, оно не соответствует четырёхчасовому RTO только из-за зелёного задания.
Для теста выберите отдельную среду, восстановите нужные данные и проверьте приложение. Для 1С — открытие базы и согласованную контрольную операцию; для файлов — доступ пользователя и содержимое документа; для AD — отдельный утверждённый сценарий восстановления, а не эксперимент на действующем контроллере.
В отчёте фиксируйте дату исходной копии, начало/конец восстановления, проверенные функции, ограничения и ошибки. Учтите инфраструктуру: резервная копия приложения без доступа к ключам, DNS и зависимостям может быть недостаточна. Копии с отдельными правами и защитой от изменения дополняют тест, но не заменяют его. Общие меры для небольших компаний описаны в руководстве NIST CSF 2.0.
7. Изменения проводите с планом и способом возврата
Перед обновлением, заменой коммутатора или правкой firewall сформулируйте цель и критерий успеха. Оцените затронутые сервисы, окно, резервную копию, независимый путь управления и точку решения о возврате. Не объединяйте множество непроверенных изменений в одно «обслуживание».
Изменение и цель:
Затронутые сервисы / пользователи:
Исполнитель и согласующий:
Окно и ожидаемое влияние:
Исходное состояние / проверенная копия:
Последовательность действий:
Положительный и отрицательный тест:
Условия остановки и способ возврата:
Кто принимает результат:
Для сетевого изменения проверяют не только разрешённый доступ, но и отказ к запрещённому сервису. Для обновления приложения — фактическую операцию пользователя, а не только завершение установки. Если возврат не испытан или имеет ограничения, запишите их до работ.
После выполнения сохраните фактический результат, версии, существенные настройки и незавершённые вопросы. Не пишите «всё проверено», если проверяли только открытие главной страницы.
8. Уберите зависимость от одного человека
Нужны персональные административные аккаунты, отдельные повседневные учётные записи, MFA там, где она поддерживается, и доступное компании хранилище секретов. Доступ подрядчика ограничивают необходимыми системами и сроком, а отзыв проверяют. Общий пароль администратора у всех участников мешает установить автора изменения.
Согласуйте аварийный доступ, условия его использования и аудит. У замены должны быть инструкция восстановления, схема сети, список сервисов и контакты эскалации. Раз в согласованный период проверьте, способен ли другой инженер открыть документацию и выполнить безопасный тест без помощи основного специалиста.
Контроль руководителя не означает ежедневный вход под root. Проверять нужно результат и управляемость. Подробные технические меры — в правилах информационной безопасности компании.
9. Планируйте бюджет и развитие по ограничениям
Заранее сообщайте администратору о новых офисах, сотрудниках и нагрузках. Для закупки просите несколько сопоставимых вариантов: что поддерживается сейчас, какой есть запас, где предел масштабирования, какие лицензии и обслуживание потребуются и как изменится восстановление.
Дороже не означает автоматически надёжнее, а минимальная цена не показывает общую стоимость. Сравнивайте расходы на внедрение, поддержку, простой, продление и миграцию по одинаковому составу. Технический специалист объясняет возможности и ограничения; бизнес принимает экономическое решение по своим данным.
Выделяйте время на документацию, тестовую среду и развитие навыков. Показателем работы не должно быть отсутствие минут без заявок: занятый только тушением пожаров специалист не успевает предотвращать следующий инцидент. Для сложного проекта используйте профильную экспертизу и план приёмки.
10. Как контролировать результат без микроменеджмента
Ежемесячный разговор стройте по фактам: сколько времени критичные сервисы были недоступны, какие инциденты повторились, что восстановили на тесте, какие изменения приняты, какие риски требуют решения и какие задачи следующего периода согласованы.
Полезный отчёт содержит ссылки на подтверждение, а не только количество тикетов. Не превращайте среднее время закрытия в единственную цель: оно может поощрять быстрое закрытие без устранения причины. Разделяйте плановые работы, инциденты и проекты.
Для старта в течение первого периода составьте реестр критичных сервисов, назначьте владельцев и замену, организуйте общий канал заявок, выберите один тест восстановления и одно изменение с приёмкой. По итогам уточните ресурсы и границы поддержки. Если нужна совместная работа штатного администратора и профильных инженеров, АВАНГАРД ИТ поможет организовать поддержку; модель ответственности раскрыта в статье об ИТ-аутсорсинге.