
ИТ-аутсорсинг — передача внешней команде согласованных задач по эксплуатации инфраструктуры. Компания при этом сохраняет решения о бюджете, допустимых рисках, доступах и изменениях бизнес-процессов. Практический вопрос не в количестве выездов системного администратора, а в том, кто обнаруживает сбой, восстанавливает сервис и отвечает за результат.
Ниже — рабочая схема организации поддержки для руководителя и внутреннего администратора. Она помогает описать объём обслуживания, принять инфраструктуру и проверить работу подрядчика. Конкретные сроки, стоимость и режим поддержки определяются отдельно; универсальный SLA для всех сетей не существует.
1. Как определить, что передаётся на обслуживание
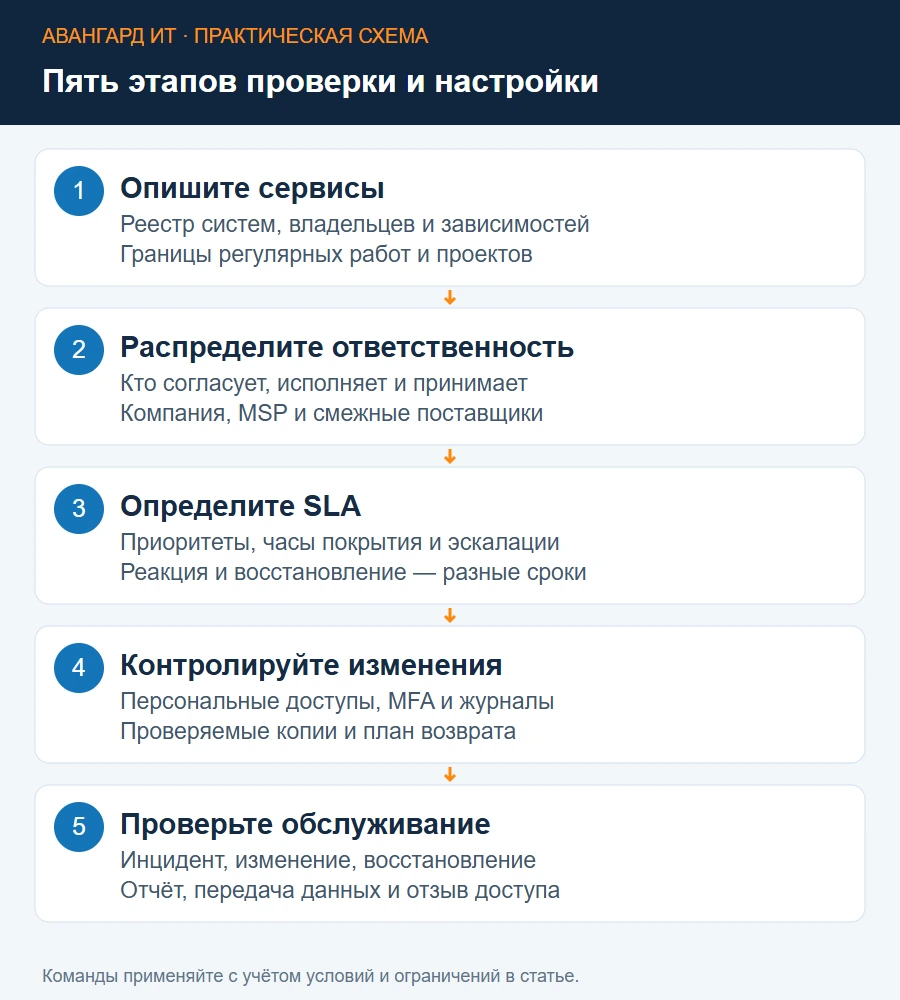
Составьте реестр объектов: рабочие места, серверы, виртуализация, сеть, VPN, резервное копирование, почта и инфраструктура приложений. Для каждого объекта укажите владельца, расположение, назначение, критичность и зависимость от других систем. Название «сервер 1С» недостаточно: нужны роли сервера приложений, СУБД, лицензирования и хранилища.
Затем опишите границу работ. Например, подрядчик обслуживает ОС и резервное копирование СУБД, а изменение конфигурации 1С выполняет другой исполнитель. Укажите, кто принимает заявку пользователя и кто координирует взаимодействие специалистов при общем инциденте.
Не включайте в реестр пароли. Для секретов заведите корпоративное хранилище с отдельными правами. Сам реестр должен быть доступен компании и обновляться при изменениях инфраструктуры.
2. Как выбрать модель: полное обслуживание или совместная работа
При полном обслуживании внешняя команда закрывает согласованные эксплуатационные роли. При совместной модели внутренний администратор и подрядчик распределяют уровни: например, внутренний специалист управляет рабочими местами, а внешняя команда — виртуализацией, сетью и восстановлением.
Выбор делайте по компетенциям, доступности и критичным зависимостям. Наличие штатного администратора не исключает внешнюю поддержку; наоборот, узкая специализация подрядчика может закрыть нехватку опыта по конкретной системе.
Для каждой роли назначьте основного исполнителя и замену. Если доступ к гипервизору есть только у одного человека, проблема сохраняется независимо от формы трудовых отношений. Проверьте сценарии отпуска, болезни и недоступности ведущего специалиста.
3. Как составить матрицу ответственности
Для каждого сервиса зафиксируйте четыре вопроса: кто выполняет работу, кто утверждает изменение, кого нужно привлечь и кто получает уведомление. Это прикладной вариант матрицы RACI; важнее распределение решений, чем терминология.
Для резервного копирования разделите задачи: исполнитель контролирует задания и тестирует восстановление; владелец сервиса определяет допустимую потерю данных; компания выделяет ресурсы хранения; ответственный за безопасность согласует доступ к копиям.
Для сетевого изменения исполнитель готовит план, владелец сервиса согласует окно и влияние, второй специалист проверяет сложный конфиг, а пользователи получают уведомление. Ни «всё делает подрядчик», ни «всё согласует директор» не заменяют этих конкретных ролей.
4. Как описать SLA без неоднозначных обещаний
В SLA различайте время реакции, начало работ, обходное решение и восстановление сервиса. Реакция за 15 минут не означает, что любой сервер будет восстановлен за 15 минут. Укажите часы обслуживания и механизм обращения за пределами этого времени.
Классифицируйте заявки по влиянию. Например, остановка общего сервиса для всей компании выше по приоритету, чем установка программы одному сотруднику. Матрица должна учитывать и влияние, и срочность: сбой резервного копирования без текущего простоя всё равно может требовать быстрой реакции.
Зафиксируйте точки отсчёта и паузы: регистрация заявки, запрос обязательных данных, ожидание поставщика или оборудования. У паузы нужны причина и уведомление. Не допускайте автоматического снятия ответственности за любой инцидент со сторонним ПО.
5. Как построить обработку заявок
Создайте единый канал регистрации и идентификатор обращения. Заявка должна содержать сервис, симптом, время, влияние, контакт и приложенные материалы без секретов. После регистрации назначается ответственный, приоритет и следующий шаг.
Для типового инцидента используйте последовательность: подтвердить симптом → установить область сбоя → восстановить или дать обходной путь → проверить с пользователем → записать причину и выполненное изменение. Если причина не установлена, не подменяйте её фразой «перезагрузили — работает».
Проверьте эскалацию на практическом примере. Кто принимает критичный инцидент, кто подключает сетевого инженера, кто сообщает руководителю о риске потери данных? Контактный телефон без процедуры передачи ответственности не обеспечивает управляемую поддержку.
6. Как выдать доступ подрядчику
Создавайте персональные административные учётные записи с минимальными необходимыми правами. Отдельно определите удалённый доступ, MFA, разрешённые рабочие станции, хранение секретов и журналирование действий. Подрядчик не должен получать неограниченный доступ ко всем системам только потому, что обслуживает часть сети.
Совместные рекомендации CISA и партнёров для MSP и их заказчиков подчёркивают разграничение доступа, MFA, контроль журналов и согласование ответственности за безопасность: рекомендации по защите MSP и клиентов. Это практическая основа проверки доступа, а не готовый договор обслуживания.
Компания должна сохранять собственный аварийный доступ и контроль над доменами, облачными подписками и лицензиями. При смене сотрудника или подрядчика отзывайте его доступы и проверяйте активные сессии. Разделите обычную поддержку пользователя и операции с правами администратора домена.
7. Как принимать инфраструктуру на обслуживание
Начните с инвентаризации и проверки наблюдаемости. Сверьте схему сети, адреса, роли серверов, версии, лицензирование и резервные копии. Обнаруженные неизвестные параметры оформите как вопросы с ответственным и сроком проверки, а не заполняйте догадками.
Подготовьте исходную оценку состояния: что работает, что не поддерживается, какие сервисы не имеют подтверждённого восстановления. Отдельно согласуйте план устранения накопленных проблем — он может выходить за рамки регулярной поддержки.
Завершите приёмку проверкой критичных сценариев: вход пользователя, доступ к основному приложению, обнаружение тестового сбоя мониторингом и восстановление выбранного объекта в изолированной среде. Передача списка IP-адресов сама по себе не является завершённым вводом в обслуживание.
8. Как управлять изменениями и резервными копиями
Для изменения укажите цель, затронутые объекты, ожидаемое влияние, исходное состояние, проверку и возврат. Сначала подготовьте конкретную конфигурацию и согласуйте окно. Для сложной операции нужен доступ к консоли, который не зависит от изменяемого сетевого пути.
Резервная копия должна иметь назначение: восстановить файл, систему, базу или целый сервис. Установите RPO — допустимый интервал потери данных — и RTO — допустимое время восстановления. Затем проверьте, укладываются ли реальный процесс и ресурсы в эти значения.
Полезный отчёт о восстановлении содержит объект, дату копии, среду теста, длительность, проверенные функции и ограничения. Отчёт «все задания зелёные» показывает выполнение копирования, но не доступность восстановленного приложения. Общие рекомендации по отдельным и проверяемым копиям — в руководстве CISA по противодействию ransomware.
9. Как оценивать результат и стоимость обслуживания
Стоимость зависит от объёма, сложности, часов покрытия, требований к выездам и ответственности. Сравнивайте предложения по одинаковому реестру и режиму. Отдельно перечислите включённые регулярные работы, проекты, оборудование и услуги третьих сторон; не смешивайте их в одну неопределённую «поддержку».
В ежемесячном отчёте смотрите на повторные инциденты, нарушения согласованных сроков, неподтверждённые копии, неуспешные обновления и открытые риски. Число закрытых тикетов не показывает качество, если одна неисправность возвращается каждую неделю.
Для пилота выберите измеримые сценарии: критичная заявка с эскалацией, восстановление, согласованное изменение и отзыв доступа. Проверяйте результат на своей инфраструктуре. Заявление о большом опыте подрядчика не заменяет прохождение этих сценариев.
10. Как передать обслуживание без потери управляемости
В договорённостях заранее предусмотрите выход: передача реестра, схем, регламентов, истории изменений, копий и списка учётных записей. Определите, какие системы принадлежат компании и как выгружаются сведения из сервисной платформы подрядчика.
При завершении обслуживания согласуйте дату перехода и ответственного за незакрытые инциденты. Новый исполнитель проверяет фактические доступы и восстановление, после чего отзываются прежние полномочия. Не отключайте все учётные записи до подтверждения аварийного доступа компании.
Для обсуждения модели поддержки подготовьте реестр сервисов, текущие проблемы, режим работы и требования к восстановлению. АВАНГАРД ИТ поможет определить границы обслуживания рабочих мест, серверов, сетей и инфраструктуры приложений. Состав работ и сроки фиксируются под конкретную компанию.
Выбираете формат ИТ-поддержки?
Сравните направления обслуживания и действующие цены, затем определите состав работ для вашей инфраструктуры.