
NGINX обрабатывает много соединений благодаря событийной модели, но высокая производительность не появляется от одного параметра worker_connections. Реальная ёмкость зависит от CPU, файловых дескрипторов, TLS, upstream-сервисов, диска, сети и поведения клиентов. Настраивать сервер нужно по измерениям и с контролируемой перезагрузкой конфигурации.
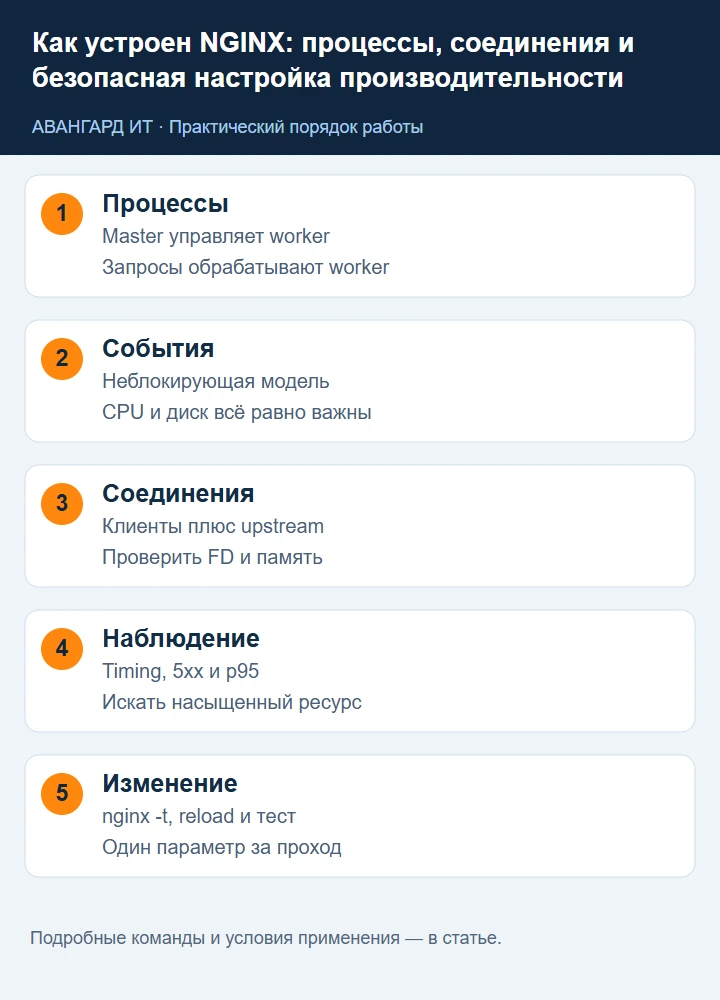
1. Разделите роли master и worker-процессов
Master читает конфигурацию, открывает сокеты, управляет worker-процессами и выполняет плавный reload. Рабочие процессы принимают соединения и обрабатывают события. В штатной работе запросы не проходят через master как через последовательный диспетчер.
ps -o pid,ppid,user,cmd -C nginx
sudo nginx -T > /tmp/nginx-effective.conf
sudo nginx -V 2>&1
nginx -T показывает итоговую конфигурацию со всеми include. Храните снимок без секретов и сравнивайте именно его.
Изолированный стенд: приложение на loopback
Следующий сценарий рассчитан на отдельную Debian/Ubuntu VM и не изменяет рабочие сайты. NGINX слушает 127.0.0.1:8080, учебное приложение — 127.0.0.1:9000. Доступ извне не требуется. Проверьте, что порты свободны; если они заняты, выберите другую согласованную пару и измените конфигурацию целиком.
sudo apt-get update
sudo apt-get install nginx python3 curl
sudo ss -ltnp '( sport = :8080 or sport = :9000 )'
install -d -m 700 "$HOME/nginx-lab"
cd "$HOME/nginx-lab"
Создайте backend.py в этом каталоге. Сервер возвращает только фиксированный учебный ответ и не выдаёт содержимое файлового каталога. ThreadingHTTPServer позволяет параллельные тесты; это лабораторное приложение, не production-сервер Python.
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

class Handler(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    def do_GET(self):
        body = b"AVG NGINX lab OK\n"
        self.send_response(200)
        self.send_header("Content-Type", "text/plain")
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

ThreadingHTTPServer(("127.0.0.1", 9000), Handler).serve_forever()
В отдельной обычной консоли запустите python3 backend.py; оставьте её открытой. Другой консолью проверьте curl -i http://127.0.0.1:9000/health: ожидаются HTTP 200 и строка AVG NGINX lab OK. Если этот тест не проходит, настройка reverse proxy пока не имеет смысла. Если после теста Ctrl+C остановил приложение, последующий 502 от NGINX будет ожидаемым результатом отсутствующего upstream.
2. Поймите событийную модель
Worker не создаёт отдельный поток на каждое соединение. Он получает уведомления о готовности сокетов и быстро переключается между задачами. Это эффективно для сетевого ввода-вывода, но блокирующий код, медленный диск или тяжёлая компрессия всё равно задерживают обработку событий.
Параметр worker_processes auto; обычно выбирает число процессов по доступным CPU. Больше процессов не гарантирует больше запросов: появляются конкуренция и переключения контекста.
Как запрос проходит через worker
После accept соединение привязано к worker, который обрабатывает его дальнейшие события. Парсер читает запрос, выбирает virtual server и location, затем модули выполняют проверку доступа, переписывание URI, выдачу файла или передачу upstream. Когда сокет приложения не готов, worker возвращается к другим готовым событиям; ожидание ответа не требует отдельного заблокированного потока на каждый клиентский сокет. HTTP/2 позволяет нескольким потокам делить клиентское соединение, поэтому RPS, число HTTP-запросов и число TCP-сокетов нельзя считать одной метрикой.
При проксировании сокеты до клиента и приложения, служебные файлы и журналы расходуют ресурсы процесса. workers × worker_connections — ограничение соединений, а не гарантированное число пользователей или RPS. Приложение может исчерпать свой пул задолго до NGINX. Keepalive-пулы тоже удерживают FD. На сервере с двумя worker и 8192 connections нельзя обещать 16384 одновременных проксируемых клиентов, не учитывая остальные соединения и лимиты.
3. Считайте соединения, а не только запросы
worker_connections ограничивает все одновременные соединения worker, включая клиентские и соединения к upstream. Прокси-запрос может занять как минимум два сокета. Верхняя граница также упирается в лимит открытых файлов процесса и системы.
worker_processes auto;
worker_rlimit_nofile 65535;
events {
    worker_connections 8192;
    multi_accept off;
}
Не копируйте цифры без проверки LimitNOFILE, доступной памяти и профиля трафика.
Лимиты FD и контролируемое изменение systemd
ulimit -n текущей shell не доказывает лимит сервисного worker. Читайте /proc/<worker-pid>/limits, а не только master. Изменение systemd LimitNOFILE требует перезапуска сервиса, потому что reload не создаёт новый master из systemd с новым лимитом. Это отдельное окно с влиянием на соединения.
systemctl show nginx -p MainPID -p LimitNOFILE
ps -o pid,ppid,user,cmd -C nginx
# Подставьте фактический PID worker:
sudo cat /proc/WORKER_PID/limits
Не задавайте миллионы FD и буферов без расчёта памяти. В примере восемь буферов по 16 KiB дают 128 KiB только одной группы буферов активного ответа; при тысячах таких запросов это уже сотни мегабайт, кроме TLS, request buffers, upstream и приложения. Профиль нагрузки определяет фактическое выделение, поэтому максимумы не равны постоянному RSS.
4. Настройте keepalive осознанно
Клиентский keepalive уменьшает число TLS-рукопожатий, но долго удерживает соединения. Отдельный keepalive к upstream сохраняет подключения к приложению. Слишком короткие значения увеличивают накладные расходы, слишком длинные занимают ресурсы и скрывают неравномерность нагрузки.
http {
    keepalive_timeout 30s;
    keepalive_requests 1000;
    upstream app_backend {
        server 127.0.0.1:9000;
        keepalive 32;
    }
}
Проверьте, поддерживает ли upstream повторное использование соединений и как работает балансировка.
Полный virtual host и объяснение его контекстов
Убедитесь через nginx -T, что /etc/nginx/conf.d/*.conf подключается внутри http. Создайте отдельный новый файл /etc/nginx/conf.d/avg-lab.conf через sudoedit, предварительно проверив отсутствие такого файла. В нём не нужно второе внешнее http {}: это уже содержимое HTTP-контекста.
log_format avg_lab '$time_iso8601 status=$status rt=$request_time '
                   'uct=$upstream_connect_time uht=$upstream_header_time '
                   'urt=$upstream_response_time';
upstream avg_lab_backend {
    server 127.0.0.1:9000;
    keepalive 16;
}
server {
    listen 127.0.0.1:8080;
    server_name localhost;
    access_log /var/log/nginx/avg-lab-access.log avg_lab;
    error_log /var/log/nginx/avg-lab-error.log warn;
    location = /nginx_status {
        stub_status;
        allow 127.0.0.1;
        deny all;
    }
    location / {
        proxy_pass http://avg_lab_backend;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Host $host;
        proxy_connect_timeout 2s;
        proxy_read_timeout 10s;
    }
}
HTTP/1.1 и пустой Connection совместно позволяют keepalive до учебного upstream. proxy_connect_timeout ограничивает установление соединения; proxy_read_timeout задаёт интервал ожидания между операциями чтения, а не универсальный предел всей бизнес-транзакции. Конкретные таймауты выбирают по бюджету приложения. URI передаётся без замены префикса, потому что proxy_pass указан без дополнительного пути.
В учебном журнале нет полного запроса и query string: это уменьшает риск записи секретов из URL. Для production формат строят по политике персональных данных и наблюдаемости. Stub status доступен только через loopback, а не публичную страницу мониторинга.
sudo nginx -t
sudo systemctl reload nginx
curl --fail --show-error http://127.0.0.1:8080/health
curl --fail --show-error http://127.0.0.1:8080/nginx_status
sudo tail -n 10 /var/log/nginx/avg-lab-access.log
Не выполняйте reload при неуспешном nginx -t. В выдаче status есть Active connections, счётчики accepts/handled/requests и Reading/Writing/Waiting. Waiting — idle keepalive, а не количество зависших приложений. Если handled отстаёт от accepts, изучите ограничения ресурсов и журнал ошибок. Одна строка status не показывает latency или успешность бизнес-операций.
5. Контролируйте буферы и временные файлы
Буферизация защищает медленное приложение от медленного клиента, но крупные ответы могут перейти во временные файлы. Отключение proxy_buffering меняет модель нагрузки и подходит не всем потоковым сценариям. Измеряйте размер ответов, использование диска и задержку.
proxy_buffering on;
proxy_buffer_size 16k;
proxy_buffers 8 16k;
proxy_busy_buffers_size 32k;
Значения — пример для стенда. Слишком большие буферы на каждом соединении быстро расходуют память.
6. Не лечите медленный upstream настройками NGINX
Разделите время соединения, получение заголовка и полный ответ приложения. Добавьте в access log $request_time, $upstream_connect_time, $upstream_header_time и $upstream_response_time. Это показывает, где возникла задержка.
log_format timing '$remote_addr $request status=$status rt=$request_time '
                  'uct=$upstream_connect_time uht=$upstream_header_time '
                  'urt=$upstream_response_time';
access_log /var/log/nginx/access_timing.log timing;
Если upstream_response_time велик, оптимизируйте приложение, базу или внешний сервис.
Интерпретация задержек и кодов ошибок
Пример строки status=200 rt=0.120 uct=0.001 uht=0.080 urt=0.090 иллюстрирует порядок величин, а не измерение этого стенда. Соединение заняло около 1 мс, заголовок пришёл позже, полный ответ upstream — около 90 мс, запрос до клиента завершился за 120 мс. Эти времена не надо бездумно складывать: они относятся к перекрывающимся этапам. При нескольких upstream-попытках поля могут содержать несколько значений, что следует учитывать в парсере.
502 часто сопровождается connect() failed, premature close или невалидным ответом upstream. Проверьте прямой curl до приложения, порт, протокол и его журнал. 504 вместе с upstream timed out показывает превышение ожидания; увеличение timeout может только увеличить очередь и скрыть деградацию. 499 означает, что клиент закрыл запрос раньше завершения: причина может быть в клиентском deadline или медленном backend, а не в «ошибке браузера». 503 может сформировать приложение либо правило ограничения; определите источник по upstream status и журналу.
7. Проверяйте конфигурацию и делайте reload
Перед применением выполните синтаксическую проверку. Успешный reload запускает новые worker с новой конфигурацией, а старые завершают текущие соединения. Restart обрывает больше работы и нужен реже.
sudo nginx -t
sudo systemctl reload nginx
sudo journalctl -u nginx --since '-5 minutes'
curl -fsS -o /dev/null -w '%{http_code} %{time_total}\n' https://example.com/health
Синтаксис ok не проверяет DNS, права на сертификаты, upstream и бизнес-функцию.
8. Наблюдайте за насыщением ресурсов
Собирайте активные соединения, RPS, коды ответа, p50/p95/p99 latency, CPU, память, файловые дескрипторы, очередь accept и retransmits. Для базовой картины можно использовать stub_status только во внутренней сети.
pid=$(cat /run/nginx.pid)
cat /proc/$pid/limits | grep -i 'open files'
ss -s
systemctl show nginx -p LimitNOFILE
Ошибки 499, 502, 503 и 504 имеют разные причины; объединять их в один показатель нельзя.
9. Нагрузочно тестируйте реалистичный маршрут
Тест должен воспроизводить TLS, размеры запросов, keepalive, кеш, upstream и постепенный рост нагрузки. Начните на стенде, затем проведите ограниченный production canary в согласованное окно. Смотрите не только среднюю скорость, но и хвост задержек и ошибки.
Зафиксируйте baseline, измените один параметр и повторите тот же профиль. Генератор нагрузки должен находиться отдельно от сервера, иначе его CPU или сеть исказят результат.
Ограниченный тест и удаление стенда
Первый тест — 20 последовательных запросов, а не резкая нагрузка. Сохраните HTTP-коды и времена, проверьте отсутствие 5xx и рост счётчика requests:
for n in $(seq 1 20); do
    curl --connect-timeout 2 --max-time 5 -sS -o /dev/null \
      -w '%{http_code} %{time_total}\n' http://127.0.0.1:8080/health
done
Этот тест проверяет маршрут и наблюдаемость, но не производительность. Для нагрузки используйте отдельный генератор, фиксированные concurrency/duration и рабочий набор ответов, постепенно повышая уровень только на разрешённом стенде. Останавливайте тест при росте ошибок или нарушения SLO. Зафиксируйте исходную конфигурацию и меняйте один фактор за раз.
Для возврата удалите только созданный avg-lab.conf после проверки его содержимого, выполните nginx -t и reload, остановите учебный backend через Ctrl+C. Убедитесь, что порт 8080 больше не слушается и существующие virtual hosts работают. Не восстанавливайте весь /etc/nginx поверх чужих изменений из ранней копии. Для рабочей настройки применяйте согласованный diff конкретных файлов.
10. Определите критерии приёмки и возврата
Изменение принято, если под целевой нагрузкой не растут 5xx, p95 укладывается в SLO, worker не упираются в CPU/FD, upstream стабилен, а reload не прервал запросы. Сохраните прежнюю конфигурацию и команду быстрого возврата.
sudo cp -a /etc/nginx /root/nginx-backup-before-tuning
sudo nginx -t && sudo systemctl reload nginx
# Возврат: восстановить проверенную конфигурацию, nginx -t, затем reload.
Источники: NGINX — Inside NGINX, NGINX — управление процессами, NGINX — core module.
Дополнительная документация: NGINX: начальное руководство, NGINX: proxy module, NGINX: stub status, NGINX: logging.
Нужно сопровождение Linux-систем?
Обновления, права, сеть, журналы и резервное копирование должны обслуживаться по регламенту и с проверяемым откатом.