
World Wide Web появился не как попытка «изобрести интернет». Интернет к тому времени уже связывал сети и компьютеры. Тим Бернерс‑Ли решал другую задачу: как дать сотрудникам CERN единый способ находить документы, переходить по связям между ними и открывать материалы на разных компьютерах, не зная устройство каждой локальной системы.
Web вырос из проблемы управления знаниями
В конце 1980-х CERN был не одной лабораторией с единым парком компьютеров. В международных экспериментах участвовали тысячи специалистов из университетов и исследовательских центров. Они приезжали на ограниченный срок, работали на несовместимых системах и оставляли документацию в разных базах, файловых хранилищах и программах. Одни данные находились на VAX/VMS, другие — на Unix, третьи — в CERNDOC или VAX/Notes. Чтобы найти описание модуля, разработчика программы или зависимость между устройствами, новому сотруднику часто приходилось спрашивать коллег.
Бернерс‑Ли описал этот организационный изъян без романтики: информация существовала, но её было трудно найти; после ухода участников часть контекста терялась; древовидный каталог плохо представлял реальные связи. Один документ одновременно относился к эксперименту, оборудованию, программе, группе людей и нескольким другим документам. Поместить его только в одну ветвь означало потерять остальные связи.
Опыт для этой идеи у Бернерса‑Ли уже был. Во время первой работы в CERN в 1980 году он написал программу ENQUIRE: она хранила небольшие карточки и позволяла связывать между собой людей, программные модули и проекты. ENQUIRE оставалась личным инструментом и не была Web, но дала практическое понимание того, насколько полезны связи между объектами.
Предложение 1989 года: сначала была не страница, а модель связей
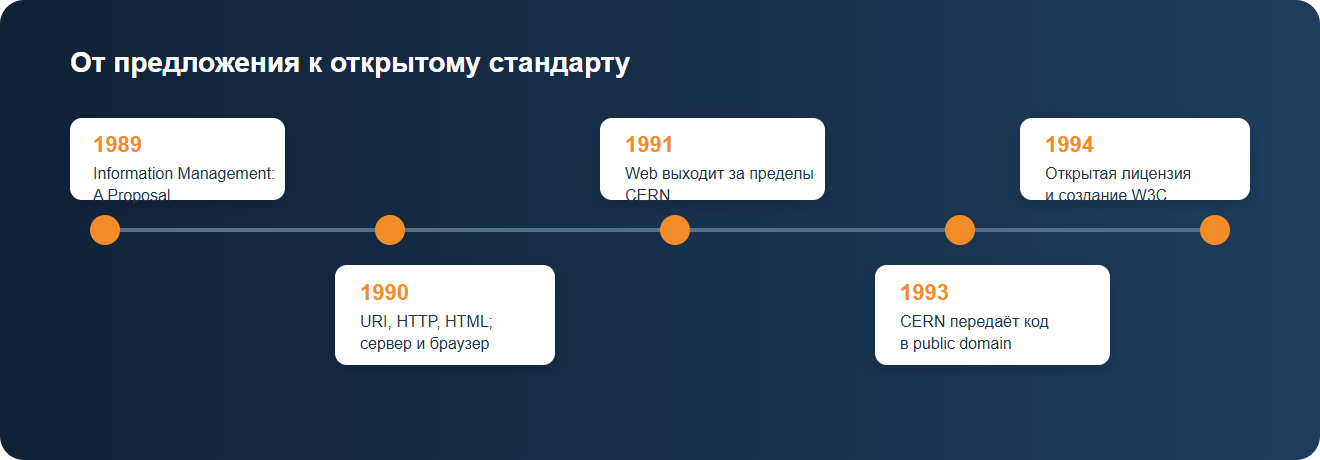
В марте 1989 года Бернерс‑Ли передал руководителю Майку Сендаллу документ Information Management: A Proposal. В нём ещё не было названия World Wide Web: проект назывался Mesh. Документ предлагал «паутину» узлов и ссылок, в которой узлом мог быть человек, программный модуль, устройство, проект, понятие или текст. Ссылка объясняла отношение: «зависит от», «создал», «является частью», «использует» или «ссылается».
Сендалл оставил на обложке ставшую известной пометку «Vague, but exciting» — «расплывчато, но интересно» — и разрешил продолжить работу. Важнее самой фразы перечень требований, сформулированный в предложении. Система должна была работать по сети, поддерживать разные платформы, подключать существующие источники данных, расти без центрального управления и оставаться простой даже для текстового терминала 80 × 24 символа.
В ноябре 1990 года Бернерс‑Ли и бельгийский инженер Робер Кайо подготовили более конкретный проект WorldWideWeb: Proposal for a HyperText Project. К этому времени название уже появилось, а концепция превратилась в план клиент-серверной системы. К Рождеству 1990 года основные части работали на компьютерах CERN.
Три основы Web: адрес, протокол и документ
Web заработал благодаря тому, что Бернерс‑Ли определил три независимые, но совместимые части. В современных документах чаще употребляют термин URI — универсальный идентификатор ресурса. Привычный URL является разновидностью URI, которая не только идентифицирует ресурс, но и указывает способ доступа к нему.
URI / URL
Глобальное имя ресурса. Оно позволяет сослаться на документ на другом сервере, не встраивая сам документ и не согласовывая ссылку с владельцем сервера.
HTTP
Правила обмена между клиентом и сервером. Клиент запрашивает ресурс, сервер возвращает представление ресурса или сообщает, почему запрос нельзя выполнить.
HTML
Формат документа. Разметка описывает заголовки, абзацы, списки и, главное, ссылки на другие ресурсы.
Такое разделение оказалось принципиальным. Адрес не зависел от программы просмотра, сервер не диктовал внешний вид окна, а документ мог ссылаться на ресурс другой организации. Новый браузер мог читать страницы старого сервера, новый сервер — обслуживать уже существующие браузеры, а автор страницы — создавать ссылку без разрешения владельца целевого ресурса.
Минимальная гипертекстовая связь в HTML выглядит просто:
<p>Документация проекта находится
  <a href="https://example.org/docs/">на сервере команды</a>.
</p>
Для пользователя это выделенный текст. Для браузера атрибут href содержит идентификатор следующего ресурса. Ссылка может вести на соседний файл, другой сервер или конкретный фрагмент документа после символа #.
Что происходит после ввода Web‑адреса
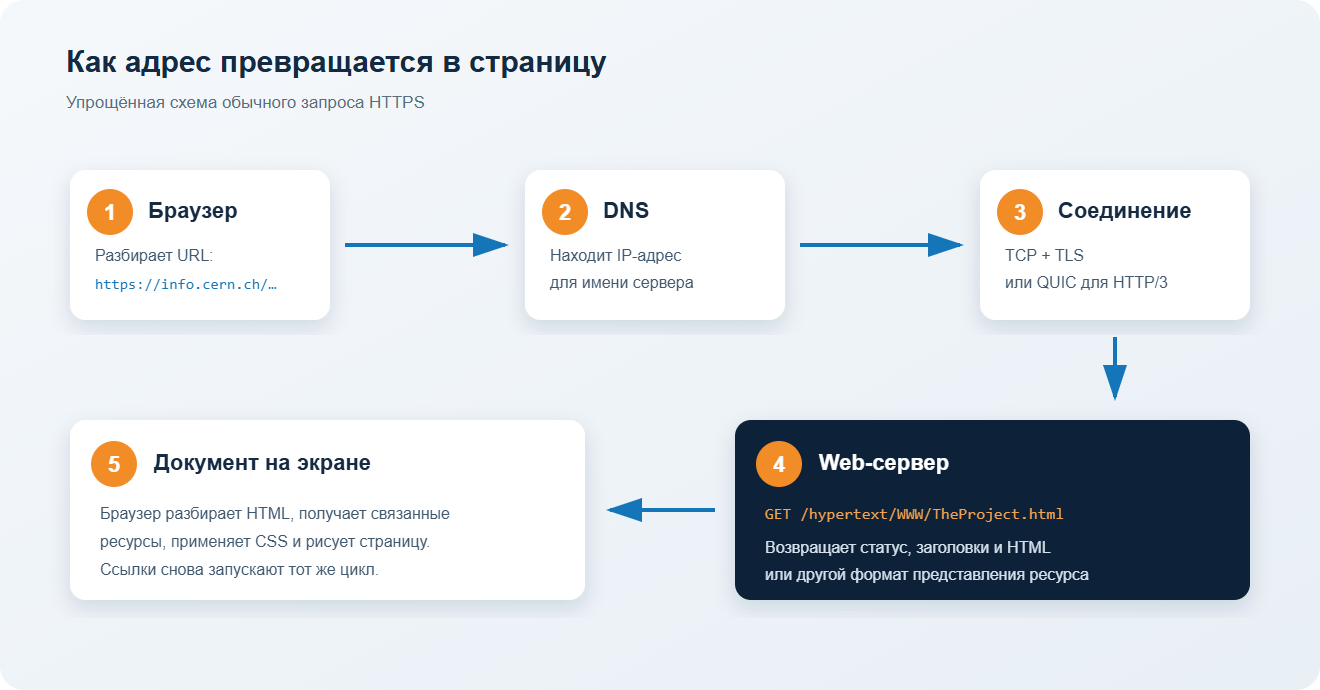
Современный браузер скрывает большую часть обмена, но общий принцип остался тем же. Рассмотрим адрес https://info.cern.ch/hypertext/WWW/TheProject.html.
- Браузер разбирает URL. Схема
httpsзадаёт способ доступа,info.cern.ch— имя узла, остальная часть — путь к ресурсу. - DNS преобразует имя в IP‑адрес. Сам Web не заменяет DNS и IP: он использует службы интернета, чтобы найти сервер и доставить пакеты.
- Устанавливается соединение. Для обычного HTTPS браузер создаёт TCP‑соединение и согласует TLS; HTTP/3 использует QUIC поверх UDP. В раннем Web применялся незашифрованный HTTP.
- Клиент отправляет HTTP‑запрос. В нём указываются метод, путь, версия протокола и заголовки. Сервер определяет ресурс и формирует ответ.
- Браузер получает представление ресурса. Для страницы это обычно HTML. Затем он загружает связанные таблицы стилей, сценарии, шрифты и изображения отдельными запросами.
- HTML превращается в документ на экране. Браузер строит структуру страницы, применяет CSS, выполняет разрешённый JavaScript и рисует результат.
Первый HTTP был гораздо проще. Формат, который позднее стали называть HTTP/0.9, поддерживал только получение документа. Запрос состоял из одной строки:
GET /hypertext/WWW/TheProject.htmlСервер отправлял тело документа и закрывал соединение. Не было строки состояния 200 OK, заголовков Content-Type, виртуальных хостов, кеширования, сжатия, аутентификации и согласования языка. Такой протокол подходил для первого опыта, но не для разнородного содержимого и коммерческого Web. HTTP/1.0, документированный в RFC 1945 в 1996 году, уже описывал полноценные запросы и ответы с заголовками; дальнейшие версии развивали производительность, кеширование и безопасность, сохраняя исходную модель «клиент запрашивает ресурс — сервер возвращает представление».
Первый Web‑сервер одновременно был рабочей станцией
Первую реализацию Бернерс‑Ли написал на NeXTcube под NeXTSTEP. Выбор был практическим: система давала объектно-ориентированную среду разработки и готовые компоненты интерфейса. За несколько месяцев он создал сервер httpd и программу WorldWideWeb. Это был не только браузер, но и редактор: пользователь мог читать страницу, изменять документ и создавать гиперссылки в графическом интерфейсе. Позднее программу переименовали в Nexus, чтобы не путать приложение со всей системой World Wide Web.
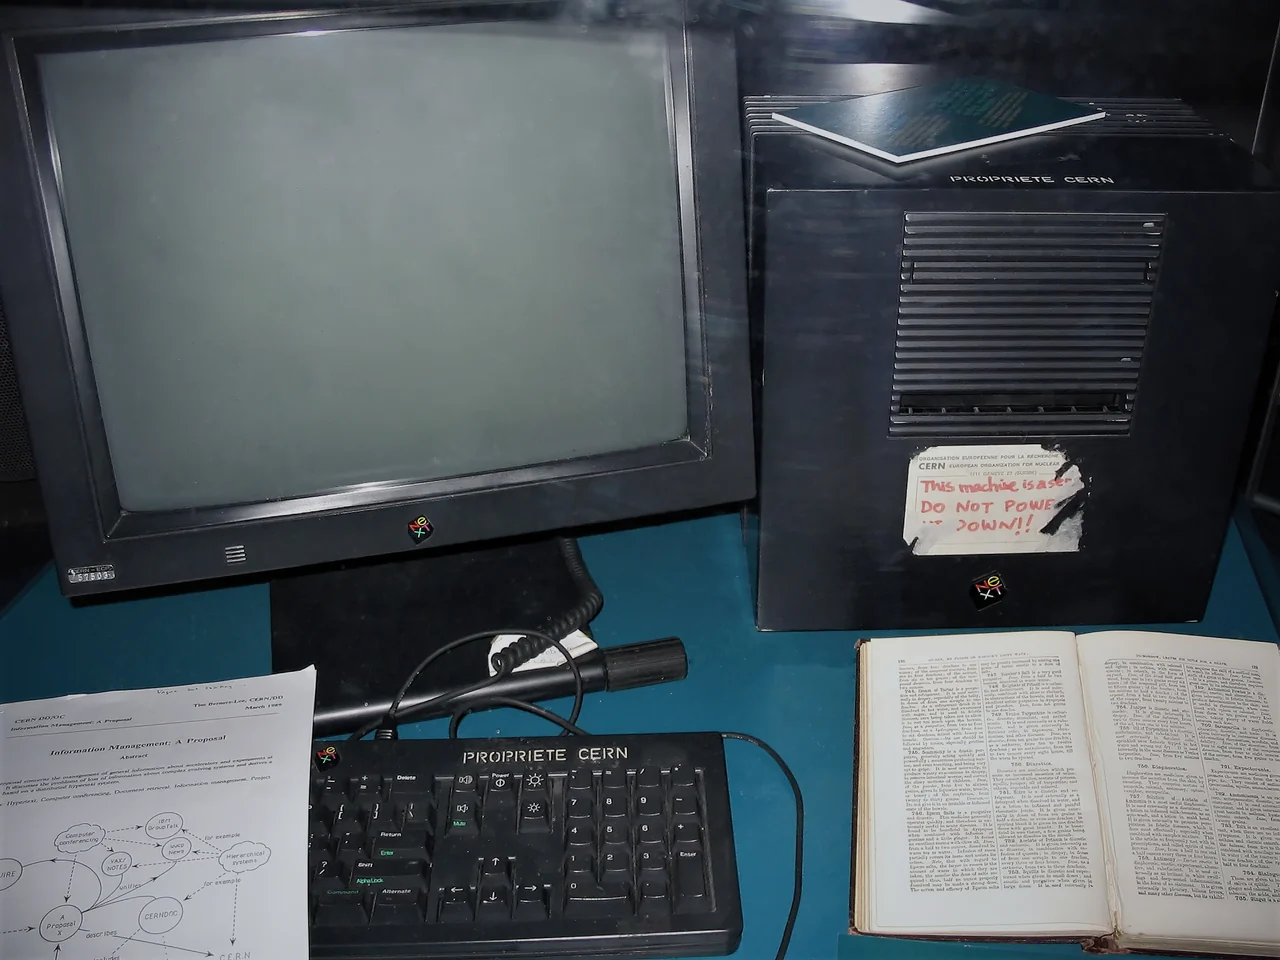
Первый сайт по адресу info.cern.ch рассказывал о самом проекте: что такое World Wide Web, какое программное обеспечение существует, как установить сервер и где найти технические сведения. Это был одновременно справочник, документация и каталог Web‑ресурсов. Сохранившаяся версия страницы выглядит скромно, потому что её задача состояла не в оформлении. Она должна была научить другого человека подключиться к системе и добавить в неё собственный узел.
Современный сайт обычно разделяет публикацию и администрирование. В первоначальном замысле чтение и редактирование находились рядом. Бернерс‑Ли считал Web пространством совместной работы, где пользователь не только потребляет страницы, но и создаёт связи. Массовые браузеры унаследовали чтение, переходы, историю и закладки, но встроенное редактирование произвольных страниц не стало обычной функцией.
Web создал Бернерс‑Ли, но распространение обеспечила команда
Авторство базовой архитектуры, первого сервера, браузера‑редактора и ранних спецификаций принадлежит Тиму Бернерс‑Ли. Однако история не сводится к одному человеку. Робер Кайо помог формализовать проект, продвигал его внутри CERN и участвовал в организации сообщества. Стажёр Никола Пеллоу разработала Line Mode Browser — текстовый браузер, который работал на разных платформах. Это сняло важное ограничение: для доступа к Web больше не требовалась рабочая станция NeXT.
Жан‑Франсуа Грофф помогал развивать код, документацию и библиотеку libwww. Другие инженеры создавали серверы, шлюзы к существующим базам и браузеры для X Window, Macintosh и Windows. В 1993 году графический NCSA Mosaic упростил установку и показ изображений внутри страницы, что резко расширило аудиторию. Технология стала массовой потому, что независимые команды могли реализовывать совместимые клиенты и серверы.
Это важное уточнение к формуле «Бернерс‑Ли изобрёл интернет». Он создал Web — глобальную гипертекстовую систему поверх уже существовавшей интернет‑инфраструктуры. А превращение прототипа в общую среду потребовало работы разработчиков, администраторов, университетов, компаний и органов стандартизации.
30 апреля 1993 года: технология перестала зависеть от разрешения CERN
В начале 1990-х Web конкурировал с другими системами публикации и поиска информации, включая Gopher и коммерческие гипертекстовые продукты. Технических достоинств было недостаточно. Организация, которая хотела развернуть сервер или написать браузер, должна была понимать, какие права она получит и не возникнет ли плата после того, как инфраструктура станет зависеть от продукта.
30 апреля 1993 года CERN объявил, что передаёт в общественное достояние три компонента: базовый Line Mode Browser, базовый сервер и библиотеку общего кода. Разрешалось использовать, копировать, изменять и распространять исходные и бинарные версии. В 1994 году следующую версию CERN HTTPD выпустили уже под собственной открытой лицензией: CERN сохранил авторское право, но предоставил бессрочное безвозмездное право использования и изменения с требованием атрибуции.
Решение устранило лицензионный риск и сделало возможной конкуренцию реализаций. Университет мог поднять сервер без договора с CERN. Разработчик мог создать браузер. Компания могла строить продукт поверх общих протоколов. Документ, опубликованный одним сервером, оставался доступен из браузера другого производителя. Так открытость закрепилась не только в исходном коде, но и в архитектуре.
- глобальные идентификаторы позволяли ссылаться на ресурсы любой организации;
- спецификации были доступны разработчикам разных платформ;
- клиенты и серверы можно было реализовывать независимо;
- публикация не требовала регистрации каждого документа в центральной базе;
- право использовать и изменять код не зависело от будущей коммерческой политики владельца.
В октябре 1994 года Бернерс‑Ли основал в MIT World Wide Web Consortium. W3C должен был согласовывать развитие технологий так, чтобы Web не распался на несовместимые частные версии. Открытость поэтому означает не отсутствие правил, а возможность публично разрабатывать единые правила и создавать по ним независимые продукты.
Web и интернет — разные уровни одной системы
Интернет соединяет сети и доставляет данные между узлами. Web создаёт поверх этой связи адресуемое пространство ресурсов, которые можно запрашивать и связывать ссылками. Если Web‑сайт недоступен, интернет у пользователя может продолжать работать: почта, VPN, SSH, IP‑телефония и другие службы используют ту же сетевую основу, но не обязаны быть частью Web.
| Уровень | Что решает | Примеры |
|---|---|---|
| Интернет | Адресация узлов, маршрутизация пакетов и связь между сетями | IP, маршрутизаторы, автономные системы, TCP и UDP |
| Сетевые службы | Конкретный обмен данными поверх интернета | DNS, электронная почта, SSH, VPN, VoIP |
| World Wide Web | Идентификация ресурсов, запрос представлений и переходы по гиперссылкам | URI/URL, HTTP, HTML, браузеры и Web‑серверы |
Граница не всегда видна пользователю. Почту читают через Web‑интерфейс, документы редактируют в браузере, а приложение вызывает HTTP API. Это означает, что конкретный клиент использует Web‑технологии. Сама электронная почта или база данных от этого не превращается в Web.
Что от проекта 1990 года осталось в современном Web
Современная страница сложнее первого сайта CERN: соединение шифруется, браузер проверяет сертификат, выполняет JavaScript, строит CSS‑раскладку, выбирает изображения для плотности экрана и может обмениваться данными с десятками серверов. HTTP/2 и HTTP/3 передают запросы иначе, а приложения работают в реальном времени. Но фундаментальная модель узнаваема.
У ресурса есть устойчивый идентификатор. Клиент запрашивает его по общему протоколу. Сервер возвращает представление. Документ содержит ссылки на другие идентификаторы. Ни владелец браузера, ни оператор сети, ни автор сервера не обязан контролировать всю систему целиком. Эта децентрализация — причина, по которой новый сайт может появиться без разрешения центрального владельца Web.
Из неё следуют вполне современные практические требования. Адреса нельзя бездумно менять: на них ссылаются люди, поисковые системы и другие документы. При переносе страницы нужен постоянный редирект. Сервер должен корректно сообщать статус ответа. Содержание должно оставаться доступным разным браузерам и устройствам. HTML обязан передавать смысл документа, а не только внешний вид. Это не набор приёмов продвижения, а продолжение архитектуры, задуманной для универсального доступа к связанным знаниям.
Самая сильная часть изобретения Бернерса‑Ли заключалась не в эффектном интерфейсе. Он предложил достаточно простые правила, по которым незнакомые друг с другом люди и программы могли создать общее информационное пространство. CERN дал этим правилам возможность распространяться без лицензионного барьера, а сообщество превратило лабораторный прототип в открытую инфраструктуру.
Источники и материалы для дальнейшего чтения
- Tim Berners-Lee. Information Management: A Proposal — HTML‑копия предложения 1989 года.
- CERN. World Wide Web at 35 — подтверждённая хронология первых лет.
- CERN. Where the web was born — первый сервер, сайт и открытие технологии.
- CERN. Licensing the Web — документы о public domain и открытой лицензии.
- W3C. History — создание консорциума и стандартизация Web.
- Tim Berners-Lee. The WorldWideWeb browser — устройство первого браузера‑редактора.
- Восстановленная страница первого сайта.
- RFC 1945: HTTP/1.0 — описание совместимости с простым запросом HTTP/0.9.
- Architecture of the World Wide Web — URI, ресурсы и базовые архитектурные принципы.
Факты и ссылки проверены 16 октября 2026 года.