В характеристиках диска указан MTBF 1 000 000 часов. Если разделить число на 8760 часов в году, получится примерно 114 лет. Значит ли это, что накопитель проработает больше века? Нет: показатель описывает надёжность в определённых условиях и не назначает дату отказа конкретному устройству.
Но полностью игнорировать MTBF тоже не нужно. Он помогает оценивать и сравнивать надёжность, если известны методика и условия. Разберём, как читать MTBF, AFR, TBW и DWPD и какие выводы из них полезны при выборе дисков для сервера, NAS и рабочих мест.
Главное: MTBF — статистический показатель. Для практического решения его рассматривают вместе с нагрузкой, ресурсом записи, условиями эксплуатации, гарантией и возможностью восстановить данные.
1. Что означает MTBF простыми словами
MTBF расшифровывается как Mean Time Between Failures — средняя наработка между отказами. В классической терминологии показатель относится к восстанавливаемым системам: они работают, отказывают, возвращаются в работу и снова накапливают наработку.
У накопителей производители также используют название MTBF для характеристик надёжности большой совокупности устройств. Поэтому читайте определение в документации конкретной модели: паспортный MTBF диска и наблюдаемый интервал между отказами ремонтируемой системы нельзя автоматически считать одним и тем же результатом измерения.
Упрощённая оценка по наблюдениям:
Средняя наработка между отказами =
суммарное время работы / количество зарегистрированных отказов
Например, 100 устройств отработали по 1000 часов, а за этот период зарегистрированы два отказа. Суммарная наработка — 100 000 часов; отношение к числу отказов — 50 000 часов. Это учебная оценка: в реальном расчёте учитывают фактическую наработку каждого устройства и выбранную статистическую модель.
Источник: IBM — что такое MTBF.
2. Почему миллион часов не означает 114 лет работы
Производитель не обязан наблюдать один диск миллион часов, чтобы получить оценку надёжности. Её могут получать по испытаниям партии, моделированию и другим методам, указанным в документации. Число относится к заявленным условиям применения и не является обещанием индивидуального срока службы.
Здесь важно разделить три вопроса:
- Насколько часто происходят отказы в рассматриваемой совокупности?
- Какой ресурс и допустимая нагрузка заявлены для модели?
- Когда откажет именно мой экземпляр?
Один MTBF не отвечает на все три. Он не описывает полностью старение, износ и внешние причины отказов. Даже модель с высоким паспортным значением может выйти из строя раньше окончания гарантии.
Поэтому 1 000 000 часов нельзя переводить в «114 лет гарантированной службы». И нельзя назначать всем HDD единый срок замены, например пять лет, только на основании MTBF. Решение зависит от условий, состояния, поддержки оборудования и требований к доступности.
Источник: Seagate — как интерпретировать надёжность HDD.
3. Чем MTBF отличается от MTTF, ресурса и гарантии
MTTF — Mean Time To Failure, средняя наработка до отказа. В классическом смысле его используют для невосстанавливаемых объектов: рассматривают время до первого отказа, после которого объект заменяют. Он тоже не предсказывает оставшееся время жизни конкретного экземпляра.
Ресурс описывает допустимую наработку или объём использования по принятому критерию. У SSD важна выносливость записи; у других устройств могут учитываться часы, циклы или иные показатели.
Гарантия — обязательства производителя с установленными условиями и исключениями. Она не означает, что устройство безотказно доработает до последнего дня, и сама по себе не является резервной копией данных.
Практическое правило: не подменяйте один термин другим. Для закупки отдельно выпишите надёжность, ресурс, нагрузку и гарантийные условия.
Источник: IBM — MTTF и его ограничения.
4. Как связаны MTBF и AFR
AFR — Annualized Failure Rate, годовой показатель интенсивности отказов. Его определение и метод расчёта нужно уточнять: паспортная модель и годовая оценка по статистике эксплуатации могут различаться.
В простом приближении при постоянной интенсивности отказов и круглосуточной работе:
Годовая интенсивность, % ≈ 8760 / MTBF × 100Для MTBF 1 000 000 часов это примерно 0,876%, а для 2 000 000 часов — 0,438%.
Это приближение часто используют для объяснения масштаба. Вероятность хотя бы одного отказа отдельного устройства за год в экспоненциальной модели считают точнее:
p = 1 − exp(−t / M)

t — время наблюдения в часах
M — средняя наработка в принятой модели
exp — экспоненциальная функция
При t = 8760 и M = 1 000 000 получаем около 0,872%. Для M = 2 000 000 — около 0,437%. При маленьких значениях различие с приближением невелико, но формулы отвечают на немного разные вопросы.
Условия этого примера: постоянная интенсивность отказов, применимость модели к рассматриваемому интервалу, соответствие эксплуатации исходным условиям. Эти проценты нельзя объявлять реальным прогнозом для любого диска лишь по числу из рекламной карточки.
Источник: NIST — экспоненциальная модель надёжности.
5. Что меняется, если дисков сто или тысяча
Низкая вероятность отказа одного устройства не означает, что в большом парке можно обойтись без замен.
В предыдущей учебной модели ожидаемое число устройств, отказавших хотя бы раз за год, равно N × p. Среди 1000 исходных устройств это около 8,72 при M = 1 000 000 и около 4,37 при M = 2 000 000. Это среднее по множеству подобных наблюдений, а не обещание получить ровно девять или четыре отказа.
Для 100 одинаковых устройств с независимыми отказами вероятность хотя бы одного отказа в парке:
P = 1 − exp(−N × t / M)При M = 1 000 000 часов за год получается около 58,36%. При M = 2 000 000 — около 35,47%.
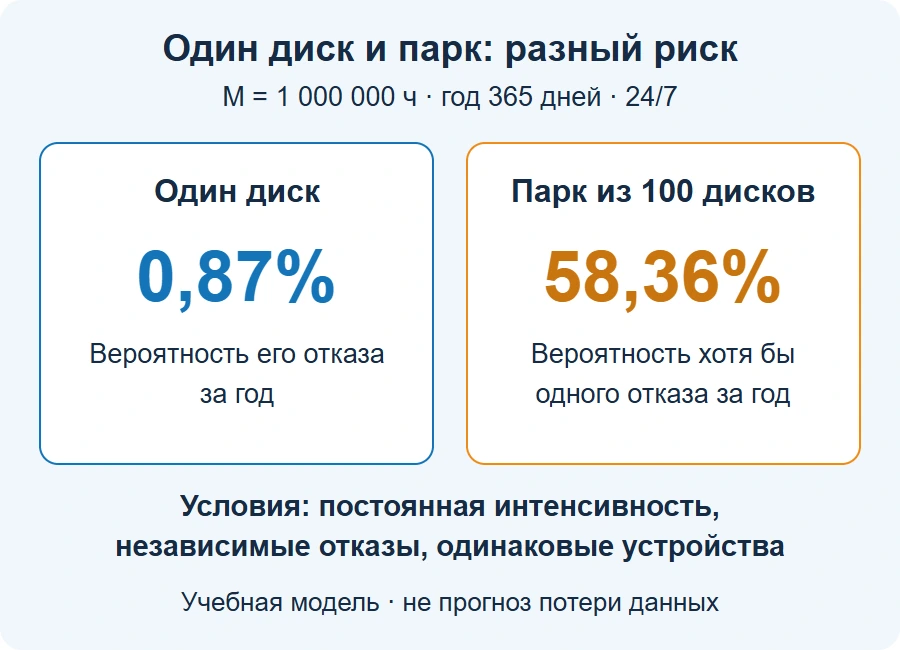
Это не вероятность потери данных и не расчёт надёжности RAID. Общая причина — перегрев, питание, ошибка прошивки или действия администратора — может затронуть несколько устройств одновременно. Тогда предположение независимости не выполняется.
Для парка оборудования показатель помогает обсуждать запасные устройства и процесс замены. Для сохранности данных нужны отдельные меры.
6. Как сравнивать два значения MTBF
Если два производителя пишут разные числа, сначала выясните, можно ли сравнивать условия.
Проверьте:
- Определение отказа: что считалось отказавшим устройством?
- Тип оценки: расчёт, испытания или фактическая эксплуатация?
- Температуру, режим работы, нагрузку и другие условия применения.
- Объём данных, длительность наблюдения и доверительный интервал, если они опубликованы.
- Точную модель, ёмкость и версию документации.
В примере с одинаковой постоянной интенсивностью удвоение M уменьшает интенсивность вдвое. Но это не означает удвоение срока службы и не гарантирует вдвое меньшие потери в вашей инфраструктуре.
Особенно осторожно относитесь к результату «отказов не было». Ноль отказов за короткий период не доказывает бесконечную надёжность. Для выводов важны накопленная наработка и статистическая неопределённость.
Источник: NIST — оценка параметров и доверительные интервалы.
7. На что смотреть при выборе HDD для сервера и NAS
Кроме MTBF или AFR, изучите назначение диска и рабочие ограничения конкретной модели.
Совместимость. Проверьте поддержку накопителя сервером, NAS, контроллером и выбранной конфигурацией хранения. Название серии не заменяет список совместимости.
Режим и нагрузка. В документации могут быть ограничения по часам работы и годовой нагрузке. У HDD workload rate может учитывать объём чтения и записи, поэтому его нельзя трактовать как ресурс только записи, аналогичный TBW SSD.
Условия эксплуатации. Температура, вибрация и плотность установки в корпусе должны соответствовать требованиям модели.
Гарантия и замена. Уточните условия, доступность запасного диска и реальный срок доставки. Высокое значение MTBF не поможет быстро вернуть сервис, если подходящую замену нужно ждать неделю.
В карточке магазина информации может не хватать. Сверяйте характеристики с актуальным техническим описанием производителя, а не только с фильтрами каталога.
Источник: Seagate — annualized workload rate.
8. Почему для SSD важны TBW и DWPD
У SSD дополнительно учитывают износ флеш-памяти при записи.
TBW — Terabytes Written: заявленный объём записи для модели по условиям производителя. Это характеристика выносливости, а не точный счётчик до мгновенной поломки.
DWPD — Drive Writes Per Day: сколько полных объёмов накопителя можно записывать в сутки в течение указанного периода при заданных условиях.
Учебная связь для одинаковых единиц объёма:
DWPD ≈ TBW / (ёмкость SSD в TB × число дней периода)Например, для SSD ёмкостью 2 TB с заявленными 3650 TBW за пять лет по 365 дней получится около 1 DWPD. Это условные значения, а не спецификация конкретной модели.
Проверьте, к какой нагрузке относится оценка, какой период использован и как сформулирована гарантия. У некоторых моделей она ограничена сроком или объёмом записи — в зависимости от того, что наступит раньше. Условия читают отдельно.
Для базы данных, виртуальных машин или журналов важен реальный объём записи и запас по выносливости. Высокий MTBF не компенсирует неправильно выбранный ресурс записи.
Источник: Kingston — TBW и DWPD.
9. Можно ли ориентироваться на SMART и статистику отказов
SMART и телеметрия помогают отслеживать состояние: ошибки, температуру, износ, изменения показателей. Интерпретация атрибутов зависит от производителя и модели; одинаковый номер атрибута не всегда означает одинаковую величину.
Хороший текущий статус не гарантирует, что завтра отказа не будет. Наблюдение дополняет резервное копирование, но не заменяет его.
Публичная статистика эксплуатации полезна как дополнительный источник. Например, Backblaze публикует данные своего парка и поясняет расчёт годовых показателей. При сравнении учитывайте количество устройств, накопленные дни работы, возраст и доверительные интервалы.
Не переносите процент отказов из чужого дата-центра на отдельный домашний NAS. Сначала посмотрите, совпадают ли модели и условия и достаточно ли наблюдений для вывода.
Источники: Seagate — интерпретация SMART, Backblaze — Drive Stats за 2025 год.
10. Почему для бизнеса важен ещё и MTTR
MTTR часто используют для среднего времени ремонта или восстановления. Чтобы сравнение имело смысл, заранее определите начало и конец измерения: с обнаружения неисправности или с фактического отказа, до замены детали или до восстановления сервиса.
Простой пример: подходящий диск уже на складе, ответственный получает оповещение, а порядок замены проверен. Одинаковая неисправность может привести к гораздо меньшему простою, чем в компании, где сначала ищут модель, закупают её и выясняют процедуру восстановления.
Не рассчитывайте доступность приложения только по MTBF одного диска. На сервис влияют сервер, питание, сеть, ПО, зависимости и действия людей.
RTO задаёт целевое время восстановления, RPO — допустимую потерю данных по времени. Эти требования помогают выбирать резервирование и резервные копии; паспортная характеристика накопителя сама их не обеспечивает.
Источники: IBM — RTO и RPO, IBM — что измеряет MTTR.
11. Как превратить характеристики в рабочий план
Для небольшой компании полезнее составить проверяемый порядок действий, чем искать одно самое большое число.
- Опишите нагрузку: объём данных, чтение и запись, режим работы, требования сервиса.
- Проверьте совместимость и ограничения HDD или SSD.
- Оцените допустимый простой и потерю данных; согласуйте RTO и RPO.
- Настройте уведомления о состоянии накопителей и массива.
- Подготовьте запасные устройства и порядок безопасной замены.
- Делайте независимые резервные копии и проверяйте восстановление.
- Определите критерии плановой замены по состоянию, поддержке и риску.
- Записывайте причины отказов и фактическую наработку своего парка.
RAID повышает устойчивость к определённым отказам, но не является резервной копией. Он не защищает сам по себе от удаления файлов, шифровальщика и всех общих причин повреждения данных.
Оценивать надёжность нужно вместе с тем, насколько быстро компания обнаружит проблему и сможет вернуть сервис. Общие правила хранения копий и ограничения доступа разобраны в нашем руководстве по информационной безопасности.
12. Частые вопросы о MTBF
Что лучше: MTBF 1 миллион или 2 миллиона часов? При сопоставимых определениях и условиях большее значение соответствует меньшей интенсивности отказов в используемой модели. Для закупки всё равно проверяйте нагрузку, совместимость и остальные ограничения.
Нужно ли менять диск, когда его наработка достигла MTBF? Нет. MTBF не задаёт персональный срок замены. Такой план строят по состоянию, требованиям к сервису, поддержке и условиям эксплуатации.
Диск с высоким MTBF может отказать в первый месяц? Да. Средний показатель не исключает ранние отказы отдельного экземпляра.
Можно ли узнать оставшийся срок службы по одному MTBF? Нет. Для такого вывода недостаточно исходной информации, а модель с постоянной интенсивностью сама по себе не описывает растущий износ.
Что важнее для SSD: MTBF или TBW? Они отвечают на разные вопросы. Надёжность не заменяет выносливость записи; решение требует обоих видов информации и условий эксплуатации.
Стоит ли совсем не смотреть на MTBF? Смотреть можно — как на одну характеристику с ограничениями. Ошибка начинается, когда показатель превращают в обещание срока службы или единственный критерий выбора.
Нужна помощь с выбором накопителей, резервированием сервера или проверкой резервных копий? Свяжитесь с АВАНГАРД ИТ.
Нужно снизить риск отказа оборудования и потери данных?
Паспортный MTBF не заменяет контроль состояния, план замены оборудования и проверяемое резервное копирование.