
Мониторинг серверов нужен, чтобы заметить проблему, понять её влияние и начать работу до обращения пользователей. Zabbix собирает показатели и формирует события, но сам по себе график CPU не назначает ответственного и не восстанавливает 1С. Пользу даёт вся цепочка: сбор → правило → уведомление → реакция → проверка результата. Мониторинг также сохраняет историю для расследования инцидентов: когда появились первые признаки деградации, что происходило с нагрузкой, какие задания и подключения совпали с изменениями и когда сервис стал полностью недоступен.
Разберём проектирование мониторинга на примерах Zabbix 7.0 LTS: метрики, шаблоны, пороги, отсутствие данных, оповещения и приёмка. Установка сервера Zabbix — отдельная задача. Документация проверена 8 ноября 2026 года; выражения и команды ниже учебные, на рабочем стенде при подготовке статьи не выполнялись. В других версиях сверяйте интерфейс и синтаксис.
От метрики до реакции: что должно работать целиком
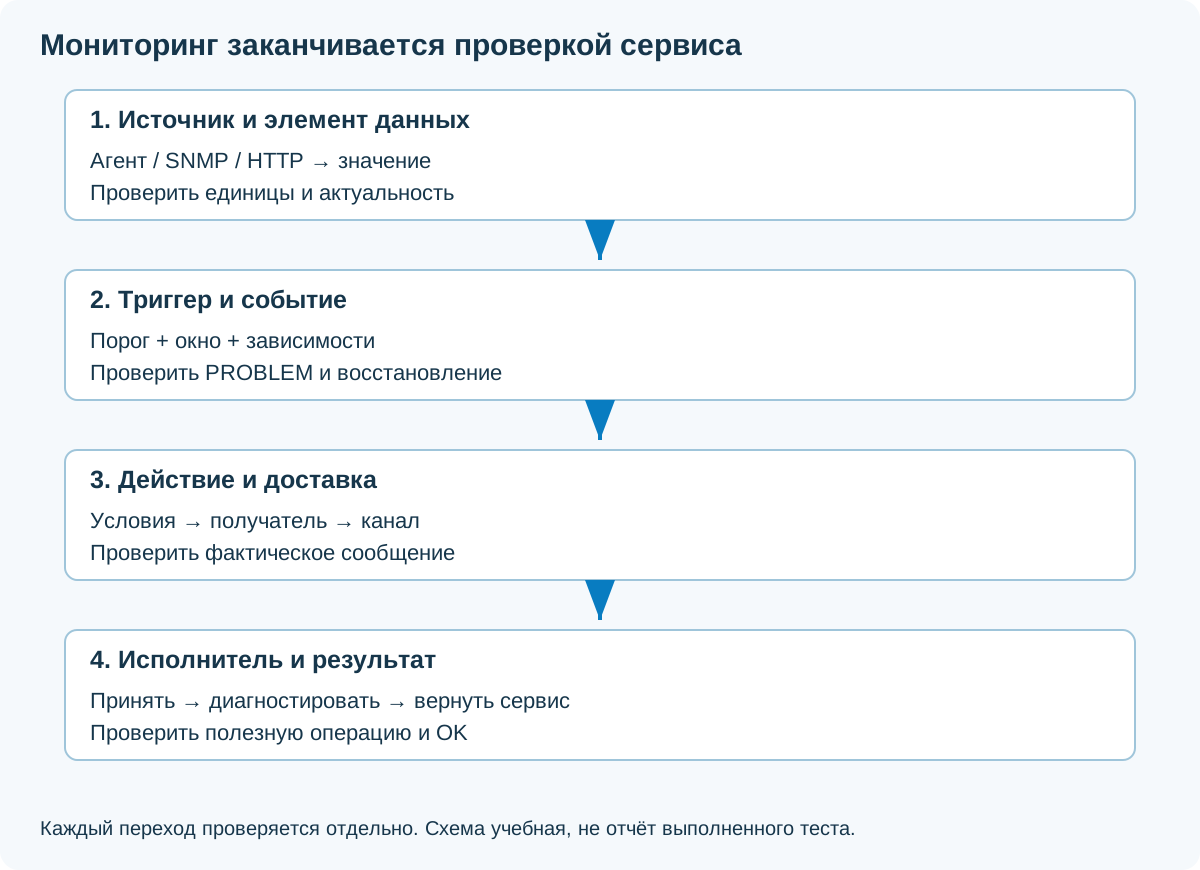
Правильный узел, показатель, единицы и время последнего значения.
Порог, длительность, зависимости и условия восстановления.
Доставка, принятие задачи, диагностика и подтверждение работы сервиса.
Для каждого критичного события заранее ответьте: кто получает, в какое время, что делает первым и кому передаёт задачу. Если этого нет, вы построили сбор статистики, но ещё не организовали обслуживание.
Начните с сервисов и владельцев, а не со всех доступных датчиков
Составьте карту: бухгалтерия зависит от 1С, 1С — от СУБД, DNS, сети, хранения и лицензирования. Затем определите критичные узлы и действия при их недоступности. Набор проверок должен отражать вашу архитектуру, а не число готовых шаблонов в каталоге.
- Критичный сервис: что перестанут делать сотрудники и какие признаки означают отказ.
- Владелец: исполнитель, резервный контакт и время обслуживания.
- Зависимости: провайдер, маршрутизатор, гипервизор, СХД, СУБД и внешние системы.
- Нормальная нагрузка: рабочий день, закрытие месяца, копирование и регламентные окна.
- Граница наблюдения: что контролируется снаружи, что агентом и что пока не измеряется.
Начните с небольшого набора полезных событий и доведите его до приёмки. Массовое включение сотен уведомлений без владельцев быстро приучает команду их игнорировать.
История мониторинга: как восстановить картину инцидента
Текущее состояние отвечает на вопрос «что происходит сейчас». История позволяет понять, когда сервер начал работать хуже, как развивалась проблема и что предшествовало отказу. Между первым ростом задержек и полной недоступностью могут пройти часы: без сохранённых метрик после перезапуска эта картина часто теряется.
Сопоставляйте графики и события Zabbix с журналами ОС, 1С, СУБД, гипервизора, VPN, удалённого доступа, сетевого оборудования и приложений. Так можно проверить, кто был подключён под какой учётной записью, какие задачи выполнялись и что в это время происходило с CPU, памятью, дисками и сетью. Данные о входах и действиях должны собираться заранее: по одному графику CPU их восстановить нельзя.
Начали расти задержки диска, хотя приложение ещё отвечало. Найдите начало отклонения от обычного профиля.
В журналах есть административный сеанс и старт тяжёлой задачи. Сверьте их с изменением нагрузки и другими событиями.
Увеличилось время операций и появилась очередь. Определите, кто ещё работал, какие обмены шли и что именно ожидало.
Сервис перестал отвечать. Это время потери доступности, а не обязательно начало инцидента.
Временная шкала условная. Совпадение административного входа и роста нагрузки не доказывает, что вошедший пользователь вызвал отказ.
Какие источники помогают ответить на разные вопросы
- Когда началось ухудшение? История метрик, время ошибок, PROBLEM/OK, задержки приложения и обращения пользователей.
- Кто подключался? Журналы входа ОС, SSH/RDP, VPN, каталога пользователей и самого приложения. Сопоставляйте учётную запись, источник, узел и идентификатор сеанса.
- Какие задачи выполнялись? Планировщики ОС, задания 1С, журнал регистрации и технологический журнал при настроенном сборе, журналы СУБД, резервного копирования и автоматизации.
- Куда обращались? Журналы reverse proxy, веб-сервера, прокси, firewall и сетевые потоки — если нужные записи собираются. DNS-запрос показывает разрешение имени, но не доказывает посещение страницы или передачу файла.
- Как это влияло на ресурсы? Сопоставление интервалов выполнения, процессов и сеансов с CPU, RAM, подкачкой, I/O и сетью; при необходимости — более подробная диагностика конкретного приложения.
Адрес IP, особенно за NAT, и общая учётная запись не позволяют уверенно назвать человека. Успешный вход также не описывает все последующие действия. Отделяйте подтверждённые факты от гипотез: «задача стартовала перед ростом I/O» — наблюдение; «задача вызвала отказ» требует дополнительных данных.
Что предусмотреть до инцидента
- Единое время. Синхронизация часов, известные часовые пояса и различие между временем события и поступлением записи. Иначе последовательность разных систем будет неточной.
- Достаточную детализацию и срок хранения. Подробная история и агрегированные trends решают разные задачи. Средние значения могут скрыть короткий всплеск; очищенный журнал нельзя получить задним числом.
- Контроль полноты. Отслеживайте пропуски, ротацию, ошибки чтения и ограничения отправки. Отсутствие записи не всегда означает отсутствие действия.
- Связь с изменениями. Записывайте время обновлений, правок конфигурации, запусков заданий и работ подрядчиков вместе с номером задачи.
- Сохранение материалов. До очистки журналов и перезапуска по возможности сохраните нужные исходные записи и метрики, отмечая источник, интервал, часовой пояс и выполненные действия.
Zabbix умеет собирать выбранные записи журналов через специально настроенные элементы, например log[] и logrt[]; для них предусмотрены активные проверки агента. Требуются права чтения и настройка обработки ротации. Условия описаны в документации по мониторингу журналов. Само подключение стандартного шаблона ОС не включает полный аудит действий пользователей.
Для большого потока событий и расследований может потребоваться отдельное централизованное хранилище журналов или SIEM, связанное с мониторингом. Выбирайте источники под задачи, ограничивайте доступ и не переносите в уведомления пароли, токены и лишние данные. Итог расследования — проверенная временная шкала и подтверждённая причина либо явно обозначенная гипотеза, а не поиск виновного по одному совпадению на графике.
Агент, SNMP, HTTP и proxy: откуда получать показатели
Агент даёт сведения ОС, SNMP — показатели поддерживаемого оборудования, HTTP/API — состояние опубликованных приложений и интеграций. Внешняя проверка показывает доступность с конкретной точки; агент внутри сервера может работать, пока пользовательский путь уже нарушен.
В пассивной схеме агент отвечает на запросы сервера или proxy; в активной — получает список проверок и передаёт результаты. Учитывайте выбранный режим, маршруты, разрешённые источники и TLS. Не открывайте агент всему интернету ради первого зелёного статуса. Документация агентных проверок описывает поддерживаемые ключи и различия.
Для филиалов proxy может собирать данные ближе к узлам и буферизовать их в пределах своей конфигурации. Он не превращает потерю связи в отсутствие проблемы: отдельно контролируйте связь с proxy и актуальность данных. Обновившийся позднее график не означает, что предупреждение было доступно в момент инцидента.
Шаблоны и discovery: подключить, проверить, адаптировать
- В Data collection → Hosts создайте или проверьте узел: техническое имя, группы, интерфейсы и выбранный server/proxy.
- Подключите шаблон, совместимый с ОС, способом сбора и версией Zabbix. Начальная точка — официальные шаблоны.
- В Monitoring → Latest data проверьте время, единицы, значения и ошибки; наличие элемента в списке ещё не означает успешного сбора.
- Проверьте обнаруженные файловые системы, интерфейсы и сервисы. Исключите временные объекты по понятным фильтрам, сохранив важные.
- Настройте предусмотренные пользовательские макросы под роль узла. Перед массовыми изменениями сохраните экспорт и прежние значения.
Названия пунктов приведены для английского интерфейса 7.0; перевод может отличаться. Не импортируйте шаблон другой ветки вслепую. Изменения общего шаблона затрагивают связанные узлы: пилотируйте на тестовой группе и проверяйте наследование, discovery и дублирующие триггеры.
Минимальный полезный набор метрик сервера
CPU и выполнение
Загрузка, отдельные ядра при необходимости, очередь и конкуренция ВМ. Высокий CPU связывайте с временем операции, а не объявляйте любой пик аварией.
Оперативная память
Доступная память, давление и подкачка, потребление значимых процессов. Кэш ОС не следует автоматически считать потерянной RAM.
Диски и файловые системы
Свободные байты и проценты, inode для нужных Linux-ФС, задержки, ошибки и рост. На аппаратном уровне — состояние RAID и SSD, если доступна достоверная телеметрия.
Сеть и оборудование
Доступность, потери, ошибки портов, загрузка, температуры, питание и состояние БП/ИБП при поддержке оборудования.
Служба может работать, когда полезная операция не выполняется. Поэтому поверх состояния ОС нужны проверки приложения: ответ HTTP, разрешение DNS, доступность СУБД и актуальность резервной копии. Состав и доступность ключей зависят от платформы, прав и способа сбора.
Свободное место: процент, объём и скорость роста вместе
Одинаковые 10% на диске 100 ГБ и на хранилище 20 ТБ означают разные возможности. Следите одновременно за абсолютным остатком, долей свободного места и характерным приростом. Для Linux раздел с достаточными байтами может закончить inode, если это применимо к его файловой системе.
Пример: журнал СУБД вырос на 80 ГБ за час. Предупреждение о 20% свободного места может прийти слишком поздно, если остаток быстро расходуется. Сначала выясните источник роста и требования хранения. Не начинайте с удаления журналов работающей базы.
Прогноз заполнения полезен, если история отражает текущую работу. Массовая загрузка, очистка или изменение расписания меняют тренд. Для RAID недостаточно видеть размер логического тома: проверьте, откуда поступает состояние физических дисков, защищённого кэша и перестроения массива.
1С, файловый сервер, DNS и копирование: проверяйте задачу
- 1С: состояние процессов и их память, доступность нужного сервиса, ошибки и контролируемый прикладной сценарий, если он реализован.
- Файловый сервер: доступность нужного ресурса, место, ошибки, права тестовой учётной записи; сам открытый порт не подтверждает чтение файла.
- DNS: ответ конкретного сервера на нужное имя, время и ожидаемый результат; доступность IP не заменяет проверку разрешения.
- Копирование: время последней успешной копии, статус задания, объём и контроль восстановления отдельным процессом.
- Веб-приложение: код ответа, ожидаемый фрагмент, задержка и срок сертификата там, где эти проверки настроены.
Синтетический сценарий не должен создавать реальные документы или запускать бизнес-обмены без согласования. Используйте выделенные данные и минимальные права. Сообщение «процесс есть» не следует превращать в обещание «вся 1С работает».
СУБД: доступность не равна нормальной производительности
Для SQL Server или PostgreSQL выберите совместимый способ сбора и отдельную учётную запись с необходимыми правами. Не храните пароль в имени элемента или тексте уведомления. Уточните, какие показатели действительно доступны и сколько стоит их получение.
Прикладной набор может включать соединения, долгие транзакции, блокировки, задержки записи, временные данные, состояние репликации и архивирования. Значения интерпретируют по версии СУБД и роли сервера. Универсальный порог количества соединений без знания пула приложения мало полезен.
Если пользователи ждут, а CPU свободен, сопоставьте время с блокировками и внешними ожиданиями. Не настраивайте автоматический перезапуск СУБД как реакцию на любой медленный запрос. Мониторинг должен предоставить контекст для диагностики, а не создавать новый простой.
Сетевые зависимости: как избежать сотни одинаковых сообщений
Когда недоступен маршрутизатор, десятки серверов за ним могут одновременно перестать отвечать. Укажите зависимости триггеров, чтобы события отражали причинную цепочку и не создавали лишние действия. Это механизм правил, а не автоматическое доказательство первопричины.
Проверьте порядок обнаружения и восстановления, состояние proxy и независимые пути доступа. Неверная зависимость способна скрыть самостоятельную неисправность. Например, ошибка диска не должна бесследно подавляться только потому, что временно потерялся один сетевой маршрут.
На карте сети обозначьте точку проверки. Отказ доступа из одного филиала и недоступность сервера для всех пользователей требуют разных уведомлений и разных исполнителей.
Практический триггер: мало места с устойчивым восстановлением
Ниже пример для существующего элемента vfs.fs.size[/var,pfree], который хранит процент свободного места. srv-1c — точное техническое имя тестового узла. Путь и ключ замените фактическими; /var может не быть отдельным рабочим разделом в вашей системе.
Задайте пользовательские макросы без знака процента:
{$DISK.FREE.PROBLEM} = 20
{$DISK.FREE.RECOVERY} = 25
Выражение проблемы: все собранные значения за последние пять минут ниже порога:
max(/srv-1c/vfs.fs.size[/var,pfree],5m)<{$DISK.FREE.PROBLEM}В настройке OK event generation выберите Recovery expression и задайте дополнительное условие:
min(/srv-1c/vfs.fs.size[/var,pfree],5m)>{$DISK.FREE.RECOVERY}Разные границы уменьшают переключение туда-сюда. Восстановление требует, чтобы условие проблемы стало ложным и дополнительное условие — истинным. Это соответствует правилам выражений Zabbix.
Ограничение: функция оценивает имеющиеся измерения и не доказывает полноту пятиминутной истории. После создания элемента дождитесь устойчивого сбора и контролируйте отсутствие данных; при необходимости добавьте проверку числа значений под ваш интервал. Не создавайте дубликат уже работающего дискового триггера шаблона. Пороги 20/25 — учебные, не норматив для всех серверов.
Отсутствие данных: тишина тоже должна стать событием
Старое зелёное значение может оставаться на графике после остановки сбора. Разделяйте нормальное значение, unsupported item, пустую историю и потерю пути от агента через proxy к серверу.
nodata(/srv-1c/agent.ping,5m)=1Пример означает отсутствие данных этого элемента в заданном интервале, а не доказанный отказ машины. До применения проверьте режим агента, интервал, плановые окна и особенности работы с proxy. Функции истории описывают поведение nodata; после перезапусков и задержек возможен отдельный контекст.
Для критичного узла полезно сочетать независимую проверку доступности и контроль актуальности агентных данных. Тогда «нет значений» можно отличить от «узел доступен, но проверка сломана». Если item unsupported, первым делом прочитайте его ошибку.
Оповещения: событие, действие, канал и человек
- Событие: нужная severity, теги service/environment/team и корректное имя узла.
- Действие: условия должны выбрать это событие, а операции — нужных получателей.
- Получатель: права на узел, включённый media type, допустимые severity и рабочее время.
- Доставка: проверить фактическое сообщение и журнал попыток, а не только кнопку теста канала.
- Реакция: принятие задачи, эскалация и сообщение о восстановлении.
Параметры действий и отправки сообщений проверяются вместе. Успешный ответ webhook ещё не подтверждает, что дежурный увидел уведомление и принял задачу.
- Сервис
- Рабочая база 1С / production
- Сигнал
- Свободное место ниже принятого порога
- Владелец
- Дежурная группа сопровождения
- Первый шаг
- Проверить рост файлов, копирование и состояние СУБД
- Запрет
- Не удалять файлы базы и журналов вслепую
Авторский пример состава карточки. Это не снимок интерфейса Zabbix и не реальное уведомление.
В шаблон сообщения включите узел, сервис, время, текущую величину, порог, ссылку на событие и короткую инструкцию. Пароли, токены и содержимое бизнес-документов туда не помещают. Интервал обнаружения и выбранное окно триггера входят в задержку до уведомления; обещание времени реакции должно учитывать всю цепочку.
Регламентные окна и шум: контролируемое подавление
Настройте maintenance для согласованного обслуживания: какие узлы, какие события и в какое время. Укажите владельца окна и окончание. Подавление уведомлений не должно навсегда маскировать отказ после работ.
Не считайте maintenance универсальным выключателем всех действий. Поведение зависит от режима сбора и настроек действия; операции восстановления и обновления имеют свои условия. Проверьте тестовым событием, что подавляется именно нужное, и что после окна нормальная обработка возвращается.
Для борьбы с шумом используйте обоснованные пороги, длительность и зависимости, а не повышение severity всему подряд. Регулярно разбирайте часто повторяющиеся события: полезны ли они, кому назначены и что изменилось после прошлого раза.
Диагностика сбора: проверяйте путь по этапам
Для установленного Agent 2 в Linux можно локально проверить ключи. Путь конфигурации, бинарник и пользователя замените фактическими:
zabbix_agent2 -c /etc/zabbix/zabbix_agent2.conf -t 'agent.ping'
zabbix_agent2 -c /etc/zabbix/zabbix_agent2.conf -t 'vfs.fs.size[/var,pfree]'
Назначение -t описано в справке Agent 2. Выполняйте проверку в разрешённом контексте, сопоставимом с пользователем службы; успешный запуск под root не доказывает доступ службы к тому же ресурсу. Не копируйте в заявку всю конфигурацию с секретами.
- Ключ не поддержан локально → проверить платформу, плагин, параметры и права.
- Локально работает, в Latest data нет значений → режим active/passive, имя узла, маршрут, TLS, proxy и журналы.
- Значения есть, события нет → выражение, макросы, состояние триггера, зависимости и история.
- Событие есть, сообщения нет → условия action, операции, права пользователя, media и журнал доставки.
- Сообщение пришло, реакции нет → расписание дежурства, принятие задачи и эскалация.
Меняйте по одному фактору и сохраняйте исходное состояние. Отключение TLS или выдача широких прав не является штатным способом исправить сбор метрик.
Кто следит за самим мониторингом
Контролируйте сервер Zabbix, его БД, место, очередь и ошибки обработки, состояние proxy и каналов оповещения. Если мониторинг недоступен, уведомление через тот же единственный сервер может не появиться.
Для критичной среды согласуйте независимую внешнюю проверку и резервный способ связи. Это отдельная схема с понятными владельцами и доступами. Периодический контрольный сигнал полезен только тогда, когда отсутствие ожидаемого сигнала тоже замечает независимая сторона.
После обновления шаблонов, агентов или webhook повторяйте соответствующие проверки. Удалённый токен, истёкший сертификат и изменившееся имя узла способны нарушить обслуживание без отказа самого бизнес-сервера.
Интервалы, история и нагрузка на мониторинг
Критичный быстрый сигнал и медленный показатель ёмкости не обязаны опрашиваться одинаково. Интервал выбирают по задаче, стоимости запроса и допустимой задержке. Частый тяжёлый SQL-запрос может сам стать источником нагрузки.
Арифметический пример: 100 узлов × 50 элементов × 1 440 опросов в сутки при интервале 60 секунд = 7,2 млн планируемых значений в сутки. Это условная оценка одинакового расписания без ошибок и зависимых элементов, а не прогноз размера БД. Объём зависит от типов данных, хранения, сжатия и обработки.
Разделяйте подробную историю и агрегированные trends. Редкие усреднённые точки могут скрыть короткий пик. Срок хранения определяйте по времени расследований и требованиям команды; после изменения частоты или discovery оцените фактическую нагрузку и свободное место.
Три прикладных ситуации
Заканчивается диск СУБД
Событие должно назвать нужный том и владельца, приложить остаток и рост. Исполнитель выясняет источник, согласует действие и проверяет сервис. Закрытие триггера после освобождения места не подтверждает успешный обмен или проведение документа.
Пропала связь с филиалом
Сначала отличите отказ канала, proxy и отдельных серверов. Правильные зависимости уменьшают дубли, но после восстановления связи нужно проверить свежесть метрик и не пропустить самостоятельные неисправности.
Задание копирования зелёное, восстановление не проходит
Мониторинг статуса задания видел только успешное завершение. Добавьте проверку возраста и состава копий, а тест восстановления оформите отдельным регулярным процессом. Его результат также можно передавать в мониторинг согласованным способом.
Сценарии учебные. Они показывают границы проверки и не являются описанием внедрений или доказательством выполненной диагностики.
Приёмка: проверить PROBLEM, доставку, реакцию и OK
- На согласованном тестовом узле создайте безопасное условие события. Не заполняйте рабочий диск и не останавливайте производственную СУБД.
- Проверьте появление PROBLEM: время, узел, severity, теги, макросы и зависимость.
- Подтвердите сообщение у фактического получателя и его принятие, а не только статус отправки.
- Проверьте согласованную эскалацию и расписание, включая резервного исполнителя.
- Верните нормальное условие, дождитесь OK по заданным правилам и проверьте сообщение восстановления.
- Отдельно испытайте отсутствие данных, нужное maintenance и возвращение обработки после окна.
- Зафиксируйте результат, ошибки и ответственных; удалите временные правила и тестовые доступы.
Время обнаружения, доставки и принятия — разные величины. Записывайте их отдельно. В этой статье такая приёмка на действующей системе не выполнялась; она предложена как процедура для вашего проекта.
Изменения и возврат: как не сломать существующий мониторинг
Перед правкой экспортируйте затронутые шаблоны/объекты доступным способом и сохраните значения макросов, маршруты уведомлений и исходный список узлов. Экспорт объектов не равен резервной копии всей БД Zabbix.
Вводите изменение на ограниченной группе. Если вырос шум или потерялась видимость, верните именно изменённые пороги и правила, проверьте Latest data и повторите контрольный сценарий. Не выключайте общий action для всех production-серверов, чтобы скрыть ошибку одного нового триггера.
Не удаляйте историю инцидента до разбора. После возврата убедитесь, что события снова обрабатываются, секреты не попали в журналы и временные исключения не остались навсегда.
Материалы для запуска мониторинга
Паспорт проверки
Сервис, метрика, ключ, порог, восстановление, зависимости и владелец реакции.
Скачать паспорт · TXTПротокол приёмки
Сбор, событие, доставка, принятие, восстановление и регламентное окно.
Скачать протокол · TXTМониторинг с понятной ответственностью
ИТ-аутсорсинг
- Выбор проверок под ваши сервисы.
- Настройка правил и порядка реагирования.
- Диагностика серверов, сети и копирования.
График обслуживания, объём работ и ответственность согласуем отдельно.
Обсудить мониторингОблачные ресурсы
- Размещение сервисов с согласованными ресурсами.
- Проверка доступности и узких мест.
- Согласование копий и восстановления.
Набор проверок и сопровождение фиксируем в условиях конкретного предложения.
Обсудить размещениеЧастые вопросы
Достаточно ли установить агент?
Нет. Нужны пригодные значения, правила, доставка, ответственный и проверенная реакция.
Какой порог CPU поставить всем серверам?
Универсального порога нет. Сначала изучите нормальную нагрузку, длительность пиков и влияние на сервис.
Почему сервер зелёный, а 1С не работает?
Проверка доступности ОС или процесса может не охватывать СУБД, лицензирование, пользовательский путь и конкретную операцию.
Можно автоматически перезапускать сервис?
Только как отдельно согласованную процедуру с условиями, ограничениями и проверкой результата. Общий автоперезапуск по любому событию может ухудшить инцидент.
Что означает nodata?
В заданном интервале нет данных элемента. Причину ищут в узле, проверке и всём пути доставки, а не объявляют сервер выключенным автоматически.
Что проверять после изменения шаблона?
Сбор и ошибки, discovery, макросы, событие, реальную доставку и OK. Также влияние на другие связанные узлы.
Zabbix проверяет восстановление резервной копии?
Не сам по факту установки. Нужна реализованная процедура теста восстановления и передача её результата, если это входит в проект.
Это отчёт о настроенном стенде?
Нет. Материал подготовлен по документации Zabbix7.0 с авторскими учебными схемами и примерами; живой сбор и уведомления при написании не запускались.