
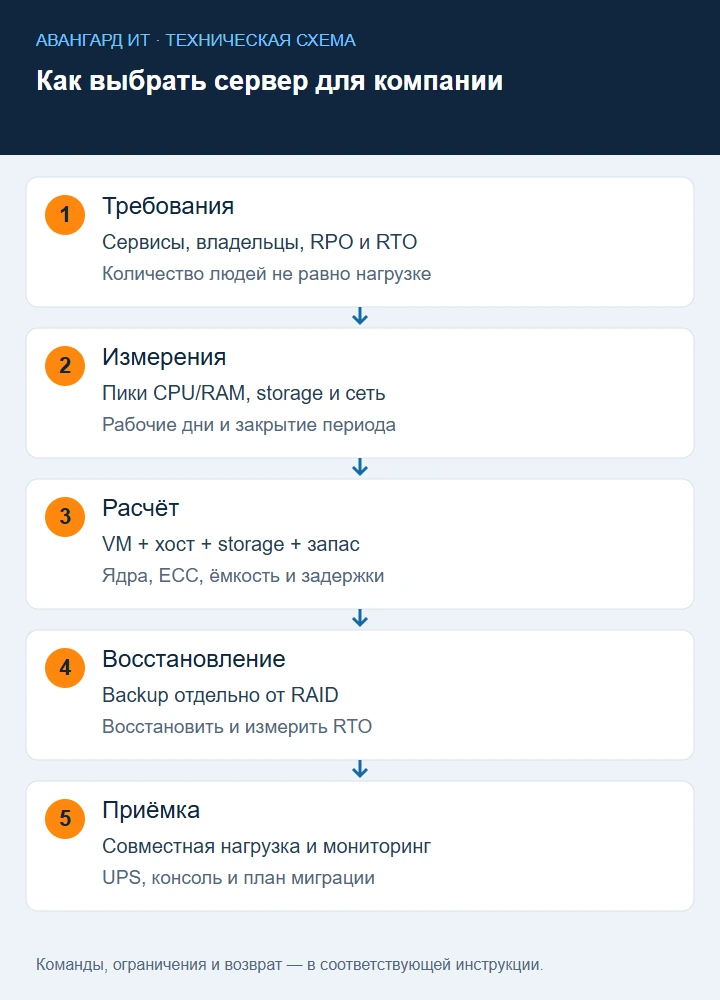
Количество сотрудников само по себе не определяет конфигурацию сервера. Двадцать пользователей файловой папки и двадцать пользователей тяжёлой базы создают разную нагрузку. Выбор нужно начинать со списка сервисов, измерений, требований к восстановлению и бюджета эксплуатации. Эта инструкция помогает администратору составить проверяемое техническое задание, а не купить оборудование по универсальной формуле «столько-то гигабайт на человека».
1. Опишите сервисы и ограничения
Составьте перечень ролей: каталог пользователей, DNS, файлы, база, прикладной сервер, RDS, мониторинг и резервное копирование. Для каждой роли запишите владельца, выпуск ПО, размер данных, количество одновременных пользователей, часы нагрузки и зависимости. Отдельно укажите, какие сервисы можно остановить, а какие нужны постоянно.
Определите RPO — допустимую потерю последних данных, и RTO — допустимое время восстановления. Например, «RPO 1 час, RTO 4 часа» — условное требование для обсуждения с владельцем процесса, а не рекомендация для любой компании. Оно влияет на копирование журналов, доступность резервной площадки, запасное оборудование и проверку восстановления. Производительность одного CPU не решает задачу RTO при отказе единственного корпуса.
2. Измерьте существующую нагрузку
Соберите показатели за рабочие дни, закрытие периода, резервное копирование и другие пики. Нужны загрузка CPU, доступная память, paging, задержки дисков, IOPS, пропускная способность и очередь, сеть, рост базы и отклик приложения. Среднее за сутки может скрыть двадцатиминутный период, когда пользователи не могут работать.
Пример ниже записывает базовые показатели Windows раз в минуту пять часов. Запускайте от согласованного оператора; путь должен быть доступен только администраторам. Это начальная инвентаризация, а не полноценный анализ всех ресурсов.
$Report = 'C:\AdminReports\server-baseline.csv'
New-Item -ItemType Directory -Path (Split-Path $Report) -Force | Out-Null
$culture = [Globalization.CultureInfo]::InvariantCulture
1..300 | ForEach-Object {
    $os = Get-CimInstance Win32_OperatingSystem
    $cpu = Get-CimInstance Win32_Processor
    [pscustomobject]@{
        TimeUtc = [DateTime]::UtcNow.ToString('o')
        CpuLoadPercent = ([double]($cpu | Measure-Object LoadPercentage -Average).Average).ToString('R', $culture)
        TotalRamGiB = [math]::Round($os.TotalVisibleMemorySize / 1MB, 2)
        FreeRamGiB = ([math]::Round($os.FreePhysicalMemory / 1MB, 2)).ToString('R', $culture)
        Processes = $os.NumberOfProcesses
    } | Export-Csv $Report -Append -NoTypeInformation -Encoding UTF8
    Start-Sleep -Seconds 60
}
Память в классе ОС указана в килобайтах, поэтому деление на PowerShell 1MB даёт GiB. Для задержек дисков используйте PerfMon с набором сборщиков данных; названия счётчиков локализованы. В Linux начните с vmstat 1 60, iostat -xz 1 60 при установленном sysstat и метрик приложения. На гипервизоре измеряйте также ожидание CPU и storage, а не только показатели гостевых VM.
Сбор Linux-метрик за конкретное окно. При установленном sysstat сохраните тридцать минут с интервалом десять секунд в заранее созданный закрытый каталог отчётов. Это чтение счётчиков, а не нагрузочный benchmark:
mkdir -p "$HOME/server-baseline"
vmstat -w 10 180 > "$HOME/server-baseline/vmstat.txt" &
iostat -xz -y 10 180 > "$HOME/server-baseline/iostat.txt" &
pidstat -urd -h 10 180 > "$HOME/server-baseline/pidstat.txt" &
wait
Смотрите вместе: CPU us/sy, ожидание wa, swap si/so, задержки r_await/w_await, очередь aqu-sz и процесс, создающий I/O. Первая строка vmstat может отражать усреднение с запуска; не включайте её в расчёт текущего окна. %util=100 на современном многоочередном NVMe сам по себе не доказывает исчерпание производительности. Свяжите пики с временем медленных пользовательских операций и задания backup. Значения и ограничения метрик приведены в руководстве iostat.
3. Согласуйте CPU с характером нагрузки
Частота, поколение, количество ядер и ограничения приложения важнее названия серии процессора. Один долго выполняющийся поток не обязательно ускорится при удвоении количества ядер. Несколько VM, множество сеансов и фоновые задачи требуют совокупной вычислительной мощности, но её нужно проверять в часы совместной нагрузки.
Запишите фактический CPU текущего сервера, пики и профиль приложения. Проверьте требования ОС, гипервизора и прикладного ПО, включая аппаратную виртуализацию и лицензирование. Минимальные требования Windows Server описывают возможность установки, а не подходящую производительность бизнес-приложения. В спецификации указывайте число физических ядер и процессоров; логические потоки и vCPU не являются тем же самым.
4. Рассчитайте память с запасом и отдельными накладными расходами
Сложите рабочие наборы VM, потребности гипервизора, storage и согласованный запас роста. Не суммируйте только текущую свободную память и не рассчитывайте продуктивный сервер на постоянный swap. Для критичной базы memory overcommit требует отдельного обоснования.
Условный пример, не норматив:
VM приложения: 16 GiB
VM базы:       32 GiB
VM каталога:    8 GiB
VM файлов:      8 GiB
Хост/storage:  12 GiB
Итого:         76 GiB
Запас 25%:     95 GiB
Ближайшая конфигурация: 128 GiB после проверки платформы
Проверьте совместимые модули, каналы памяти, поддерживаемую ёмкость и ECC по спецификации выбранного CPU и платы. Требования Proxmox VE отдельно учитывают память ОС, гостей и storage. Ориентир из документации не заменяет измерения конкретного ZFS pool, ARC, VM и режима работы.
После записи CSV вычислите перцентиль по CPU и минимум свободной памяти. Следующий фрагмент использует только собственный baseline, без подключения к серверу:
$rows = Import-Csv 'C:\AdminReports\server-baseline.csv'
$culture = [Globalization.CultureInfo]::InvariantCulture
$cpu = @($rows | ForEach-Object {
    [double]::Parse($_.CpuLoadPercent, $culture)
} | Sort-Object)
if ($cpu.Count -eq 0) { throw 'Empty baseline' }
$index95 = [math]::Max(0, [math]::Ceiling($cpu.Count * 0.95) - 1)
$free = $rows | ForEach-Object {
    [double]::Parse($_.FreeRamGiB, $culture)
}
[pscustomobject]@{
    Samples = $cpu.Count
    CpuP95 = $cpu[$index95]
    MinimumFreeRamGiB = ($free | Measure-Object -Minimum).Minimum
}
Проверьте десятичный разделитель исходного CSV: если значения сформированы в другой культуре, используйте соответствующий parser или изначально сохраняйте invariant-значения. P95 ниже 100% не исключает упора одного потока; исследуйте нагрузку по ядрам и время ответа приложения. Этот расчёт является сводкой измерений, а не автоматическим правилом покупки CPU.
5. Выберите storage по задержке и ресурсу
Рассчитайте полезную ёмкость после RAID или зеркала, свободный запас, рост данных и объём снимков. Отдельно оцените задержку чтения/записи под совместной нагрузкой, ресурс записи SSD, защиту от потери питания, горячую замену и совместимость firmware. Пиковое рекламное последовательное чтение не объясняет поведение базы с мелкими случайными операциями и синхронными записями.
Не располагайте единственную резервную копию на том же массиве. Для ZFS проектируйте прямой доступ к дискам и поддерживаемую схему; не складывайте аппаратный RAID и ZFS автоматически. Для аппаратного RAID проверьте защищённый write cache, батарею или flash-backed cache, мониторинг состояния и сценарий замены контроллера. Проверяйте физические диски и деградацию массива централизованно.
6. Измерьте storage на тестовой машине
Нагрузочный тест выполняется на выделенном стенде или в согласованное окно. Даже тест чтения способен ухудшить отклик рабочих VM. Нельзя подставлять /dev/sda или путь действующей базы вместо тестового файла.
Пример создаёт отдельный файл в заранее выбранном тестовом filesystem, затем измеряет случайное чтение 4 KiB. Сначала проверьте свободное место и убедитесь, что fio-test.bin ещё не существует.
df -h /srv/storage-test
test ! -e /srv/storage-test/fio-test.bin || exit 1
fio --name=prepare --filename=/srv/storage-test/fio-test.bin \
  --size=4G --rw=write --bs=1M --direct=1 --ioengine=libaio --iodepth=1
fio --name=read4k --filename=/srv/storage-test/fio-test.bin \
  --size=4G --rw=randread --bs=4k --direct=1 --ioengine=libaio \
  --iodepth=1 --runtime=60 --time_based --readonly --output-format=json \
  --output=/srv/storage-test/read4k.json
Измерение проверяет конкретный файл, filesystem, storage и глубину очереди. Оно не гарантирует скорость приложения и не проверяет все сценарии записи. Смотрите распределение задержек, включая высокие перцентили, а не только IOPS. Параметры описаны в документации fio. Очистку тестового файла выполняйте только после сохранения результатов и проверки его точного пути.
Для оценки влияния очереди повторите тест того же подготовленного файла при iodepth=8 и сохраните отдельный JSON. Это помогает сравнить задержку при росте параллелизма; не заменяет синхронные записи базы.
fio --name=read4k-q8 --filename=/srv/storage-test/fio-test.bin \
  --size=4G --rw=randread --bs=4k --direct=1 --ioengine=libaio \
  --iodepth=8 --runtime=60 --time_based --readonly --output-format=json \
  --output=/srv/storage-test/read4k-q8.json
Извлеките результаты без ручного просмотра тысяч строк. В JSON fio с clat_ns единица — наносекунда; для миллисекунд делите на миллион:
import json
from pathlib import Path
for name in ['read4k.json', 'read4k-q8.json']:
    data = json.loads((Path('/srv/storage-test') / name).read_text())
    for job in data['jobs']:
        read = job['read']
        latency = read['clat_ns']['percentile']
        print(name, job['jobname'], 'IOPS=', round(read['iops']),
              'P95_ms=', latency.get('95.000000', 0) / 1_000_000,
              'P99_ms=', latency.get('99.000000', 0) / 1_000_000)
Если ваша версия fio использует другой ключ или единицы, проверьте JSON вместо подстановки делителя вслепую. Существенный рост P99 при увеличении очереди указывает на ухудшение отклика в этом режиме; допустимый порог задаётся требованиями приложения. Отдельно испытайте утверждённый профиль записи на стенде, сохранив данные вне рабочей базы.
7. Проверьте сеть, питание и удалённое управление
Сопоставьте сетевую ёмкость с рабочим трафиком, backup и миграцией VM. Быстрые диски не помогут, если резервное копирование ограничено медленным каналом. Выделите управление, пользовательские сервисы и storage по нужной модели сегментации; резервный сетевой порт без резервного коммутатора может не устранить единую точку отказа.
BMC/iDRAC/iLO подключайте в закрытый сегмент, задавайте персональный доступ и обновляйте firmware. Рассчитайте UPS по фактической мощности и требуемому времени работы, проверьте корректное завершение хоста и гостей. Два блока питания дают независимость только при корректной схеме подключений; подключение обоих в одну неисправную розеточную группу не делает питание отказоустойчивым.
8. Спроектируйте резервные копии и восстановление
RAID помогает пережить определённый отказ диска, но не удаление базы, шифрование, пожар или ошибку администратора. Определите объекты backup, частоту, хранение, отдельную площадку и защиту от изменения или удаления с продуктивной учётной записи. Для базы нужен согласованный метод обеспечения консистентности.
Проверьте полное восстановление сервиса на отдельной машине: загрузку VM, базу, доступ приложения и права пользователей. Измерьте фактическое время, сравните с RTO и зафиксируйте последнюю восстановленную точку относительно RPO. Успешный статус задания без теста восстановления не подтверждает пригодность копии. Не забудьте конфигурации гипервизора, сети, лицензии и доступ к ключам шифрования.
Проверка RPO/RTO на уровне сервиса. Создайте в согласованной тестовой базе или приложении контрольную запись с UTC-временем T0, дождитесь плановой копии и восстановите её в изолированную сеть. Запишите T1 — начало восстановления и T2 — успешное завершение бизнес-сценария. RTO проверяется как T2−T1, а возраст последней доступной контрольной точки сравнивается с требуемым RPO. Загрузка VM сама по себе не является T2.
Для файлового сервиса можно подтвердить целостность контролируемого набора:
Get-FileHash -Algorithm SHA256 -LiteralPath 'D:\RestoreTest\control-file.bin'Сравните с сохранённым до backup хешем. Затем проверьте права доступа под тестовым пользователем, а не только из административного сеанса. Для базы используйте штатную проверку и рабочий запрос приложения; одинаковый хеш файла активной базы не является универсальным критерием её корректности.
9. Составьте спецификацию и план роста
В техническое задание внесите ресурсы, модель storage, полезную ёмкость, ресурс SSD, сетевые порты, удалённое управление, гарантию и заменяемые компоненты. Укажите допустимые остановки, схему резервирования, поддержку ОС и приложений, стоимость лицензий и backup. Совместимость проверяется по спискам производителя и вендоров ПО.
Запас роста должен иметь конкретную границу: свободные слоты памяти, дисковые корзины, CPU и сеть. «Можно добавить позже» не работает, если платформа уже достигла предела или нужные модули недоступны. Отдельно сравните владение локальным сервером, аренду и облачную инфраструктуру по одинаковым требованиям к восстановлению и доступу, включая каналы и поддержку.
10. Выполните приёмку до переноса сервисов
Проверьте hardware diagnostics, firmware, память, storage, мониторинг, UPS и удалённую консоль. Затем выполните типовую нагрузку приложения, совместную работу VM, backup в рабочее окно и восстановление. Отказ диска или питания имитируйте только по поддерживаемой процедуре и на подготовленном стенде.
Сохраните базовые показатели нового сервера и критерии возврата миграции. До переключения подготовьте окно, проверенную копию и способ вернуть сервисы с учётом новых данных; обратное включение старой базы без согласования может создать расхождение. Сервер считается выбранным успешно, когда подтверждены отклик, вместимость и восстановление нужных сервисов, а не когда он просто прошёл POST и включился.
Связанные инструкции: как правильно понимать MTBF, правила информационной безопасности компании. В протоколе приёмки укажите исходное и новое измерение: workload, число одновременных сессий, окно, CPU P95, минимальную свободную память, storage P99 и время бизнес-операции. Например, «95% открытий карточки ≤2 с при 25 тестовых сеансах, backup не увеличивает P99 выше согласованного предела» — проверяемая форма требования, но сами цифры должны быть согласованы с владельцем. Без описания нагрузки результат benchmark нельзя сравнить с другим сервером.