
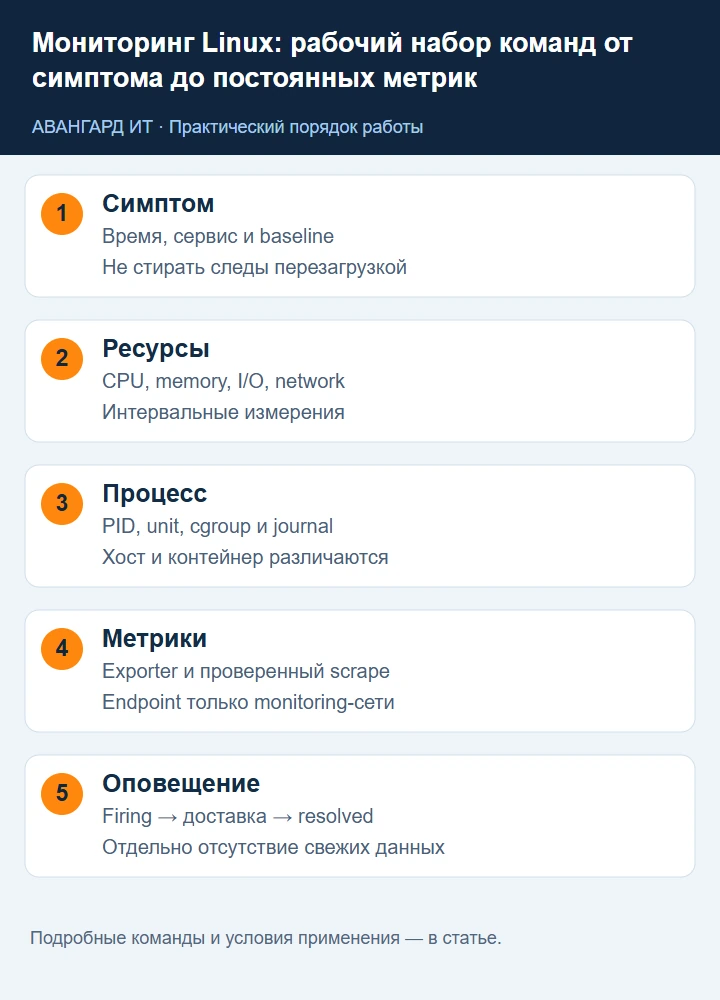
Перечень из восьмидесяти программ не помогает понять, почему приложение стало медленным. Администратору нужен порядок: зафиксировать время и симптом, посмотреть нагрузку системы, локализовать ресурс, найти процесс и проверить результат изменения. Эта статья заменяет старую коллекцию инструментов практическим набором для Debian/Ubuntu с systemd. Для других дистрибутивов меняется установка пакетов, но смысл измерений сохраняется. Команды читают состояние; установка агента и изменение конфигурации мониторинга выполняются отдельно в согласованное окно.
Сначала записывайте часовой пояс, uptime, release и время начала жалобы. Без общей временной шкалы нельзя сопоставить журнал приложения, storage и сеть. Не перезагружайте сервер до сбора минимальных данных: после рестарта часть следов исчезнет.
1. Собрать базовый снимок и установить диагностические инструменты
date -Is
timedatectl status
uptime
cat /etc/os-release
uname -r
ip -br address
systemctl --failed --no-pager
sudo apt update
sudo apt install sysstat procps iproute2 lsof curl
В production сначала изучите план APT; диагностические пакеты не должны неожиданно менять критичные зависимости. sysstat содержит mpstat, pidstat, iostat и sar. top, free и vmstat — procps, ss — iproute2. Официальный проект sysstat. Если нет root, начните доступными чтениями и укажите ограничения: отсутствие прав может скрыть процессы или журналы.
Сохранение output в файл полезно, но путь должен быть на файловой системе с достаточным местом. Полный journal и lsof могут содержать пользовательские имена и пути; перед передачей клиенту или поставщику удалите ненужные данные и секреты.
2. Разобрать CPU, load average и отдельные ядра
Load average отражает runnable и часть задач в непрерываемом ожидании, поэтому высокая load не равна только высокой загрузке CPU. Сравните число процессоров, отдельные ядра, user/system/iowait и steal. Средние 20% по серверу могут скрывать один полностью занятый поток.
nproc
mpstat -P ALL 1 10
vmstat 1 10
ps -eo pid,ppid,stat,pcpu,pmem,comm --sort=-pcpu | head -n 20
pidstat -u -p 1234 1 10
Первый vmstat отчёт обычно усреднён с запуска: оценивайте последующие. В VM steal показывает время, когда виртуальный CPU не исполнялся из-за гипервизора; причина может быть за пределами гостевой ОС. Состояние D требует проверки ожидаемого ресурса, а не автоматического kill. При высоком system ищите syscall/network/storage work; при высоком user — функцию приложения. Решение «добавить vCPU» проверяется нагрузкой и лицензированием, а не назначается по одному скриншоту top.
3. Проверить память, swap и OOM
Linux использует память под cache, поэтому малая free не обязательно означает нехватку. Для первичной оценки полезнее available вместе со swap-in/out и memory pressure. Наличие занятого swap само по себе не доказывает текущий thrashing: страницы могли попасть туда давно.
free -h
vmstat 1 10
cat /proc/meminfo
cat /proc/pressure/memory
sudo journalctl -k --since '-2 hours' --no-pager | grep -Ei 'oom|out of memory|killed process'
ps -eo pid,rss,vsz,comm --sort=-rss | head -n 20
RSS процессов нельзя безоговорочно сложить и назвать физическим потреблением: общие страницы могут быть учтены несколько раз. При OOM в контейнере хост может иметь свободную память, а cgroup уже достиг limit. Установите, что было убито, какой limit применялся и когда. Добавление swap не возвращает завершённую транзакцию; после восстановления сервисов нужен анализ причины роста и тест под пиковой нагрузкой.
4. Проверить I/O, заполнение и inode
findmnt -T /var/lib
df -hT
df -i
iostat -xz -y 1 10
pidstat -d 1 10
cat /proc/pressure/io
sudo journalctl -k --since '-2 hours' --no-pager | grep -Ei 'I/O error|timeout|reset|read-only'
await включает очередь и обслуживание, aqu-sz показывает среднюю очередь. %util на многоканальном NVMe не является универсальным процентом исчерпанной ёмкости. Разделяйте перегрузку и аппаратные ошибки: один случай требует контроля workload, другой — плана сохранения данных и замены. При свободных гигабайтах и исчерпанных inode массовое создание файлов завершится ошибкой. Если df и du сильно отличаются, ищите открытые удалённые файлы, mountpoints и reserved blocks, а не удаляйте неизвестные каталоги. Подробная процедура — в статье о диагностике дисков.
5. Локализовать сетевую проблему
Сначала маршрут, интерфейс и порт; затем DNS и приложение. Ping может работать, когда TCP блокируется. Успешное TCP-соединение, в свою очередь, не доказывает корректный HTTP-ответ. В контейнере и namespace смотрите тот контекст, где работает сервис.
ip -s link
ip route
ip route get 192.0.2.10
ss -lntup
ss -s
getent ahosts example.com
curl --connect-timeout 5 --max-time 10 -I https://example.com/
192.0.2.10 — адрес документационного диапазона; замените на реальный согласованный target. Растущие drops/errors сопоставьте с switch port, driver и нагрузкой. Не обнуляйте firewall, чтобы «проверить быстро»: добавьте ограниченное временное разрешение по процедуре и уберите его после теста. Curl выводит HTTP status и headers; для health-check используйте endpoint, который отражает зависимые компоненты, а не просто всегда возвращает 200.
6. Сопоставить службу, PID и журнал
systemctl status nginx --no-pager
systemctl show nginx -p MainPID -p ActiveState -p SubState -p NRestarts
journalctl -u nginx --since '2026-10-11 09:00:00' --until '2026-10-11 09:15:00' --no-pager
systemctl cat nginx
nginx и время — примеры. Status active сообщает о процессе, но не о корректности запросов. Смотрите конфигурацию unit и drop-ins, чтобы понимать реальный запуск. Повторные restart могут маскировать crash loop. Если журнал пуст, проверьте выбранный boot, retention и stdout/stderr приложения; это не доказательство отсутствия ошибок.
Перед reload проверьте конфигурацию штатным валидатором приложения; для nginx это nginx -t. При fail сначала исправьте ошибку и только затем reload. journalctl в Debian. Самостоятельное удаление журналов во время расследования уничтожает временную шкалу.
7. Использовать PSI и cgroup, когда средние показатели скрывают проблему
PSI оценивает время задержки задач из-за нехватки ресурса. some означает, что задерживалась хотя бы часть задач; full для памяти/I/O — что одновременно задерживались все non-idle задачи. avg10/60/300 — доли времени в соответствующих окнах, total — накопленное время в микросекундах. Это другой показатель, чем проценты использования CPU.
cat /proc/pressure/cpu
cat /proc/pressure/memory
cat /proc/pressure/io
systemctl show nginx -p ControlGroup
# Путь заменить значением ControlGroup нужной службы
cat /sys/fs/cgroup/system.slice/nginx.service/memory.current
cat /sys/fs/cgroup/system.slice/nginx.service/memory.events
cat /sys/fs/cgroup/system.slice/nginx.service/cpu.stat
Пример предполагает cgroup v2 и указанную структуру systemd; проверьте mount и реальный путь. memory.events oom/oom_kill показывают события ограничения cgroup, cpu.stat throttled — ограничение CPU при соответствующем контроллере. Отсутствие файла — причина проверить поддержку, а не записать нулевое значение. PSI ядра Linux и cgroup v2.
8. Добавить node_exporter и проверить scrape
Для Debian/Ubuntu используйте штатный пакет, если его версия и политика обслуживания подходят проекту. Доступ к TCP 9100 ограничьте monitoring-сегментом средствами существующего firewall. Не публикуйте exporter в Internet. Перед установкой сохраните план изменения и убедитесь, что collector не раскрывает лишние сведения.
sudo apt install prometheus-node-exporter
systemctl status prometheus-node-exporter --no-pager
ss -lntp | grep ':9100'
curl --fail --connect-timeout 3 --max-time 10 http://127.0.0.1:9100/metrics | head -n 20
Если в вашем проекте уже используется активный UFW с запретом входящих по умолчанию, конкретное разрешение только monitoring-серверу 10.10.10.5 выглядит так. Не включайте UFW удалённо без проверки текущих правил и сохранённого административного доступа:
sudo ufw status numbered
sudo ufw allow from 10.10.10.5 to any port 9100 proto tcp comment 'node-exporter-monitoring'
sudo ufw status numbered
Проверьте TCP 9100 с разрешённого и с другого тестового адреса: доступ должен отличаться. Существующее широкое allow 9100 нужно отдельно ограничить по согласованной процедуре; новое узкое правило не отменяет старое. Для nftables/firewalld используется действующая политика проекта, без добавления параллельного firewall.
На monitoring-сервере добавьте отдельный job в существующий prometheus.yml, не заменяя остальные scrape_configs:
scrape_configs:
  - job_name: linux-nodes
    scrape_interval: 30s
    static_configs:
      - targets: ['10.10.10.15:9100']
        labels:
          environment: lab
Затем promtool check config с фактическим путём конфигурации и штатный reload по процедуре проекта. В Targets должен появиться UP; ошибка timeout отличается от connection refused и неверного HTTP path. node_exporter и конфигурация Prometheus.
9. Настроить полезные alerts и проверять свежесть
Тревога должна иметь владельца, время реакции и действие. Отдельно контролируйте недоступность scrape; отсутствие свежих метрик нельзя считать нормальным состоянием. Ниже — минимальное правило, которое добавляется в rules file, уже подключённый через rule_files. Оно не создаёт канал уведомлений: Alertmanager и маршрутизация настраиваются отдельно.
groups:
  - name: linux-availability
    rules:
      - alert: LinuxNodeUnavailable
        expr: up{job="linux-nodes"} == 0
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: 'Недоступен exporter {{ $labels.instance }}'
          description: 'Проверить хост, TCP 9100, exporter и monitoring path.'
promtool check config /etc/prometheus/prometheus.yml
promtool check rules /etc/prometheus/rules/linux.ymlФактические пути зависят от развёртывания. В лаборатории остановите только тестовый exporter, дождитесь firing и проверьте доставку, затем запустите его и убедитесь в resolved. Контроль отсутствующего target требует отдельной absent/инвентаризационной проверки: удалённый job уже не даст up=0. Правила оповещения Prometheus.
10. Оформить расследование и проверить исправление
Зафиксируйте симптом пользователя, временное окно, сравнение с нормальным состоянием, host/VM/container, CPU, память, I/O, сеть и приложение. Выдвигайте проверяемую гипотезу: «задержка совпадает с I/O pressure и backup job», а не «Linux тормозит». Одновременно меняйте один фактор и сохраняйте исходную конфигурацию.
После исправления повторите исходную нагрузку, сравните latency/errors/pressure и проверьте приложение. Reload/restart сам по себе не является критерием решения. Для агента возврат — восстановить прежнюю конфигурацию и удалить только добавленный monitoring job/пакет по согласованному плану; не выключать весь monitoring stack. Для ресурса возврат зависит от конкретного изменения и должен быть подготовлен заранее. Передача в сопровождение включает dashboard, alert route, инструкции проверки и подтверждённое восстановление сервисов после отказа.
Нужно организовать мониторинг Linux-систем?
Полезный мониторинг связывает метрики с порогами, уведомлениями, ответственными и действиями при отклонениях.