PostgreSQL можно использовать как СУБД для клиент-серверной 1С. Но установка первого пакета из репозитория и копирование чужого конфига не дают готовую рабочую систему. Нужно выбрать совместимую сборку, проверить доступ с сервера 1С и принять результат на своих операциях и восстановлении.
Ниже — подробное руководство: от паспорта сервера и установки до памяти, WAL, autovacuum, тяжёлых запросов и восстановления на выбранное время. Примеры команд используют Linux и синтаксис PostgreSQL 16; точную ОС, сборку и релиз платформы выбирают по матрице поддержки. Это не отчёт об испытании конкретного стенда и не универсальный установщик для всех поставщиков.
Выбрать сборку, а не только номер PostgreSQL
1С публикует PostgreSQL с собственными патчами. Также существуют поставки других разработчиков. Совпадение основной версии, например 16, ещё не означает одинаковые пакеты, настройки и поддержку.
| Вариант | Где проверять | Важное различие |
|---|---|---|
| PostgreSQL с патчем 1С | Портал обновлений и документация фирмы 1С | Выбирают сборку для своей ОС и архитектуры, сверяют релиз платформы |
| Сборки PostgreSQL для 1С от Postgres Professional | Официальная страница сборок | Это не автоматически коммерческий Postgres Pro; отдельно проверяют условия использования и поддержки |
| Postgres Pro, Tantor и другие продукты | Перечень СУБД 1С и документация производителя | Поддерживается конкретный продукт и версия. Наличие названия в общем списке не заменяет проверку всей связки |
Запишите полные версии платформы, конфигурации, СУБД, ОС и архитектуру, источник пакетов и способ обновления. Отдельно сверяют ОС для выбранной СУБД. Не следует брать самый новый основной выпуск только потому, что он уже вышел.
Бесплатная сборка тоже имеет условия. Например, на странице Postgres Professional отдельно указаны ограничения для DBaaS и интеграции в собственные продукты, а также отсутствие поддержки у бесплатного предложения. Аренда ВМ и предоставление СУБД как услуги — разные сценарии, их проверяют до расчёта проекта.
Сам выбор PostgreSQL не означает автоматической необходимости КОРП. Уровень лицензий 1С определяют архитектура и используемая функциональность. При этом в описании 8.5.4 отдельная оптимизация под высокой нагрузкой и большим числом временных таблиц заявлена именно для КОРП; это учитывают при сравнении, а не обещают одинаковые возможности всех лицензий.
Спланировать размещение и хранение
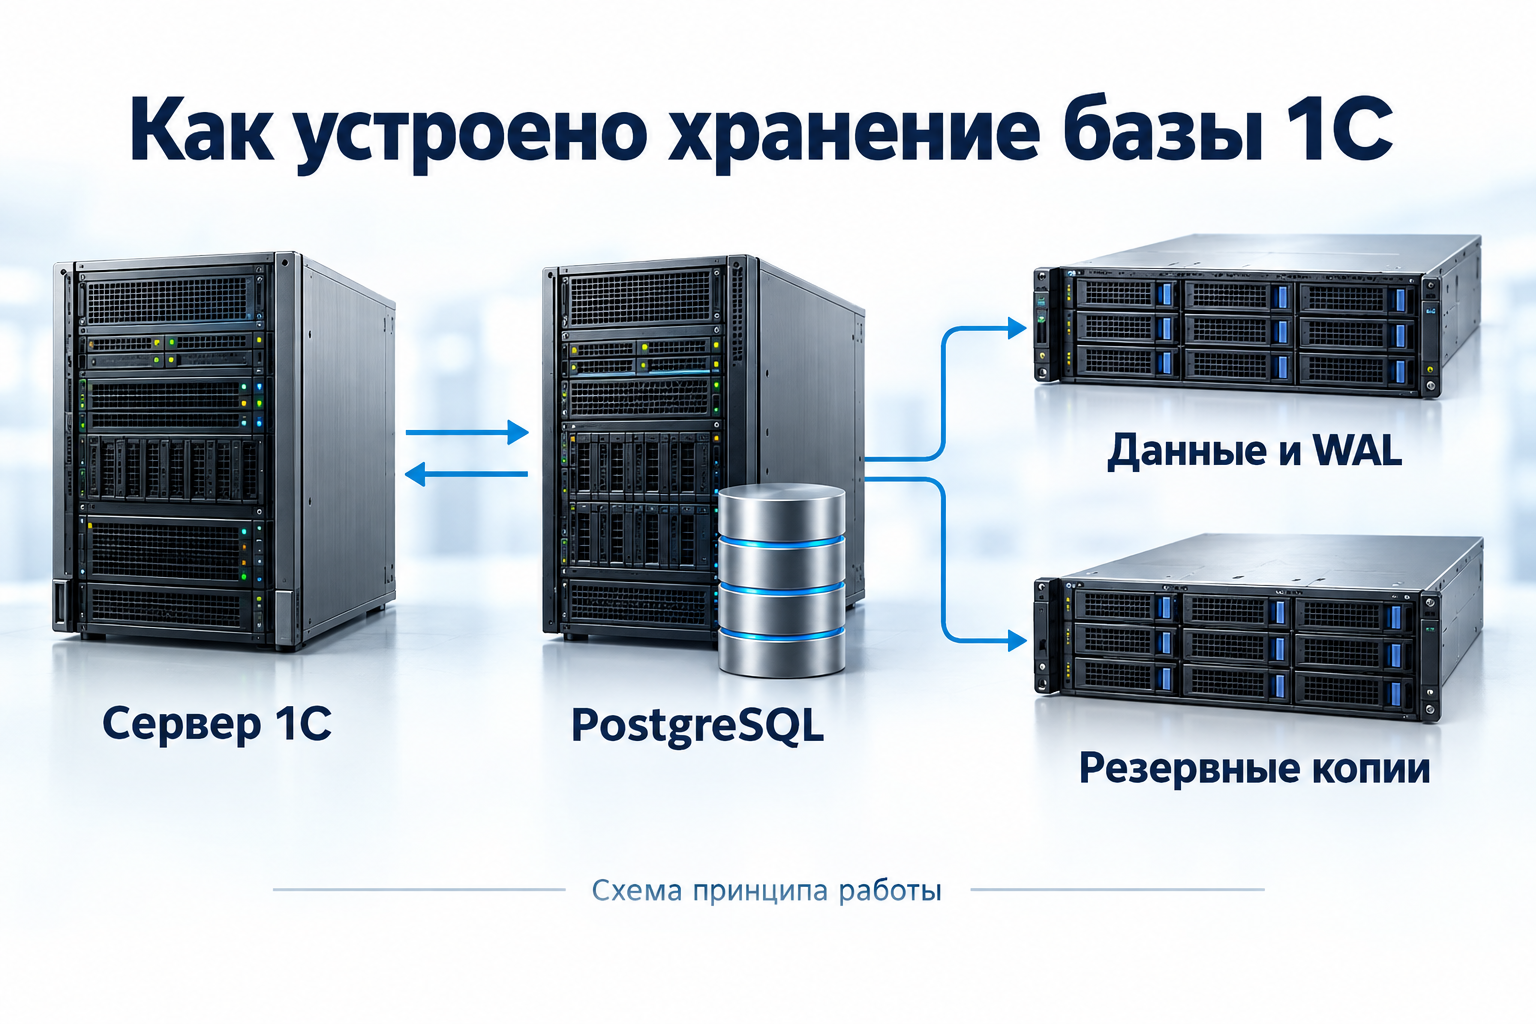
Сервер 1С выполняет прикладной код, PostgreSQL обслуживает запросы и хранит данные. Они могут находиться на одной машине или на разных узлах. Для совместного размещения память и CPU считают на оба сервиса; отдельный сервер добавляет сетевую зависимость.
- Хранение: объём базы, индексы, WAL, временные файлы, рост и запас свободного места.
- Надёжность: устойчивость записи, состояние дисков, питание и контроллер; RAID не заменяет копии.
- Сеть: задержки, пропускная способность, имена и доступ с рабочих серверов 1С.
- Копии: отдельный расчёт ёмкости, хранения вне рабочего узла и проверки восстановления.
Исходные данные: какой сервер мы настраиваем
Чтобы числа в конфиге имели смысл, разберём учебный профиль: выделенная Linux-машина СУБД, 16 доступных CPU, 64 ГиБ RAM, SSD/NVMe, сервер 1С на другом узле. Основная версия PostgreSQL — 16, но конкретную поставку выбирают по требованиям 1С. Это исходные данные примера, а не результат проведённого нами нагрузочного испытания.
Полные версии 1С, СУБД, ОС и обязательные расширения поставки.
Память, подключения, место под WAL и временные файлы.
Документы, отчёты, фоновые задания и восстановление.
Перед установкой соберите сведения об ОС и дисках. Команды ниже читают состояние; набор доступных утилит зависит от дистрибутива.
cat /etc/os-release
lscpu
free -h
lsblk -o NAME,SIZE,TYPE,FSTYPE,MOUNTPOINTS
df -hT
findmnt- В виртуальной машине: проверьте лимит RAM, гарантии CPU, NUMA и конкуренцию за хранилище. Число vCPU само по себе не описывает скорость процессора.
- На одном узле с 1С: сначала вычтите память rphost, веб-сервера и других служб. Профиль на 64 ГиБ ниже для такого размещения без пересчёта не годится.
- Для хранения: отдельно учтите размер базы, ежедневный прирост, временные файлы крупных отчётов и WAL при недоступном архиве. Свободные 20% — лишь организационный ориентир, не гарантия достаточной ёмкости.
В паспорте фиксируют не только «1С тормозит», а конкретные операции: проведение документа, закрытие месяца, отчёт за год. Для каждой — объём данных, число одновременно работающих пользователей и приемлемое время. Параметры СУБД проверяют на этом наборе, а не на пустой базе.
Установить согласованные пакеты
Начинают на новом или выделенном тестовом узле. Пакеты получают у выбранного поставщика, проверяют подписи или опубликованные контрольные суммы и зависимости. Не смешивают сервер одного продукта с утилитами другого только из-за одинакового номера версии.
Для Debian-подобной ОС установка заранее проверенных локальных DEB-пакетов может выглядеть так. В каталоге должны находиться только пакеты выбранной поставки, а не случайный набор загрузок:
# Каталог заранее проверенных пакетов для этой ОС и архитектуры
cd /srv/staging/pg1c-approved
ls -1 ./*.deb
# После сверки списка и инструкции поставщика
sudo apt install ./*.deb
Это пример работы с локальными пакетами, не название конкретной сборки. У поставки с собственным репозиторием или установщиком выполняют её официальную инструкцию. Имя пакета, службы и каталог данных зависят от продукта. Не подставляйте автоматически apt install postgresql: так можно получить другую сборку.
Некоторые установщики сразу создают кластер PostgreSQL и запускают службу. Другие требуют отдельной инициализации. После установки сначала выясняют, что уже создано, чтобы не получить два экземпляра и подключиться к неправильному порту.
После установки: проверить бинарники, службу и права
Найдите именно ту службу, которую создала поставка. У Debian с postgresql-common, у RPM-пакетов и у коммерческих сборок разные соглашения об именах. Поэтому сначала смотрим список, затем открываем описание найденной службы.
systemctl list-unit-files --type=service | grep -Ei 'postgres|tantor'
command -v psql
psql --version
# PG_SERVICE — точное имя найденной службы, не postgres по умолчанию
systemctl cat "$PG_SERVICE"
systemctl status "$PG_SERVICE" --no-pager
journalctl -u "$PG_SERVICE" -n 80 --no-pager
Переменную PG_SERVICE задайте по результату списка и инструкции поставщика. В unit-файле проверьте путь к бинарникам, учётную запись, аргументы запуска и EnvironmentFile. Каталог данных определяют по фактическому экземпляру, а не угадывают по названию пакета.
Служба не должна работать от root. У владельца процесса должен быть доступ к данным, конфигам, сертификатам и журналам. При SELinux/AppArmor ошибку доступа устраняют корректными политиками и метками, а не выключением защиты всей ОС. После перезагрузки узла экземпляр должен стартовать с теми же портом и каталогом.
Не выполняйте повторный initdb, если установщик уже создал кластер. Для нового пустого каталога используйте утилиту и процедуру именно выбранной поставки. До инициализации определите UTF-8, локаль и провайдер сортировки по её требованиям; универсальная замена на en_US или ru_RU без проверки здесь неуместна.
Проверить каталог данных, локаль и экземпляр
Кластер PostgreSQL — набор баз в одном экземпляре СУБД. Это не то же самое, что кластер серверов 1С. Его инициализация создаёт служебные структуры, выбирает кодировку и локаль. Команду initdb не используют как «ремонт» существующей базы.
Локаль, провайдер сортировки и кодировка должны соответствовать требованиям выбранной сборки и платформы. Их фиксируют до создания рабочих баз; смена параметров после загрузки данных не всегда сводится к редактированию конфига.
Подключитесь к фактическому экземпляру от имени уполномоченного администратора. Дальнейшие SQL-примеры выполняются в psql или другом SQL-клиенте, а не в командной оболочке:
SELECT version(), current_database(), current_user;
SHOW port;
SHOW data_directory;
SHOW config_file;
SHOW hba_file;
SELECT datname, pg_encoding_to_char(encoding) AS encoding,
       datcollate, datctype
FROM pg_database ORDER BY datname;
Путь и порт должны совпасть с проектом. Версия утилиты psql показывает версию клиента, а результат SELECT version() — подключённого сервера. Доступ к служебным сведениям зависит от прав роли.
Настроить доступ именно для сервера 1С
Различайте пользователя ОС, роль PostgreSQL и пользователя информационной базы 1С. Это три разных уровня. Роль СУБД и необходимые ей права создают по инструкции выбранной сборки и релиза: требования для создания базы и повседневной работы могут различаться.
Не следует ни безусловно выдавать SUPERUSER всем приложениям, ни обещать, что одна универсальная роль с минимальным набором прав подойдёт каждой версии 1С. Отдельно проверяют создание базы, обновление конфигурации и регламентные операции.
Доступ состоит из адреса прослушивания, сетевых правил и pg_hba.conf. Пример ниже — строка для уже созданной тестовой базы и роли. Адрес из диапазона документации нужно заменить на IP рабочего сервера 1С:
# TYPE    DATABASE   USER   ADDRESS          METHOD
# Пример: TLS уже настроен и проверен у обеих сторон
hostssl   onec_test  onec   192.0.2.10/32    scram-sha-256
Правила читаются сверху вниз: применяется первое совпавшее, а не «самое подходящее». hostssl требует настроенного SSL; пример не создаёт сертификаты и не подтверждает поддержку нужного режима у вашего клиента. Для создания новых баз может требоваться отдельный согласованный доступ к служебной базе — приведённая строка его не даёт.
Не открывают СУБД всему интернету ради устранения ошибки соединения. Проверяют узкий маршрут от нужного сервера, роль, пароль, сертификаты и реальный адрес источника.
Адрес прослушивания, TLS и фактические соединения 1С
Для нашего примера адрес сервера СУБД — 192.0.2.20, сервера 1С — 192.0.2.10. Это адреса документации, их заменяют на реальные. Пример фрагмента postgresql.conf ограничивает прослушивание loopback и выделенным адресом. Каталог сертификатов предварительно готовит администратор.
listen_addresses = '127.0.0.1,192.0.2.20'
port = 5432
ssl = on
ssl_cert_file = '/etc/pg1c/tls/server.crt'
ssl_key_file = '/etc/pg1c/tls/server.key'
password_encryption = 'scram-sha-256'
Файл ключа защищают правами, допустимыми PostgreSQL, и дают доступ службе. Включение SCRAM не меняет уже сохранённые пароли: после проверки совместимости клиентов их переустанавливают поддерживаемым способом, например интерактивной командой psql \password onec. Не записывайте пароль в статью, историю shell или команду запуска.
Для libpq/psql следующий тест проверяет и шифрование, и доверие к сертификату, и имя сервера. DNS-имя должно соответствовать сертификату; файл CA — реальной цепочке доверия.
psql "host=pg1c.example.internal port=5432 dbname=onec_test user=onec sslmode=verify-full sslrootcert=/etc/pg1c/tls/ca.crt" -WЭтот параметр подключения psql нельзя механически перенести в поля администрирования 1С. Способ включения TLS у платформы и её библиотек сверяют для конкретного релиза. Затем в PostgreSQL проверяют уже соединения приложения, сопоставив IP и пользователя:
SELECT a.pid, a.usename, a.datname, a.client_addr,
       a.application_name, s.ssl, s.version, s.cipher
FROM pg_stat_activity AS a
LEFT JOIN pg_stat_ssl AS s USING (pid)
WHERE a.client_addr = '192.0.2.10'::inet;
Отдельно проверьте firewall и маршрут с каждого рабочего сервера 1С, а не только с компьютера администратора. Базу для создания ИБ и рабочую базу разрешают отдельными обоснованными HBA-правилами. Не расширяют пример до all all 0.0.0.0/0 trust. Поведение режимов проверки сертификата описано в документации libpq TLS.
Проверить подключение, затем создать базу через 1С
С машины, с которой будет подключаться сервер 1С, проверяют фактический адрес и порт PostgreSQL. Полный пример ниже предназначен для среды, где тестовая ИБ onec_test уже создана средствами 1С, роль настроена и разрешён её доступ. До создания базы можно выполнить только проверку готовности pg_isready:
# Адреса и имена замените на реальные; пароль не пишите в строке
pg_isready -h 192.0.2.20 -p 5432
psql "host=192.0.2.20 port=5432 dbname=onec_test user=onec sslmode=require" \
  -W -c "SELECT current_database(), current_user;"
pg_isready показывает готовность принимать соединения. Он не доказывает правильность пароля и прав приложения; поэтому нужен отдельный вход и SQL-запрос. sslmode=require запрашивает шифрование, но не является полной проверкой имени сервера, как корректно настроенный verify-full.
В администрировании 1С задают PostgreSQL, реальный адрес СУБД, имя тестовой базы и согласованную роль. Новую информационную базу создают поддерживаемым способом средствами 1С; пустая база из произвольного SQL-скрипта не заменяет её структуру и настройки.
Проверяют вход из клиента, проведение документа, отчёт и фоновые задания. Успешный psql не подтверждает работу именно процессов 1С. При необходимости смотрят фактические подключения в PostgreSQL и журнал платформы.
Настроить память без универсального конфига
| Параметр | За что отвечает | Типичная ошибка |
|---|---|---|
| shared_buffers | Буферный кеш PostgreSQL | Отдать почти всю RAM и оставить без памяти ОС и 1С |
| work_mem | Бюджет отдельных операций сортировки и подобных операций; для хешей есть дополнительные условия | Считать его одним лимитом на сервер или на соединение |
| maintenance_work_mem | Память для определённых операций обслуживания | Не учитывать параллельное обслуживание и отдельные параметры autovacuum |
| effective_cache_size | Оценка доступного кеша для планировщика | Считать её заранее выделенной памятью |
| max_connections | Максимум подключений к СУБД | Приравнивать его числу пользователей 1С и увеличивать без расчёта ресурсов |
Простой пример: 20 одновременно выполняющихся запросов, по две активные сортировки с бюджетом 16 МиБ — уже 640 МиБ только на эти операции. Хеширование, параллельные работники и остальная память добавляются отдельно. Это иллюстрация расчёта, не верхняя граница расхода сервера.
Значения выбирают по документации памяти PostgreSQL и измеренной нагрузке. В некоторых новых поставках есть первоначальный автоматический подбор параметров; такая возможность описана и в новостях 1С 8.5.4. Сначала фиксируют фактические настройки, затем проверяют их на своей системе.
Пример конфигурации памяти: сервер с 64 ГиБ
Допустим, на сопоставимой тестовой нагрузке наблюдали пик 120 подключений СУБД. Для примера закладываем 150 с резервом, но это не 150 пользователей 1С. Один сеанс 1С и одно соединение PostgreSQL не связаны правилом «один к одному».
Ниже стартовая гипотеза для выделенной СУБД, которую проверяют на копии. Фрагмент дополняет обязательные настройки поставщика и не заменяет весь postgresql.conf:
# Учебный профиль: отдельная СУБД, 64 GiB RAM, 16 CPU
max_connections = 150
shared_buffers = '16GB'
effective_cache_size = '48GB'
work_mem = '16MB'
hash_mem_multiplier = 2.0
maintenance_work_mem = '1GB'
autovacuum_work_mem = '256MB'
autovacuum_max_workers = 4
В параметрах памяти PostgreSQL единицы GB/MB двоичные: здесь 16GB — 16 ГиБ. effective_cache_size не прибавляют к выделенной памяти: это оценка кеша для планировщика. А work_mem может расходоваться несколькими узлами одного плана и несколькими процессами.
Проверяем бюджет, а не только процент shared_buffers
Для условной нагрузки 30 одновременно активных запросов, каждый с двумя одновременно работающими хеш-узлами, иллюстративный бюджет: 30 × 2 × 16 МиБ × 2 = 1920 МиБ. Четыре autovacuum-процесса с отдельным лимитом 256 МиБ дают ещё до 1024 МиБ соответствующей памяти. Это частичный расчёт выбранных компонентов, не общий максимум PostgreSQL.
Добавляются backend-процессы, другие узлы планов, параллельные работники, обслуживание, расширения и ОС. Если вы подняли work_mem до 256MB, та же модель уже даёт 30 ГиБ только для указанных хешей. Поэтому повышение «для одного большого отчёта» на всём сервере может закончиться OOM при одновременном запуске нескольких задач.
- При нехватке памяти сначала выясняют конкурентность и планы, затем меняют лимиты.
- Если одному отчёту нужен другой бюджет, испытывают настройку в ограниченном сеансе, не назначают её всем соединениям автоматически.
- Встроенный пул соединений 1С и внешний PgBouncer — разные механизмы. Совместимость режимов внешнего пула, временных таблиц и сеансовых настроек требует отдельного испытания.
Сравнивайте RAM, swap и OOM-события в пик, во время обновления конфигурации и тяжёлого обслуживания. Отсутствие swap в одном коротком замере не подтверждает правильность бюджета на месяц эксплуатации.
Сохранить надёжность записи и обслуживание
WAL — журнал упреждающей записи, необходимый для восстановления после сбоя и, при соответствующей настройке, для репликации и возврата к моменту времени. Это не то же самое, что журнал регистрации 1С.
Не отключают fsync и full_page_writes ради красивого теста скорости рабочей базы. О последствиях изменения параметров пишет документация PostgreSQL. Размеры WAL и частоту контрольных точек выбирают по потоку записи, возможностям дисков и схеме копирования.
Autovacuum и обновление статистики нужны для нормальной работы. Отключение обслуживания может сначала ускорить отдельный замер, а затем привести к росту таблиц и ухудшению планов запросов. Наблюдают длительные транзакции, блокировки, накопление мёртвых строк и свободное место; не запускают тяжёлое обслуживание вслепую в рабочие часы.
WAL и контрольные точки: как настроить без потери надёжности
Для учебного SSD-сервера можно начать проверку со следующего фрагмента. Размер WAL подбирают затем по измеренному потоку записи и запасу диска; 8 ГиБ не являются универсальным лимитом.
wal_level = replica
fsync = on
full_page_writes = on
synchronous_commit = on
min_wal_size = '2GB'
max_wal_size = '8GB'
checkpoint_timeout = '10min'
checkpoint_completion_target = 0.9
Например, если нагрузка создаёт около 2 ГиБ WAL в минуту, объём 8 ГиБ достигается приблизительно за четыре минуты. Это арифметическая оценка для разбора частых контрольных точек, а не точный прогноз момента их запуска. Проверьте журнал checkpoint и прирост счётчиков за одинаковые интервалы.
max_wal_size — мягкий ориентир для контрольных точек, а не предохранитель от заполнения диска. Неудачная архивация и удерживающие WAL слоты могут увеличить каталог pg_wal сверх него. Нельзя удалять файлы из pg_wal вручную ради освобождения места: устраняют причину и восстанавливают нормальное управление журналом.
Проверьте настройки и накопленные показатели именно PostgreSQL 16:
SELECT now(), wal_bytes, wal_records, wal_fpi, stats_reset
FROM pg_stat_wal;
SELECT now(), checkpoints_timed, checkpoints_req,
       checkpoint_write_time, checkpoint_sync_time, stats_reset
FROM pg_stat_bgwriter;
Снимите значения до и после рабочего интервала; разность wal_bytes делят на его длительность. После сброса статистики разности между разными периодами бессмысленны. В PostgreSQL 17 статистика контрольных точек вынесена в другое представление — запрос не надо переносить между версиями без сверки.
Разносить WAL и данные имеет смысл при наличии действительно независимых ресурсов записи. Два раздела одного перегруженного массива не создают два независимых диска. Проверяйте задержку синхронной записи, гарантии кэша контроллера и питания. Обещание «NVMe всегда решает проблему» не заменяет измерение.
Планировщик, параллелизм и JIT: что не стоит включать вслепую
Сначала сохраните фактические значения и обязательные рекомендации производителя сборки. Не отключайте целиком методы соединения таблиц ради одного запроса. Это может улучшить один отчёт и ухудшить сотню других.
SHOW random_page_cost;
SHOW seq_page_cost;
SHOW effective_io_concurrency;
SHOW max_worker_processes;
SHOW max_parallel_workers;
SHOW max_parallel_workers_per_gather;
SHOW jit;
SHOW shared_preload_libraries;
Уменьшать random_page_cost для SSD следует по сравнению планов и времени, а не только по типу накопителя. Большое effective_io_concurrency имеет смысл лишь при способности стека хранения обслужить соответствующую конкурентность. ВМ с NVMe внутри медленного общего хранилища может не соответствовать ожиданиям от локального диска.
Для 16 CPU в примере можно отдельно испытать max_parallel_workers = 4 и max_parallel_workers_per_gather = 2, проверив достаточный общий max_worker_processes и потребности расширений. Это ограничивает определённые параллельные задачи, но не означает, что все остальные процессы сервера ограничены четырьмя CPU. Память работников учитывают дополнительно.
JIT способен добавлять стоимость компиляции коротким запросам и помогать другой нагрузке. Сравнивайте оба режима на одинаковых данных. Для отдельного доверенного SELECT на изолированной копии можно использовать транзакционный SET LOCAL; по завершении настройка не остаётся постоянной:
BEGIN;
SET LOCAL jit = off;
SET LOCAL work_mem = '32MB';
-- Здесь выполняют выбранный безопасный SELECT и фиксируют время/план
ROLLBACK;
Такой тест через psql не меняет параметры всех подключений 1С. Для проверки самой платформы требуется отдельный сценарий с её реальными соединениями. Параметры и различия планов описаны в разделе планирования запросов.
Autovacuum и ANALYZE: обслуживать, а не «оптимизировать отключением»
UPDATE и DELETE оставляют версии строк, которые не всегда можно сразу убрать. Обычный VACUUM подготавливает место для повторного использования, ANALYZE обновляет статистику для планировщика. Нужны оба процесса. Это также часть защиты от переполнения счётчиков транзакций, а не косметическая уборка.
Первичная настройка для примера сохраняет обслуживание включённым. Четыре работника и 256MB на работника уже учтены в примере памяти; стоимость фонового ввода-вывода затем проверяют на своей нагрузке.
autovacuum = on
track_counts = on
autovacuum_max_workers = 4
autovacuum_work_mem = '256MB'
autovacuum_naptime = '1min'
log_autovacuum_min_duration = '1s'
Для обычного порога по обновлённым/удалённым строкам используется идея threshold + scale_factor × оценка числа строк. При 10 млн строк, threshold 50 и коэффициенте 0,2 это примерно 2 000 050 изменений; при 0,02 — 200 050. В PostgreSQL 16 есть и отдельные условия для вставок и предотвращения wraparound: показанная формула не описывает все причины запуска.
Сначала найдите таблицы с накоплением версий и редким обслуживанием. Оценки строк не являются точным COUNT(*).
SELECT schemaname, relname, n_live_tup, n_dead_tup,
       last_autovacuum, last_autoanalyze,
       autovacuum_count, autoanalyze_count
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC LIMIT 20;

SELECT datname, age(datfrozenxid) AS xid_age
FROM pg_database ORDER BY xid_age DESC;
Если большая изменяемая таблица стабильно обслуживается слишком поздно, обсуждают отдельные пороги для неё, а не обязательно для всех баз. Изменение reloptions физических таблиц 1С согласуют с разработчиком и поставщиком поддержки и испытывают на копии: реструктуризация может менять объекты. Не копируйте выдуманное имя _InfoRg из чужого примера.
- Растут мёртвые строки: ищите долгие транзакции, нагрузку обслуживания и удерживающие xmin репликационные слоты.
- Планы резко ошибаются по числу строк: проверяйте актуальность ANALYZE и распределение данных.
- VACUUM не возвращает файл ОС: это само по себе не ошибка, место может повторно использоваться внутри таблицы.
- VACUUM FULL — переписывание с сильной блокировкой и потребностью в дополнительном месте; это отдельная операция с окном, а не ежедневная команда «ускорить 1С».
Контролируйте возраст транзакций по порогам выбранной версии и своему запасу времени на исправление. Подробности: обслуживание таблиц и параметры autovacuum.
Проверить и применить изменения
Перед правками сохраняют конфигурационные файлы и исходные значения. В PostgreSQL 16 полезно сверить параметры и ошибки правил доступа такими запросами:
SELECT name, setting, unit, source, context, pending_restart
FROM pg_settings
WHERE name IN ('shared_buffers','work_mem','max_connections',
               'fsync','full_page_writes','listen_addresses');

SELECT line_number, type, database, user_name, address, auth_method, error
FROM pg_hba_file_rules ORDER BY line_number;
Доступ к представлению правил может требовать административных полномочий. После проверки изменений конфигурацию перечитывают в согласованное время:
SELECT pg_reload_conf();Ответ true означает отправку сигнала перечитывания, а не доказательство применения каждого значения. Проверяют журнал, source и pending_restart. Параметры уровня запуска, включая shared_buffers и listen_addresses, требуют перезапуска экземпляра. Его выполняют по плану с проверенной копией и проверкой 1С после старта.
Как убедиться, что отредактирован именно действующий конфиг
В системе могут одновременно действовать postgresql.conf, include-файлы, postgresql.auto.conf, параметры службы и настройки роли или базы. Записать строку в первый найденный файл недостаточно. Сначала сохраните действующие файлы, настройки и инструкции поставщика; секреты из бэкапа конфигурации защищают так же, как оригинал.
SELECT name, setting, unit, context, source,
       sourcefile, sourceline, pending_restart
FROM pg_settings
WHERE name IN ('shared_buffers','work_mem','max_connections',
 'max_wal_size','autovacuum_max_workers','logging_collector',
 'shared_preload_libraries') ORDER BY name;

SELECT sourcefile, sourceline, name, setting, applied, error
FROM pg_file_settings
WHERE error IS NOT NULL;

SELECT d.datname, r.rolname, s.setconfig
FROM pg_db_role_setting AS s
LEFT JOIN pg_database AS d ON d.oid = s.setdatabase
LEFT JOIN pg_roles AS r ON r.oid = s.setrole;
Проверка файлов выявляет ошибки текущего содержимого, но не доказывает применение работающими процессами. После исправления ошибок выполните reload для допускающих его параметров и снова сравните pg_settings. Настройки роли/базы и некоторые сеансовые значения проверяйте в новом подключении приложения.
- shared_buffers, max_connections, autovacuum_max_workers, logging_collector, shared_preload_libraries: в PostgreSQL 16 требуют перезапуска экземпляра.
- work_mem, effective_cache_size, checkpoint_timeout, max_wal_size: имеют другие контексты применения; проверяют pg_settings и отсутствие перекрывающей настройки.
- ALTER SYSTEM: пишет postgresql.auto.conf и может перекрывать основной файл. Выберите единый способ управления, а не поддерживайте несколько противоречащих конфигов.
Не перезапускайте безымянный «postgresql вообще»: остановится ли нужный экземпляр, зависит от пакета и unit-файлов. После согласованного рестарта проверьте службу, SQL-вход, отсутствие pending_restart у изменённых параметров и операции 1С. Документация: pg_settings, pg_file_settings.
Журналы: найти медленный запрос и связать его с операцией 1С
Логи нужны до инцидента. Для PostgreSQL 16 пример диагностического профиля ниже предполагает подготовленный каталог журнала. У поставки с журналированием через systemd схема может быть другой. logging_collector включают с перезапуском.
logging_collector = on
log_destination = 'stderr'
log_directory = 'log'
log_filename = 'postgresql-%Y-%m-%d_%H%M%S.log'
log_rotation_age = '1d'
log_rotation_size = '100MB'
log_truncate_on_rotation = off
log_line_prefix = '%m [%p] db=%d,user=%u,app=%a,client=%h '
log_min_duration_statement = '1000ms'
log_lock_waits = on
deadlock_timeout = '1s'
log_checkpoints = on
log_temp_files = '64MB'
Порог 1000 мс — пример начального отбора для диагностического окна. Если поток огромен, уточните охват и место. deadlock_timeout здесь влияет в том числе на момент сообщения об ожидании блокировки; это не приказ прервать любой запрос через секунду. log_temp_files позволяет замечать крупные временные файлы, а не ограничивает их размер.
Ротация не равна хранению за N дней. Очистку и передачу журналов на отдельный узел настраивают отдельно. Проверьте, куда реально пишет экземпляр:
SHOW log_timezone;
SELECT pg_current_logfile();
SELECT now(), pg_postmaster_start_time();
При выключенном сборщике pg_current_logfile может вернуть NULL. Синхронизируйте время СУБД, сервера 1С и системы мониторинга. Для жалобы «проведение зависло в 14:07» нужны точный интервал, ИБ, операция, сервер/процесс 1С и PID СУБД. SQL-текст и параметры могут содержать данные организации, поэтому доступ к журналам ограничивают.
Не включайте постоянный log_statement=all ради надежды найти всё: сначала выберите окно, задачу и объём. Параметры подробно разобраны в документации журналирования.
pg_stat_statements: найти запросы, которые съедают время
Расширение агрегирует статистику похожих запросов. Сначала проверьте, доступно ли оно у выбранной поставки и что уже предзагружается. Роль диагностики должна иметь согласованные права на просмотр чужих запросов; SUPERUSER ради ежедневного мониторинга не выдают автоматически.
SELECT name, default_version, installed_version
FROM pg_available_extensions WHERE name = 'pg_stat_statements';
SHOW shared_preload_libraries;
SHOW compute_query_id;
Для обычного PostgreSQL 16 библиотеку pg_stat_statements добавляют к существующему shared_preload_libraries, сохраняя обязательные библиотеки поставщика, затем перезапускают СУБД. При compute_query_id=auto модуль может использовать идентификаторы запросов. После этого уполномоченный администратор создаёт расширение в базе, из которой будут читать представление:
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;

SELECT queryid, calls,
       round(total_exec_time::numeric, 1) AS total_ms,
       round(mean_exec_time::numeric, 1) AS mean_ms,
       rows, shared_blks_read, temp_blks_written,
       left(query, 300) AS query_sample
FROM pg_stat_statements
WHERE dbid = (SELECT oid FROM pg_database
              WHERE datname = current_database())
ORDER BY total_exec_time DESC LIMIT 15;
Сортировка по суммарному времени помогает найти массовую нагрузку: 100 тысяч коротких вызовов могут занимать больше ресурсов, чем один долгий отчёт. Сортировка по среднему времени отвечает другому вопросу; учитывайте число вызовов и длительность наблюдения. Это агрегаты, не история каждого запуска и не готовый план выполнения.
Сравнивайте снимки статистики за одинаковые интервалы и проверяйте момент сброса/вытеснение записей. Не обнуляйте общие счётчики рабочей системы без согласования с мониторингом. Перед передачей примера запроса наружу удалите чувствительные данные.
Если SQL оказался дорогим, сопоставьте его с технологическим журналом 1С и прикладной операцией. Сам запрос ещё не доказывает, что проблема в сервере или в разработчике. Подключение расширения и поля статистики: официальная инструкция pg_stat_statements.
Активные сеансы и блокировки: кто ждёт и кого
Проверку выполняют во время проблемной операции. Запрос ниже показывает длительность транзакции, состояние, ожидание и список блокирующих PID. В PostgreSQL чужой SQL и часть деталей видны только при достаточных правах.
SELECT pid, usename, datname, client_addr, application_name,
       state, wait_event_type, wait_event,
       now() - xact_start AS xact_age,
       now() - query_start AS query_age,
       pg_blocking_pids(pid) AS blockers,
       left(query, 240) AS query_sample
FROM pg_stat_activity
WHERE datname = current_database() AND pid <> pg_backend_pid()
ORDER BY xact_start NULLS LAST;
query_age у неактивного backend не означает, что он всё это время выполняет запрос. Смотрите state. «idle in transaction» — открытая транзакция без текущего SQL; она может удерживать блокировки и мешать очистке. wait_event_type=Lock указывает ожидание блокировки, а не нехватку CPU.
Постройте пары ожидающий → блокирующий, чтобы не отключить пострадавшую сессию вместо источника:
SELECT w.pid AS waiting_pid, b.pid AS blocking_pid,
       w.wait_event_type, w.wait_event,
       b.state AS blocker_state,
       now() - b.xact_start AS blocker_xact_age,
       left(w.query, 160) AS waiting_query,
       left(b.query, 160) AS blocking_query
FROM pg_stat_activity AS w
CROSS JOIN LATERAL unnest(pg_blocking_pids(w.pid)) AS x(blocking_pid)
JOIN pg_stat_activity AS b ON b.pid = x.blocking_pid;
Прикладной пример: отчёт ждёт транзакцию, открывшую изменение регистра и не завершившую его. Добавление RAM не сократит это ожидание. Сначала выясняют, какая операция удерживает транзакцию, почему она долгая и можно ли её штатно закончить. Увеличение timeout лишь продлит ожидание.
pg_cancel_backend отменяет текущий запрос; pg_terminate_backend разрывает сессию. Это разные воздействия с последствиями для незавершённой работы и отката. Не запускают массовое завершение по возрасту PID. Согласуют конкретную сессию, сохраняют диагностику, проверяют последствия в 1С. Зависания и взаимоблокировки дополнительно сопоставляют с механизмами блокировок платформы.
Описание состояний и ожиданий: pg_stat_activity.
Планы запросов: отделить плохой план от слабого диска
Первый EXPLAIN без ANALYZE показывает оценённый план; EXPLAIN ANALYZE действительно выполняет запрос. Для тяжёлого запроса используйте изолированную копию и данные сопоставимого объёма. Даже SELECT может вызывать функции с побочными эффектами — проверяйте сам текст.
Ниже шаблон, а не готовый запрос к внутренним таблицам 1С: вместо комментария вставляют предварительно проверенный SELECT. Для первой проверки добавляют ограниченное время выполнения.
BEGIN;
SET LOCAL statement_timeout = '60s';
-- EXPLAIN (ANALYZE, BUFFERS, SETTINGS, FORMAT TEXT)
-- SELECT ... ; -- ваш проверенный запрос на тестовой копии
ROLLBACK;- estimated rows против actual rows: сильное расхождение направляет к статистике, селективности и параметрам запроса.
- loops: узел может быть быстрым в одном проходе, но вызываться десятки тысяч раз.
- Sort Method / Disk: выгрузка сортировки на диск — повод оценить объём и конкурентность, а не сразу поднимать work_mem всем.
- Buffers: чтения и попадания в кеш интерпретируют вместе со временем и состоянием кеша. Высокий hit ratio не гарантирует быстрых операций.
Сравнивайте одинаковые параметры, версии, статистику и прогрев. Первый запуск после восстановления и повторный запуск из кеша нельзя выдавать за честное «до и после». Один пример реального запроса полезнее десятка общих советов про быстрый SSD.
Не создавайте индексы напрямую в физических таблицах 1С без проекта изменений с разработчиком: нужно учитывать метаданные, обновления и поддержку. Ошибку запросов исправляют на уровне поддерживаемого прикладного решения, а не скрытой ручной правкой схемы. Основы чтения: EXPLAIN в PostgreSQL.
Диагностика дисков, CPU и временных файлов
SQL-статистику сопоставляют с ОС и гипервизором за один интервал. В Linux при установленных sysstat/procps пригодятся следующие команды. Смотрите несколько последовательных срезов, не только первый накопленный отчёт.
vmstat 1 10
iostat -xz 1 10
pidstat -dru 1 10
df -hT
df -i
CPU занят полезной работой или ожиданием? Растут задержки записи или очередь? Есть swap-in/swap-out? Закончилось место либо inode? В виртуальной среде добавьте метрики хоста и общей СХД. Один показатель %util у NVMe или RAID не описывает все ограничения многоканального устройства.
Для PostgreSQL 16 полезно получить распределение I/O и временные данные по базам. Счётчики накопленные, а не мгновенные скорости:
SELECT backend_type, object, context, reads, writes,
       read_time, write_time, op_bytes
FROM pg_stat_io
ORDER BY backend_type, object, context;

SELECT datname, temp_files, temp_bytes, deadlocks,
       blk_read_time, blk_write_time, stats_reset
FROM pg_stat_database
WHERE datname = current_database();
Значения времени требуют соответствующего включения сбора: для обычного I/O — track_io_timing; накладные расходы проверяют на платформе. Нули не всегда означают отсутствие задержек. Детали сбора: настройки статистики.
Отчёт стал медленным после роста базы
Снимите план и временные файлы отчёта, проверьте актуальность статистики и задержки дисков. Если доминируют блокировки — разбирают транзакции. Если вырос объём сортировок — сначала проверяют выборку и план, затем локальный бюджет памяти. Покупка CPU до этого разбора может ничего не изменить.
Проверить резервную копию восстановлением
PostgreSQL различает логические копии, файловые подходы и непрерывное архивирование. Для небольшой тестовой базы можно начать с логического формата; для рабочего RPO/RTO может понадобиться базовая копия вместе с непрерывной цепочкой WAL.
# Пример: доступ и каталог назначения уже согласованы
pg_dump -h 192.0.2.20 -p 5432 -U backup_role -W \
  -Fc -f ./onec_test.dump onec_test
pg_restore --list ./onec_test.dump

# Только в заранее подготовленную отдельную пустую тестовую базу
pg_restore --exit-on-error -h 192.0.2.30 -p 5432 -U restore_role -W \
  --dbname=onec_restore_check ./onec_test.dump
Имена ролей условные: необходимые права и владельцы должны быть подготовлены. pg_restore --list показывает состав архива, но не проверяет полноценное восстановление. После загрузки подключают изолированную 1С и проверяют контрольные данные. Роли PostgreSQL, настройки сервера и внешние файлы учитывают отдельно — один pg_dump их все не сохраняет.
Физические копии и PITR: вернуться к моменту до ошибки
pg_dump полезен для логической копии, но сам по себе не даёт непрерывный возврат на произвольный момент. Для PITR нужны базовая физическая копия и непрерывная цепочка WAL до нужной точки. Реплика тоже не заменяет историческую копию: ошибочное удаление может быстро попасть на неё.
Один из инструментов — pgBackRest. Перед использованием проверяют поддержку точной сборки PostgreSQL выбранной версией инструмента; совместимость коммерческой поставки не следует из одного слова PostgreSQL. Инструмент устанавливают по его инструкции. Ниже учебная схема, не законченный регламент для любой инфраструктуры.
1. Подготовить репозиторий и отдельную stanza
Stanza — именованный набор конфигурации и копий одного кластера. В примере фактический PGDATA — /srv/pg1c/data, а /backup/pgbackrest — предварительно подключённое независимое хранилище. Если /backup окажется обычным каталогом на рабочем диске, независимой защиты не получится. Доступ, шифрование, лимиты и мониторинг монтирования готовят заранее.
# Фрагмент /etc/pgbackrest/pgbackrest.conf
[global]
repo1-path=/backup/pgbackrest
repo1-retention-full-type=count
repo1-retention-full=2
log-level-console=info

[onec]
pg1-path=/srv/pg1c/data
pg1-port=5432
Хранить две полные копии — только демонстрационная политика, не согласованный срок восстановления. Реальные сроки, инкременты, архив WAL и независимую вторую копию рассчитывают по RPO/RTO и защите от удаления. Права на репозиторий должны соответствовать выбранной схеме запуска; ниже предполагается служебная учётная запись postgres и готовое локальное подключение.
2. Включить архивацию и проверить первую копию
# Фрагмент postgresql.conf, путь к pgbackrest проверен
wal_level = replica
archive_mode = on
archive_command = 'pgbackrest --stanza=onec archive-push %p'
Изменение archive_mode требует перезапуска. Пакет и команда должны быть доступны самой службе, а не только интерактивному пользователю. После настройки и согласованного старта:
sudo -u postgres pgbackrest --stanza=onec stanza-create
sudo -u postgres pgbackrest --stanza=onec check
sudo -u postgres pgbackrest --stanza=onec --type=full backup
sudo -u postgres pgbackrest --stanza=onec info
Проверяйте результат команд и журнал, не только наличие каталога. Настройте расписание, уведомления об ошибках, контроль свежести и свободного места. pgBackRest управляет зависимостями копий; ручное удаление отдельных WAL из репозитория ломает цепочку.
3. Провести возврат на изолированном узле
Допустим, ошибочная операция началась 28 октября в 14:05 +07:00, а проверяемая цель — 14:04:59. Убедитесь, что до неё есть базовая копия и весь WAL. Восстановление ниже выполняют только на отдельном узле: совместимые бинарники, остановленный экземпляр, пустой каталог /srv/pg1c-restore, проверенные пути tablespace и доступ к репозиторию без возможности случайно менять рабочую систему.
# ТОЛЬКО отдельный тестовый узел и пустой PGDATA
sudo -u postgres pgbackrest --stanza=onec \
  --pg1-path=/srv/pg1c-restore \
  --type=time --target='2026-10-28 14:04:59+07' \
  --target-action=pause restore
Команда возвращает файлы, но не запускает и не принимает восстановленный сервис. До старта отдельно настройте тестовую службу, порт, адреса прослушивания, конфиги вне PGDATA и пути tablespace. Отключите исходящие интеграции и доступ рабочих клиентов. Пустой каталог и остановленный сервис — условия безопасности примера; режим delta для рабочего каталога здесь не используется.
После запуска совместимого PostgreSQL проверьте достижение цели по журналу и состояние восстановления:
SELECT pg_is_in_recovery(), pg_is_wal_replay_paused();При hot_standby=on и достигнутой цели pause ожидается режим восстановления с паузой воспроизведения. Сама пауза ещё не доказательство нужной точки: сверяют журнал и контрольные данные SQL. Для проверки через 1С с записью отдельно принимают решение о завершении восстановления на тестовом узле; до этого тестовая копия может быть только для чтения.
Результат учения: выбранный документ есть, ошибочной операции ещё нет, суммы проверены, известны длительность возврата и границы данных. При восстановлении всего физического кластера возвращаются его базы совместно — это отличается от pg_restore одной базы. Руководства: принцип PITR, настройка pgBackRest, опции restore.
Что передать в мониторинг после запуска
- Доступность: служба, порт и отдельный аутентифицированный SQL-тест. Проверка только TCP не подтверждает выполнение запросов.
- Ресурсы: RAM, swap, CPU, задержки дисков, ёмкость и inode для данных, pg_wal, временных файлов и журналов.
- Сеансы: использование max_connections, долгие транзакции, idle in transaction, цепочки блокировок и ошибки подключения.
- Обслуживание: autovacuum/analyze, возраст xid, рост таблиц, temp_bytes и ошибки в журнале.
- Копии: последний успешный backup, доступность репозитория, ошибки/отставание архива WAL, дата последнего успешного теста восстановления.
Проверьте архиватор и слоты, если они используются:
SELECT archived_count, failed_count,
       last_archived_time, last_failed_time, stats_reset
FROM pg_stat_archiver;

SELECT slot_name, slot_type, active, restart_lsn,
       confirmed_flush_lsn
FROM pg_replication_slots;
Пустой список слотов — нормален, если они не нужны проекту. Неактивный слот нельзя просто удалить: выясняют потребителя и последствия для репликации. Возраст последней архивации при почти пустой базе сам по себе не доказывает отказ: учитывайте поток WAL и политику переключения сегментов.
У каждого сигнала должен быть ответственный и действие. «Свободно меньше X» полезно, если запас обеспечивает время реакции при вашем темпе роста. Пример: рост 20 ГиБ в час и свободные 40 ГиБ требуют более срочной реакции, чем те же 40 ГиБ при росте 1 ГиБ в сутки.
Три частые проблемы и порядок разбора
«Соединение запрещено»
Уточняют сервер, порт, реальный IP источника, адрес прослушивания и первое совпадающее HBA-правило. Затем проверяют роль, пароль и TLS. Не начинают с trust и разрешения всей сети.
«После настройки стало медленнее»
Сравнивают исходные значения, планы запросов, нагрузку, память и диски. Одно изменение — один проверяемый результат. Недостаток памяти из-за завышенного work_mem может выглядеть как проблема дисков.
«База работает, но обновление конфигурации падает»
Проверяют версии, зависимости, права и журнал ошибки на копии. Права для обычных операций и изменения структуры могут отличаться. Проверка запуска приложения не заменяет испытание обновления.
Изменения и обновления: порядок, который можно откатить
- Снять исходное состояние. Версии, конфиги, размеры, нагрузка, планы важных запросов, статистика и время операций.
- Подготовить копию. Сопоставимые данные и ресурсы, закрытые внешние интеграции, проверенная возможность восстановления.
- Сформулировать гипотезу. Например: отчёт уходит во временные файлы; проверяем локальный work_mem и план. Не меняем десять несвязанных параметров сразу.
- Провести измерение. Несколько повторов, одинаковая конкурентность и состояние кеша, учёт ошибок. Смотрим не только среднее, но и медленные выполнения.
- Применить с окном. Согласовать перезапуск и остановку заданий, сохранить прошлые значения и критерий отката.
- Проверить после запуска. Реальные соединения 1С, документы, отчёты, фоновые задания, мониторинг и новую копию.
Минорное обновление внутри основной версии и переход, например, 15 → 16 — разные процедуры. При смене основной версии нельзя просто подключить старый PGDATA к новым бинарникам. Выбирают поддерживаемый поставщиком путь: pg_upgrade с проверками либо перенос через логическую копию; отдельно учитывают расширения, локали и совместимость 1С.
Откат приложения, конфигурационных файлов и данных — тоже разные действия. Сохранённый postgresql.conf не отменяет структурное обновление ИБ. До начала перехода определяют, где находится пригодная копия, сколько времени займёт восстановление и какие новые записи будут потеряны при возврате.
Тюнинг не заканчивается приёмкой: закрытие месяца, массовая загрузка и обновление конфигурации меняют профиль. В паспорте оставляют дату, причину и эффект каждого изменения, чтобы следующий администратор понимал, почему выбрано именно это значение.
Когда систему можно считать готовой
- Совместимая связка версий и источник пакетов записаны; подключение идёт к нужному экземпляру.
- Проверены документы, отчёты, фоновые задания, обновление и реальные соединения 1С.
- Под согласованной нагрузкой выполнены требования ко времени, нет необъяснённых ошибок и нехватки ресурсов.
- Работают мониторинг, копирование и восстановление; известны ответственные и порядок возврата настроек.
Синтетический тест дополняет, но не заменяет бизнес-операции. Если меняют SQL Server на PostgreSQL, переход сравнивают на одинаковых данных и отдельно проверяют планы, расширения и перенос. Подробности диагностики — в статье «Почему тормозит 1С».
Паспорт установки и приёмка
Паспорт PostgreSQL для 1С
Версии, пакеты, пути, порт, роли, память, хранение и порядок обновления.
Скачать паспорт · TXTПриёмка СУБД
Подключение 1С, функции, нагрузка, безопасность, копия и восстановление.
Скачать памятку · TXTРазвернуть и сопровождать СУБД
ИТ-аутсорсинг: управляемая эксплуатация
- Согласовать версии и зависимости.
- Проверить настройки, доступы и нагрузку.
- Организовать мониторинг и восстановление.
Изменения конфигурации 1С и оптимизация прикладного кода включаются в отдельный согласованный объём.
Обсудить сопровождениеОблачные ресурсы: площадка под нагрузку
- Рассчитать CPU, память, диски и сеть.
- Предусмотреть копии и тестовую среду.
- Сверить лицензии и обязанности сторон.
Аренда ВМ и управляемая СУБД — разные услуги. Состав, стоимость и допустимость выбранной поставки уточняются.
Рассчитать ресурсыВопросы о PostgreSQL для 1С
Подойдёт обычный PostgreSQL из репозитория ОС?
Его нельзя считать подходящим без проверки. Нужны поддерживаемые продукт, версия и сборка для конкретной платформы 1С.
PostgreSQL и Postgres Pro — одно название?
Нет. Различаются продукты, сборки, функции, условия поставки и поддержка. Сравнивают точную редакцию, а не только слово Postgres.
Можно взять готовый конфиг с другого сервера?
Только как материал для анализа. Память, соединения, хранение и нагрузка могут отличаться. Каждый параметр нужно обосновать и проверить.
Нужна ли постоянно роль SUPERUSER?
Это зависит от сборки, релиза и операции. Проверяют требования производителя отдельно для создания базы, работы и обновления; универсальное назначение или отзыв прав недопустимы без проверки.
pg_isready подтвердил, что 1С будет работать?
Нет. Он проверяет состояние приёма соединений, а не права и бизнес-операции 1С. Нужны фактическое подключение приложения и испытания.
Файл дампа уже означает наличие проверенной копии?
Нет. Нужны сохранность, учёт зависимостей и успешное восстановление с проверкой данных. Просмотр оглавления дампа этого не заменяет.