
Сервер для 1С выбирают по времени выполнения операций и пиковой нагрузке. Количество сотрудников помогает описать задачу, но не заменяет замеры. Двадцать пользователей с тяжёлыми обменами и закрытием месяца могут предъявлять более высокие требования, чем большая группа сотрудников, которые в основном открывают справочники.
В этом руководстве — порядок выбора процессора, памяти, SSD, RAID и платформы, пример расчёта и готовые формы для технического задания. Цифры в примере условные: это методика, а не обещание производительности любой конфигурации. Документация проверена 6 ноября 2026 года.
Как читать: начните с сценариев вашей конфигурации, затем выберите схему размещения. Для существующей медленной системы сначала пройдите диагностику узких мест; расчёты компонентов и калькулятор — дальше по содержанию.
Сначала нагрузка, затем комплектация
Проведение документов, отчёты, обмены и закрытие месяца в час пик.
Процессор, рабочие данные в памяти, задержка записи и ёмкость хранения.
Одинаковая база, реальные сценарии, согласованные времена и восстановление.
Минимальные аппаратные требования 1С описывают базовые условия запуска. Они не являются спецификацией производственного сервера под вашу нагрузку. Сначала определите: файловая база или клиент-сервер, где работают клиентские сеансы, сколько баз, какие фоновые задания идут одновременно.
Какие исходные данные собрать за рабочую неделю
- Прикладная система: конфигурация, её версия, доработки и расширения, версия платформы, ОС и СУБД.
- Реальная параллельность: активные сеансы в пике, фоновые задания, интеграции, регламентные расчёты.
- Объём: данные и индексы отдельно от журналов, временных файлов и резервных копий; прирост за месяц.
- Время операций: проведение типового и тяжёлого документа, отчёт, обмен, закрытие периода.
- Ресурсы: загрузка отдельных ядер, память процессов, подкачка, задержки и объём записи на диски.
- Требования бизнеса: допустимый простой, потеря данных, срок эксплуатации и план роста.
Неделя обычной работы не заменяет закрытие квартала. Если такого периода в наблюдении не было, включите его в нагрузочное испытание. Запишите размер тестовой базы и сценарий: результат без этих условий трудно сопоставить с коммерческим предложением.
Бухгалтерия, ЗУП, УТ, УНФ и ERP: разные сценарии подбора
Название конфигурации — начало разговора, а не готовая спецификация. В одной компании работает типовая база, в другой — множество расширений, обменов и собственных отчётов. Ниже приведены примеры испытаний для функций, которые действительно используются у вас, а не универсальные нормативы ресурсов.
Бухгалтерия
Проверить: закрытие месяца, перепроведение документов выбранного периода, оборотно-сальдовую ведомость и используемые обмены.
Для выбора: оценить время последовательных участков, нагрузку СУБД и запись во время закрытия. Быстрый обычный день не доказывает, что квартал закроется в допустимое окно.
ЗУП
Проверить: расчёт зарплаты на реальном числе сотрудников, перерасчёты, отчётность и обмен с бухгалтерией.
Для выбора: учитывать объём расчётной задачи и историю данных. Десять расчётчиков на большое предприятие не равны десяти лёгким клиентским сеансам.
Управление торговлей
Проверить: проведение заказов и реализаций, складские операции, массовые загрузки, расчёты себестоимости — если они задействованы в вашей системе.
Для выбора: испытать параллельное проведение и обмены. Если документы ждут одну блокировку, дополнительные ядра могут не увеличить пропускную способность.
УНФ
Проверить: цепочку заказа, отгрузки и оплаты, отчёты руководителя и подключённые интеграции; производственные операции — если они используются.
Для выбора: не считать небольшую компанию автоматически лёгкой нагрузкой. Частые обмены или доработанный отчёт могут определять пик сильнее числа сотрудников.
ERP
Проверить: используемые расчёты себестоимости, планирование, закрытие периода, тяжёлую аналитику и одновременные регламентные задания.
Для выбора: сначала получить профиль конкретных подсистем и баз. Само название ERP не доказывает необходимость двух сокетов, терабайта RAM или максимального числа ядер.
Практический результат: в ТЗ должны попасть не «сервер для ЗУП на 30 пользователей», а перечень операций, объём данных, ожидаемая параллельность и допустимое время. При одинаковом названии программы эти условия могут различаться в разы.
Доработки, расширения и обмены: когда покупать сервер рано
Перед обновлением оборудования составьте перечень расширений, внешних обработок и интеграций. Отметьте, что добавлено или изменено перед появлением задержек. Это не доказательство виновности доработки, а способ выбрать проверяемую гипотезу.
- Запросы в цикле: множество коротких обращений к СУБД способно увеличить время и сетевые ожидания.
- Длительная транзакция: удерживает ресурсы и может мешать другим операциям; фиксируйте конкретную цепочку ожиданий.
- Слишком широкая выборка: обработка получает больше данных, чем нужно, создаёт временные результаты и расходует память.
- Перекрытие заданий: обмен запускается чаще, чем успевает закончиться; несколько экземпляров конкурируют за те же данные.
- Внешний сервис: операция ждёт HTTP, файловый ресурс или интеграцию, а локальные CPU и SSD почти свободны.
Пример: каждые пять минут запускается десятиминутный обмен
Сначала выясните, допускает ли механизм параллельные запуски и не накапливается ли очередь. Согласованное изменение расписания и защита от перекрытия могут снять пик без замены сервера. Если объём обмена вырос и его требуется укладывать именно в пять минут, проверяйте код и ресурсное ограничение вместе.
На стенде сравнивайте один и тот же сценарий до и после изменения, с сохранением исходной версии и плана возврата. Не отключайте все расширения в рабочей базе: это может нарушить бизнес-логику. Попросите разработчика и администратора приложить к общей заявке время операции, интервал наблюдения и конкретный источник ожидания.
Из каких компонентов складывается быстродействие 1С
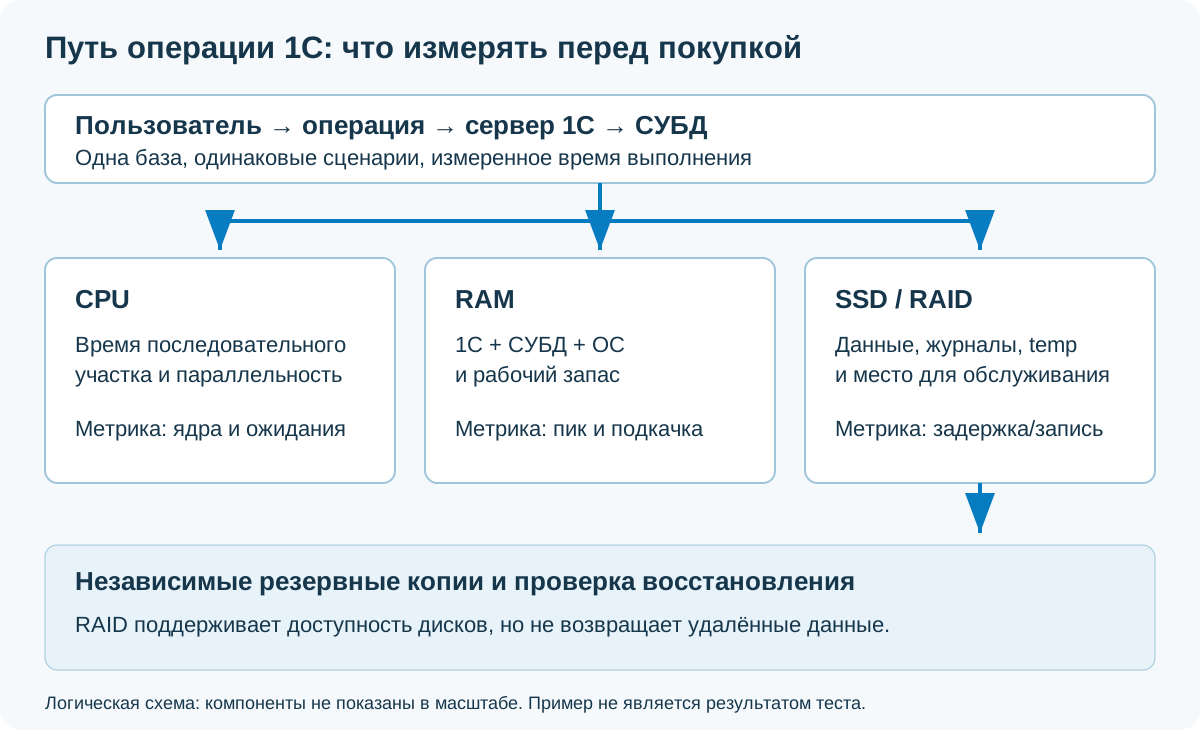
Задержка может возникнуть на любом участке: клиент ждёт сеть, рабочий процесс выполняет код, СУБД ждёт блокировку или подтверждение записи. Новый процессор не устраняет плохой запрос, а быстрый NVMe не снимает блокировку между двумя документами. Сначала сопоставьте замедление операции со временем и показателями конкретного узла.
Процессор: скорость одного потока и работа нескольких пользователей
В 1С есть последовательные участки выполнения. Дополнительные ядра помогают обрабатывать независимую параллельную работу, но не делят любую медленную операцию на равные части. Поэтому «больше ядер» и «быстрее проведение» — разные утверждения.
Для отклика операции
- Производительность ядра в реальном сценарии.
- Устойчивая частота под нагрузкой и охлаждение.
- Кэш, задержки памяти, версия платформы и СУБД.
Для общей пропускной способности
- Достаточное число доступных ядер.
- Одновременные пользователи и фоновые задания.
- Отсутствие очереди на CPU у гипервизора.
Intel Xeon и AMD EPYC — семейства серверных процессоров, внутри которых сильно различаются поколения и модели. Частоты в гигагерцах нельзя напрямую сравнивать между архитектурами. Максимальная Turbo/Boost — не гарантия частоты всех ядер на протяжении рабочего дня. В запросе поставщику укажите точную модель, лимиты мощности и критерий приёмки на вашей базе.
SMT/Hyper-Threading даёт дополнительные логические потоки, а не второе полноценное физическое ядро. Не принимайте запись «32 потока» за «32 физических ядра». Если средняя загрузка CPU невысока, посмотрите отдельные ядра: один занятый поток может ограничивать нужную операцию.
Базовая частота, Boost и частота всех ядер — три разных условия
Базовая частота — характеристика модели при оговорённых производителем условиях. Max Boost/Turbo — верхний предел динамического ускорения; это не обещание постоянной работы всех ядер на этой частоте. Под длительной нагрузкой важны мощность, ток, температура, прошивка и выбранный профиль сервера.
При увеличении числа активных ядер доступный boost может снижаться ступенями. Но универсальной лестницы «минус 100 МГц на каждое ядро» нет: поведение зависит от модели и нагрузки. Частоты могут отличаться между ядрами и во времени. Устройство с прекрасным кратким однопоточным результатом может уступить при часовом параллельном расчёте.
Что запросить в предложении
- Точную модель и базовую частоту.
- Максимальный boost и условия его достижения.
- Замеры частоты при 1, нескольких и всех активных ядрах.
- Температуру, ограничения мощности и признаки throttling.
Что проверить при приёмке
- Одинаковый профиль питания и прошивку.
- Результат сразу и после прогрева.
- Время операций вместе с фактическими частотами.
- Одновременно работающие обмены и СУБД.
Например, у AMD EPYC 9175F указаны 16 ядер, базовые 4,2 ГГц, All Core Boost 4,55 ГГц и максимальный boost до 5,0 ГГц. Даже отдельно опубликованная all-core характеристика относится к условиям производителя: фактическое устойчивое значение проверяют на выбранном сервере. Это пример чтения спецификации, а не минимально необходимый CPU для 1С и не результат нашего теста. Принцип зависимости Turbo от условий описан Intel.
Один или два процессора: когда второй сокет оправдан
Односокетная платформа часто проще по топологии памяти и лицензированию. Двухсокетная нужна, когда подтверждены требования к суммарным ядрам, памяти, линиям PCIe или нескольким нагрузкам. Сам по себе второй процессор не делает отдельный запрос вдвое быстрее.
- Уточните NUMA-топологию: доступ к локальной и удалённой памяти может иметь разную задержку.
- Заполняйте каналы памяти по руководству платформы; не переносите схему установки модулей с другой платы.
- Согласуйте NUMA/vNUMA и размер ВМ, особенно когда ресурсы одной машины пересекают аппаратные узлы.
- Проверьте число линий PCIe, слоты для NVMe и сетевых карт, а также зависимость слотов от установленного CPU.
Запас выбирают под понятный рост. Покупать второй сокет, который не будет использоваться, а затем экономить на SSD с защитой питания — сомнительный приоритет для базы данных.
NUMA на практике: сокет не всегда равен одному узлу
NUMA означает неодинаковую стоимость доступа к памяти. У двух CPU есть собственные контроллеры и локальная RAM; обращение к памяти другого CPU проходит через межпроцессорное соединение. Один сокет тоже может представляться ОС несколькими NUMA-узлами — это зависит от архитектуры и BIOS.
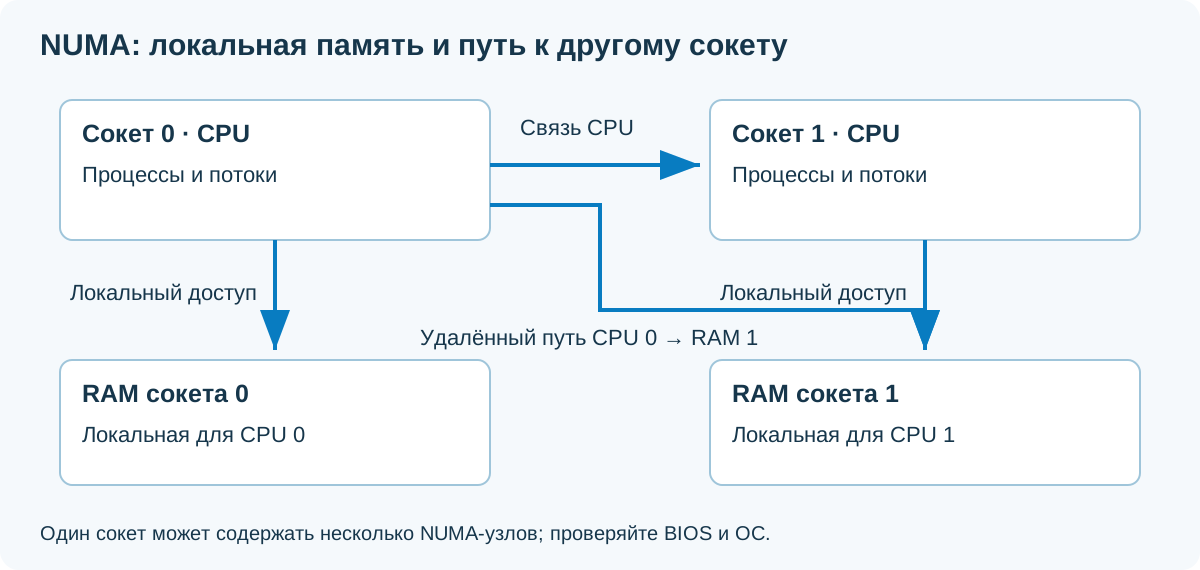
- Сначала посмотрите фактическую топологию. В Linux — команды ниже; в Windows дополните сведения ОС картой из BMC/BIOS и средствами гипервизора.
- Проверьте распределение DIMM. У обоих установленных CPU должен быть продуман локальный бюджет памяти.
- Выбирайте размер ВМ с учётом NUMA. Машина, помещающаяся в один аппаратный узел, может иметь более простой доступ к памяти, но искусственное уменьшение ВМ до нехватки RAM тоже вредно.
- Проверяйте расположение потоков и памяти под нагрузкой. Не закрепляйте все процессы на одном CPU вслепую.
lscpu -e=CPU,NODE,SOCKET,CORE
numactl --hardware
numastat -p <PID_ПРОЦЕССА>
numactl/numastat должны быть установлены; PID заменяют на фактический. Последняя команда показывает распределение памяти процесса, но сама по себе не измеряет задержку каждого удалённого обращения. В руководстве AMD по BIOS описаны режимы NPS — число NUMA-узлов на сокет. Настройки NPS/SNC, interleaving и vNUMA меняют по документации своей модели с проверкой исходного и нового результата; рецепта «всем NPS4» для 1С нет.
Как рассчитать оперативную память
Складывать нужно одновременно существующие нагрузки. Если сервер обслуживает ещё и терминальные сеансы, их память добавляется отдельно. Размер файла базы не равен требованию к RAM: важно, какая часть данных активно используется, как строятся запросы и сколько операций выполняется одновременно.
Пример: 18 + 48 + 12 = 78 ГБ. С запасом 25% к рассчитанной нагрузке: 78 × 1,25 = 97,5 ГБ. Можно рассматривать 128 ГБ с проверкой заполнения каналов и пиков при испытании. Это не норматив для определённого количества пользователей.
Бюджет СУБД включает её реальные потребности, а не только настройку кэша. У SQL Server существуют выделения памяти вне части, управляемой max server memory. У PostgreSQL work_mem может выделяться несколькими узлами запроса и параллельными исполнителями: умножение одной величины только на число пользователей не даёт надёжной верхней оценки.
Не отключайте файл подкачки или swap ради красивого графика. Установите причину активной подкачки и согласуйте настройку ОС. Для покупки важно оценить нехватку памяти, а не объявить любое использование swap аварией.
ECC, RDIMM и частота: что проверить в спецификации памяти
- Совместимость: поколение DDR, тип RDIMM/UDIMM, поддержка ECC процессором и платой, допустимые ёмкости и проверенные модули.
- Каналы: сколько каналов задействовано и как изменится пропускная способность при выбранном числе модулей.
- Реальная скорость: ограничивается CPU, платой, числом DIMM на канал и режимом BIOS. Маркировка модуля не гарантирует ту же скорость в этой сборке.
- Расширение: какие слоты останутся и придётся ли менять уже купленные модули.
- Обслуживание: мониторинг исправленных и неисправимых ошибок, доступность замены и гарантия.
Для DDR5 корректнее писать скорость передачи в MT/s. Модуль DDR5-4800 или DDR5-6400 выбирают по совместимости и схеме заполнения, а не по максимальной цифре в каталоге. Самая дешёвая совместимая серверная память может быть разумным выбором; несовместимый комплект — нет. ECC снижает определённые риски ошибок памяти, но не заменяет резервное копирование.
Каналы памяти: одинаковые 256 ГБ могут работать по-разному
Канал — независимый путь контроллера к памяти, слот — место установки модуля, rank — организация чипов внутри DIMM. Это не взаимозаменяемые понятия. Два модуля на одном канале не превращают его в два канала. Обозначения 1DPC/2DPC означают один/два DIMM на канал.
На условной восьмиканальной платформе 8 × 32 ГБ и 4 × 64 ГБ дают одинаковые 256 ГБ. В первом случае можно задействовать восемь каналов, во втором — только четыре, если модули стоят в разных каналах по схеме производителя. Это влияет на доступную полосу, но не гарантирует двукратного ускорения 1С.
Для DDR5-4800 один такой канал даёт 38,4 ГБ/с теоретически: восемь — 307,2 ГБ/с, четыре — 153,6 ГБ/с. Это предел передачи без учёта накладных расходов и реального доступа, а не измеренная скорость приложения. У DDR5 канал дополнительно организован в подканалы; в этой формуле считается полная 64-битная ширина данных без ECC-битов.
Платформы различаются: например, Lenovo для серверов с EPYC 9005 описывает двенадцать каналов на сокет. Если заполнить только часть, покупатель получает ёмкость, но не всю потенциальную полосу. Схему установки, допустимую несимметрию, ranks и скорость при 2DPC сверяйте с Memory Population Guidelines и руководством конкретного сервера. Более дорогой DDR5-6400 может работать медленнее маркировки из-за CPU, DIMM и заполнения.
ECC: какие ошибки исправляет память и что делать администратору
ECC добавляет контрольную информацию, позволяющую обнаруживать и исправлять определённые ошибки. В базовой схеме SECDED исправляется одиночная битовая ошибка и обнаруживается двойная; серверные платформы могут использовать более сложные механизмы. Нельзя обещать исправление любого многобитового повреждения. Возможности определяются всей связкой CPU, платы, DIMM и BIOS.
Внутренняя on-die ECC микросхем DDR5 не равна системной ECC-защите передачи и хранения данных во всём тракте. Маркировка DDR5 сама по себе ещё не делает рабочую станцию полноценной ECC-платформой.
- Correctable Error (CE): данные исправлены, но событие учитывают. Нарастающий поток по одному DIMM требует диагностики и обслуживания.
- Uncorrectable Error (UE): исправить не удалось. Возможны остановка, исключение страницы или другие реакции платформы; проверьте целостность приложения после инцидента.
- Действия: сохранить журнал BMC/SEL и ОС, установить слот, серийный номер, частоту событий и рекомендации производителя; подготовить замену и окно.
В Windows ищите WHEA-события, в Linux — EDAC/RAS и записи ядра; доступность зависит от платформы и драйверов. Dell различает исправимые, повторяющиеся и неисправимые ECC-события. Не стирайте журнал до выгрузки и не отключайте ECC ради подавления уведомлений. Исправленная ошибка — не повод немедленно выключать сервер без анализа, но игнорировать устойчивый рост тоже нельзя.
Ёмкость дисков: база — только часть расчёта
Считайте физически выделяемое место без двойного учёта. Если размер БД уже включает индексы, не добавляйте их второй раз. Для журналов SQL/WAL оцените пики, отставание резервирования или репликации, а не только текущий размер каталога.
Условный пример: данные и индексы 320 ГБ + рост 160 ГБ + журналы 120 ГБ + временные файлы 80 ГБ + место для обслуживания 160 ГБ = 840 ГБ. Чтобы оставить 25% пула свободными, нужно 840 / 0,75 = 1 120 ГБ полезной ёмкости. Умножение на 1,25 дало бы только 1 050 ГБ и меньше требуемой доли свободного места.
Зеркало из двух накопителей по 1,6 ТБ даёт около 1,6 ТБ номинальной полезной ёмкости до форматирования и накладных расходов. В примере запас есть; пригодность по задержкам и ресурсу записи проверяют отдельно. Здесь ТБ — десятичные единицы производителя: 1 ТБ = 1 000 ГБ. Интерфейс ОС может показывать двоичные единицы: 1 ТБ ≈ 0,91 TiB. Не считайте эту разницу потерянным диском.
Резервные копии не включены в этот рабочий пул. Для них нужна отдельная ёмкость и независимая схема хранения. Локальный файл копии на том же массиве не защищает от его потери.
SSD под базу: NVMe, U.2/U.3, PLP и ресурс записи
Для нагруженной БД важны задержки синхронной записи, поведение после заполнения и устойчивость к сбою питания. Рекламные гигабайты в секунду последовательного чтения не описывают весь этот профиль.
- NVMe — протокол. U.2/U.3 — варианты серверного подключения и исполнения; совместимость проверяют по корзине, backplane, кабелям и контроллеру.
- PLP — защита от потери питания. Проверяйте её наличие и описанные производителем гарантии именно для выбранной модели.
- DWPD/TBW — допустимый объём записи за гарантийный период при определённых условиях испытаний.
- Latency/QoS — задержки и их разброс при ожидаемом заполнении и смешанной нагрузке.
- Обслуживание — прошивки, телеметрия износа, температурный режим и замена диска.
Для интенсивно записывающей 1С включите в ТЗ серверные SSD с PLP и ресурсом не менее 3 DWPD, затем проверьте достаточность по измерениям. Это выбранный консервативный критерий для такой нагрузки, а не обязательное требование платформы 1С к любому диску. Для зеркала загрузки гипервизора может хватить совместимых SSD по 256–512 ГБ: гигантская ёмкость там не нужна.
Названия одного семейства недостаточно: варианты на чтение и на смешанную запись различаются. Например, страница Micron 7450 позволяет перейти к спецификациям серверной линейки и защите питания; при заказе фиксируют точный артикул, ресурс и прошивку, а не только бренд.
Как проверить DWPD по своей записи
Снимите счётчики записи в начале и конце представительного периода, проверьте единицы SMART и посчитайте разность. Не делите накопленную за всю жизнь запись на одни сутки. RAID-контроллер и гипервизор могут скрывать физические диски: нужны показания каждого устройства или достоверная телеметрия контроллера.
Если на один SSD ёмкостью 1,6 ТБ приходит 1,2 ТБ host writes в сутки, оценка — 0,75 DWPD. Условный накопитель на 3 DWPD допускает 4,8 ТБ записи в сутки в рамках условий производителя. Оставьте запас на рост, восстановление массива, обслуживание и пики. В зеркале данные записываются на оба диска: нельзя делить запись приложения пополам только потому, что накопителей два.
Host writes и физическая запись во флеш-память — разные показатели. Сравнивайте метрику с той, для которой заявлен ресурс изделия; не умножайте повторно на write amplification, если она уже учтена в используемой оценке. Проверьте также гарантийный срок и TBW: одной цифры DWPD без этих условий недостаточно.
Зеркало, RAID 10 или RAID 6: что выбирать под 1С
| Схема | Полезная ёмкость одинаковых SSD | Когда рассматривать |
|---|---|---|
| Зеркало, 2 диска | Ёмкость одного | Простой рабочий пул, если хватает задержек и ёмкости |
| RAID 10, 4 диска | Суммарная ёмкость / 2 | Смешанная запись; проверка производительности и поведения при отказе |
| RAID 6, от 4 дисков | (N − 2) × ёмкость одного | Когда важны ёмкость и два отказа; стоимость паритетной записи оценивают тестом |
Это номинальные ёмкости до форматирования, резервов и свободного пространства. Четыре SSD по 1,6 ТБ в RAID 10 дают около 3,2 ТБ. Нельзя обещать пережить любые два отказа: потеря обеих копий одной зеркальной пары разрушает массив. У RAID 6 другая модель отказов, но это не делает его автоматически лучшим вариантом для транзакционной БД.
В аппаратном RAID проверьте защищённый кэш, батарею/суперконденсатор, политику записи при неисправности защиты и совместимость NVMe. Для ZFS обычно планируют прямой доступ к дискам через подходящий HBA, а не прячут их за ещё одним RAID. Не отключайте fsync, synchronous commit или гарантии записи ради результата теста.
Разные логические тома одного массива не создают независимую производительность и отказоустойчивость. Вынос журналов на отдельный физический пул оправдывают измерениями и требованиями; это не обязательный рецепт для каждой небольшой базы.
Какой минимум закладывать и когда нужен RAID 10
Это инженерный старт для обсуждения клиент-серверной 1С, а не официальный минимум и не гарантия на число пользователей. Итоговую комплектацию принимают по тесту своей базы.
- CPU: современная совместимая x86-64 платформа; как кандидат стенда можно начать с 6–8 производительных физических ядер. Если есть СУБД, терминальные сеансы и фоновые задания, ресурсы считают суммарно. Старый многоядерный Xeon с низкой производительностью ядра не равнозначен новому CPU.
- Частоты: универсального порога «не ниже 3,5 ГГц» нет. Оценивайте архитектуру, базовую частоту, доступный boost и результат длительной нагрузки. Низкочастотная многопоточная модель требует особенно внимательного испытания последовательных операций.
- RAM: ECC при поддержке всей платформой; начальную ёмкость выбирайте по расчёту, не урезая бюджет СУБД ради заполнения красивой таблицы.
- Диски: минимальная зеркальная избыточность — два SSD. Отдельное загрузочное зеркало и отдельное рабочее зеркало означают уже четыре устройства. Для нагруженной записи рассматривайте RAID 10 из четырёх и более SSD, если он обеспечивает нужные задержки, ресурс и ёмкость.
- Защита: для рабочего пула БД — подтверждённые PLP и ресурс; мониторинг дисков, ИБП, независимые копии и проверка восстановления.
RAID 0 не даёт дисковой избыточности. RAID 5 переживает один отказ, но паритетная запись и восстановление требуют отдельной оценки; назначать его вариантом по умолчанию под интенсивную транзакционную запись без теста не стоит. RAID 6 — не ускоренная версия RAID 10: сравнивайте профили, деградированный режим и окно восстановления, а не только полезные терабайты.
У SSD проверяйте SMART/NVMe health: remaining spare, percentage used, media/data-integrity errors, температуру и журнал ошибок. RAID-контроллер может скрывать эти сведения; обеспечьте доступ к ним штатным средством. Совместная партия, прошивка, питание и ошибка администратора создают общие риски: вероятности отказов нельзя считать полностью независимыми.
Разные пулы для базы, журналов и temp: когда это даёт полосу
Рекомендация разделять файлы имеет физический смысл, только если разделены конкурирующие ресурсы. Три буквы дисков одного массива — это те же SSD, контроллер и очередь. Три виртуальных диска на одном datastore тоже не создают три независимых массива.
Компактный вариант
Загрузочное зеркало отдельно, рабочие data/log/temp на достаточно быстром защищённом пуле. Удобен, когда измеренные пики укладываются в его возможности.
Вариант с разделением
Data — отдельный пул, transaction log/WAL — отдельный защищённый пул, temp — ещё один ресурс при подтверждённой конкуренции. Больше устройств, портов и точек контроля.
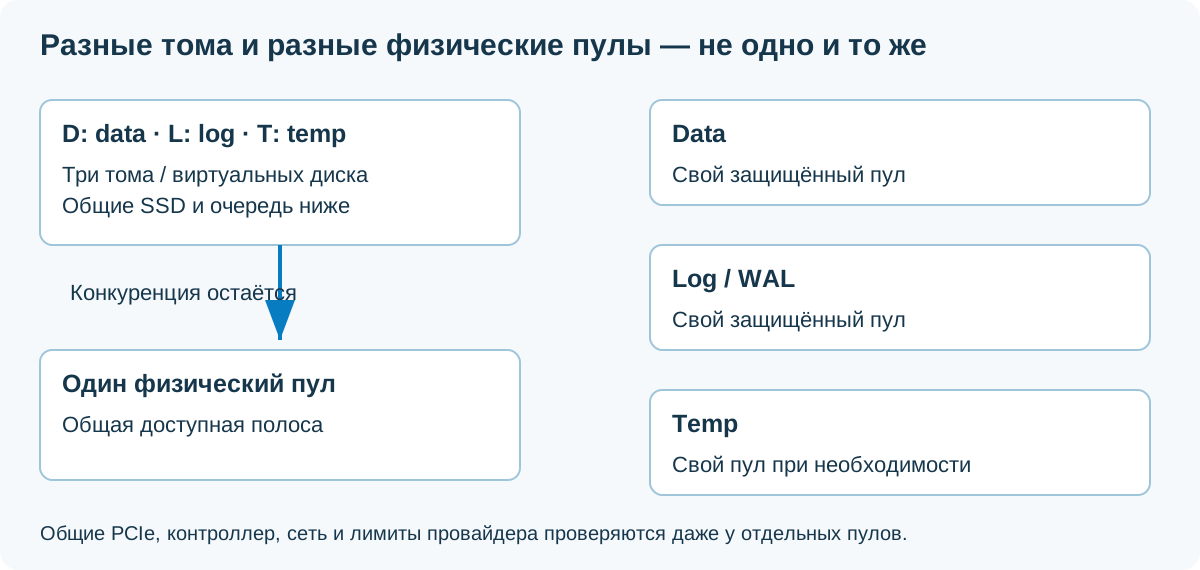
Data: смешанные чтение и запись страниц. Transaction log/WAL: чувствительность к подтверждению последовательной записи. Temp: сортировки, хеширование и промежуточные результаты способны конкурировать с основной БД. Журналы СУБД нельзя путать с технологическим журналом 1С: у них разная роль.
Microsoft рекомендует разносить data и log по дискам. Возможность и выигрыш оценивают по фактическому хранилищу. В tempdb важны предварительный размер и одинаковые размеры/прирост файлов данных; число файлов подбирают по CPU и конкуренции выделения. Несколько файлов tempdb не создают сами по себе дополнительные физические диски. Добавление файлов журнала также не превращает запись журнала SQL Server в striped RAID.
Для PostgreSQL отдельно оценивают PGDATA, pg_wal и временные tablespaces. WAL — часть механизма надёжности; его потеря не «просто потеря логов». Перенос путей выполняют отдельной процедурой с остановкой/настройкой прав по документации, а не перемещением работающих файлов в проводнике.
Когда SSD мало, чрезмерное дробление может ухудшить ситуацию: каждому пулу не хватает устройств, а свободная ёмкость простаивает на соседнем. Сначала сравните общий RAID 10 с раздельными зеркалами на одинаковом комплекте в своём профиле.
Лицензии могут ограничить отдачу от дорогого железа
До заказа согласуйте редакции 1С, СУБД и ОС. В официальном FAQ 1С описаны ограничения актуальной схемы ПРОФ: использование до 12 ядер на сервере кластера и до 500 одновременных пользовательских сеансов одной ИБ. Есть условия старых лицензий и обновлений; сверяйте свою поставку. Само наличие в машине большего числа ядер не означает, что ПРОФ задействует их все.
КОРП рассматривают при необходимости соответствующих ресурсов или функций, а не как обязательную покупку вместе с любым сервером. Клиентские лицензии, лицензия сервера платформы и редакция прикладной программы — разные позиции.
У SQL Server Standard лимиты зависят от версии: для 2022 вычислительный предел одного экземпляра — меньшее из 4 сокетов или 24 ядер, buffer pool — до 128 ГБ; для 2025 — меньшее из 4 сокетов или 32 ядер, buffer pool — до 256 ГБ. Лимит buffer pool не равен всему потреблению процесса. Для ВМ и подсчёта лицензируемых ядер проверьте отдельные правила.
Наличие новой версии SQL Server в этом сравнении не означает её поддержку вашей версией 1С. Проверяйте матрицу совместимости. PostgreSQL не отменяет расходы на сопровождение, резервирование и выбранную коммерческую сборку.
Физический сервер или ВМ: сравнивайте одинаковые условия
- Укажите модель CPU хоста, число vCPU, RAM и правила конкуренции за процессор.
- Зафиксируйте класс хранилища, задержки, ограничения IOPS/полосы и доступное место.
- Проверьте NUMA, резервирование памяти и нагрузку соседних машин.
- Оставьте ресурсы гипервизору и служебным процессам: выделение гостям всей памяти хоста не является запасом.
- Отдельно опишите резервные копии, восстановление, лицензии и ответственность администратора.
Один vCPU нельзя приравнять к одному физическому ядру без условий предоставления ресурса. И наоборот, физическая машина не гарантирует быстродействие при неверном BIOS, перегреве или медленном массиве. Для облачного варианта запросите испытание той же базы и нагрузки; не сравнивайте целый мощный сервер с существенно меньшей ВМ как равнозначные покупки.
Где размещать 1С, СУБД, терминалы и интеграции
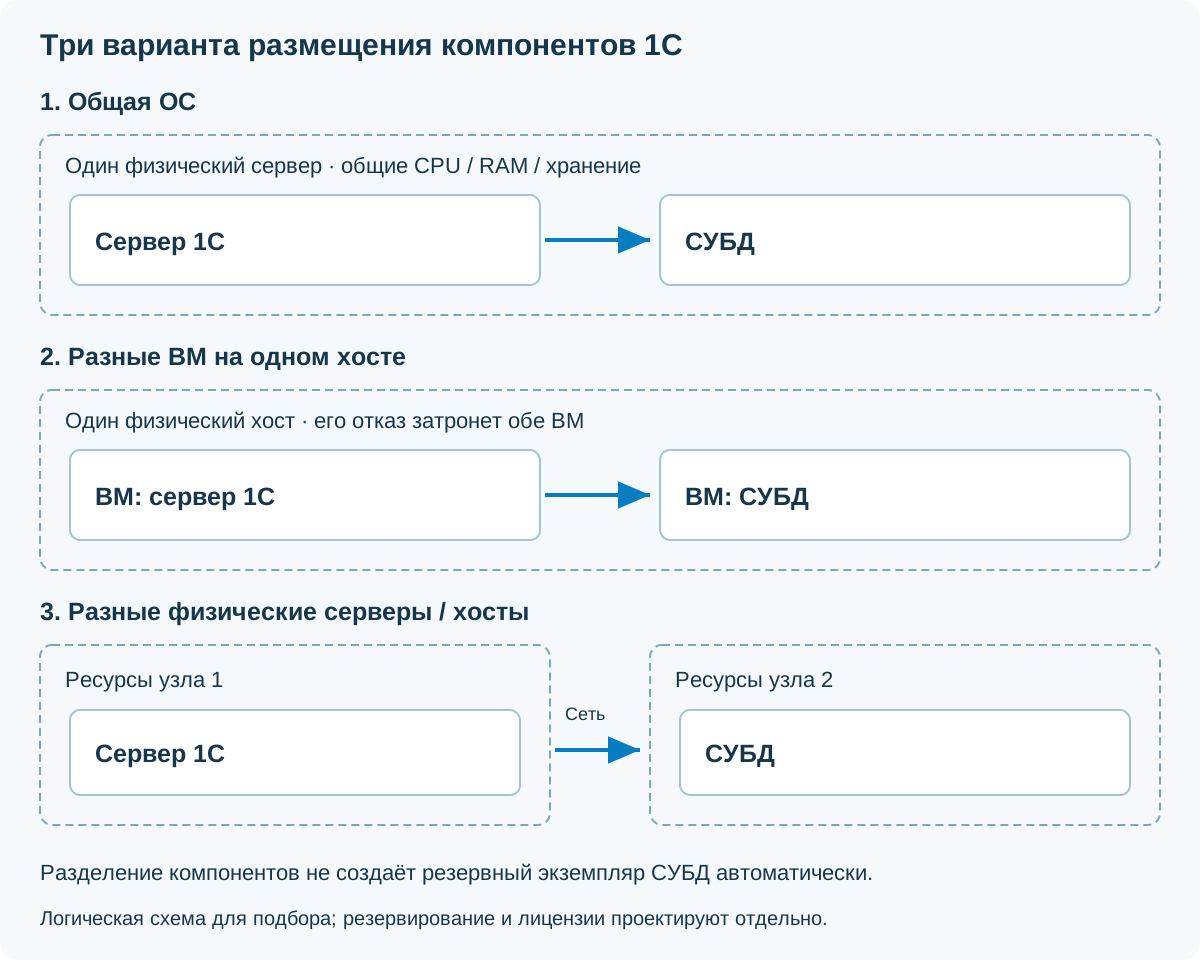
Одна ОС: сервер 1С и СУБД вместе
Плюсы: проще инфраструктура, нет межсерверного сетевого участка между этими компонентами. Ограничения: общий бюджет CPU/RAM и влияние обслуживания друг на друга. Подходит как проверяемый вариант, если суммарные пики укладываются в ресурсы. Лимит памяти СУБД согласуют с потребностями 1С и ОС.
Раздельные ВМ на одном хосте
Плюсы: отдельные ОС, настройки, бюджеты и процедуры обслуживания. Ограничения: физические CPU, диски и хост по-прежнему общие. Отказ хоста затронет обе ВМ; разделение не является аппаратной отказоустойчивостью. Проверяйте совокупную нагрузку, NUMA и план восстановления.
Раздельные физические серверы или хосты
Плюсы: можно независимо подобрать ресурсы 1С и СУБД, разделить часть отказов и обслуживание. Ограничения: появляется критичный сетевой путь, растут стоимость и сложность. Отказ единственного сервера БД всё равно остановит систему: для HA нужен отдельный проект и лицензии.
Терминальные сеансы требуют своего бюджета: пользовательские приложения, печать и браузеры конкурируют с серверной нагрузкой. Не делайте доступ сотрудников к рабочему столу сервера БД способом экономии RAM. Веб-публикацию и интеграции проектируйте с учётом доступа и сетевой изоляции, а не открывайте порт СУБД в интернет. Тестовую базу ограничьте по ресурсам, отключите нежелательные обмены и исходящие уведомления после копирования.
Какой вариант выбрать? Если мешает взаимное вытеснение ресурсов — проверяйте разделение. Если время уходит на запрос или блокировку — перенос по разным машинам сам по себе проблему не исправит. У клиент-серверного варианта роль рабочего процесса описана в архитектуре 1С.
Кластер 1С: какие настройки влияют на расчёт ресурсов
Кластер 1С не означает обязательное наличие нескольких физических машин. Для подбора важно знать число баз, процессы, реальные сеансы и фоновые задания. Рабочие процессы обслуживают прикладную работу, поэтому их пиковая память должна попасть в расчёт RAM, а не потеряться за одной строкой «служба 1С».
- Снимите исходную картину: какие базы и соединения обслуживает каждый рабочий сервер, сколько процессов реально запущено, как меняется память за день.
- Разберите рост памяти: штатный рабочий набор, тяжёлая операция, расширение или проблема конкретной версии. Плановый перезапуск не заменяет поиска причины устойчивого роста.
- Проверьте настройки запуска и замены процессов. Слишком частая замена может создавать лишний прогрев и влиять на обслуживание; точные параметры и поведение сверяют по версии платформы.
- Оцените доступное управление размещением. Требования назначения функциональности определяют, какие сервисы и соединения разрешено обслуживать на рабочем сервере; они не задают произвольному запросу физическое ядро CPU.
Механизм требований и перечень возможностей КОРП описаны отдельно. Дополнительное распределение по базам, видам клиентов и фоновым заданиям, а также часть гибких ограничений памяти относятся к функциональности КОРП. Нельзя включать их в проект с ПРОФ без проверки прав использования, версии и условий конкретной поставки. Наличие настройки в интерфейсе не заменяет лицензию.
Вывод для закупки: не рассчитывайте, что лишние процессы автоматически задействуют все ядра, а КОРП автоматически ускорит конфигурацию. Сначала определите ограничение, затем выберите достаточные ресурсы и действительно необходимые функции управления.
Проверка СУБД перед закупкой: SQL Server и PostgreSQL
Не переносите одинаковый набор настроек на все базы. Версия СУБД и поддержка её сборки платформой 1С проверяются до подбора. Ниже — направления диагностики, а не скрипт массового тюнинга.
Microsoft SQL Server
- Согласовать max server memory с RAM для ОС, 1С и других служб; учитывать память вне регулируемой части.
- Проверить MAXDOP и порог стоимости параллелизма по топологии и профилю запросов.
- Сопоставить планы запросов, статистики и ожидания с медленными операциями.
- Проверить рост data/log, tempdb, свободное место и обслуживание индексов.
PostgreSQL
- Разделить shared_buffers, кэш ОС и память исполнения запросов.
- Учитывать work_mem и hash_mem_multiplier при параллельной работе.
- Проверить autovacuum/analyze, долгие транзакции и рост таблиц.
- Проверить checkpoints, WAL, временные файлы и отставание архивирования.
У SQL Server нельзя оценивать всю RAM процесса только по значению max server memory. MAXDOP выбирают с учётом топологии и нагрузки, а не равным числу ядер автоматически; значение 1 тоже не является универсальной настройкой для всех операций 1С. Основания: управление памятью и параллелизм.
У PostgreSQL увеличение work_mem может сократить временные файлы одного запроса и одновременно исчерпать RAM при конкуренции. Отключение autovacuum ради короткого теста искажает эксплуатационный профиль. Описания ресурсов и обслуживания сверяют со своей версией; подробная прикладная инструкция — PostgreSQL для 1С.
Рабочий порядок: сохранить исходные значения и метрики → изменить один обоснованный фактор на стенде → повторить сценарий → проверить последствия для остальных операций → принять изменение или вернуть настройки. Нельзя выключать гарантии записи и затем выдавать выигрыш за качество SSD.
Сеть, питание и серверная платформа
Серверы приложений и СУБД по возможности размещают в близкой сети с предсказуемой задержкой. Измеряйте не только ping: потери, ошибки интерфейса, занятость канала и время реального обмена тоже влияют на результат. Management-интерфейсы вынесите в отдельный VLAN с ограниченным доступом.
Пример для копирования: передать 2 ТБ за 8 часов — это в среднем около 69,4 МБ/с полезных данных. У 1GbE теоретический потолок 125 МБ/с до накладных расходов; совместная нагрузка, чтение и запись могут не позволить уложиться в окно. Это повод проверить путь целиком и рассмотреть 10GbE, а не обещать нужную скорость по названию порта.
- Удалённая консоль BMC/IPMI и управляемое обновление прошивок.
- ECC, совместимые корзины и диски, мониторинг вентиляторов и температур.
- Резервные БП с согласованными независимыми вводами, ИБП и проверяемое завершение работы.
- Ремонт и поставка запчастей в срок, соответствующий допустимому простою.
Рабочая станция с быстрым Ryzen может показать хороший результат отдельных операций, но не получает автоматически перечисленные возможности серверной платформы. Два блока питания также не устраняют отказ платы, ОС или массива. Для высокой доступности требуется отдельная архитектура, а для восстановления — проверенные копии.
Интерфейс для бэкапа: 1, 10 или 25 Гбит/с
Планируйте одновременно чтение источника, CPU обработки/шифрования, сеть и запись репозитория. Медленнейший участок ограничивает поток. Для восстановления направление меняется: быстрый backup ещё не гарантирует быстрый restore. Сжатие и дедупликацию учитывайте по измеренной передаче, а не по обещанному коэффициенту.
- 1GbE: 125 МБ/с теоретически; проверьте, хватает ли с запасом на обычный трафик.
- 10GbE: 1,25 ГБ/с до накладных расходов; разумный кандидат для больших окон копирования, миграций и восстановления.
- 25GbE: 3,125 ГБ/с теоретически; имеет смысл, если источник, репозиторий, PCIe и сеть дают соответствующую скорость.
Поддержка скорости нужна с обеих сторон: NIC, слот PCIe, коммутатор, модуль/DAC/кабель. SFP+ обычно используется для 10GbE, SFP28 — для 25GbE; совместимость конкретного порта и модуля проверяют отдельно. Отдельный backup VLAN помогает управлять доступом и трафиком, но не добавляет полосу общему физическому порту. LACP из двух 10GbE не обещает 20 Гбит/с одному TCP-потоку. Jumbo frames включают только при согласованном MTU по всему пути.
Пример: 2 000 ГБ за 8 часов при полезной доле 70% требуют около 0,794 Гбит/с номинальной полосы. 1GbE проходит только по такому расчёту; приемлемость решают реальной копией и восстановлением с учётом конкуренции. Для 2 000 ГБ за 2 часа получится уже около 3,175 Гбит/с — нужно рассматривать более быстрый тракт.
Как собрать инвентаризацию без изменения настроек
Примеры PowerShell ниже читают характеристики локального Windows-сервера. Они не являются готовым нагрузочным тестом. В ВМ показывается гостевая топология; физическую комплектацию дополнительно смотрят на хосте и в BMC.
Get-CimInstance Win32_Processor |
  Select-Object Name,NumberOfCores,NumberOfLogicalProcessors
Get-CimInstance Win32_PhysicalMemory |
  Select-Object DeviceLocator,Capacity,Speed,ConfiguredClockSpeed
Get-CimInstance Win32_LogicalDisk -Filter "DriveType=3" |
  Select-Object DeviceID,Size,FreeSpace
Классы CIM зависят от ОС и оборудования; данные о памяти сверяйте с BIOS. Описание Get-CimInstance приведено у Microsoft. В Linux начните с:
lscpu
free -h
lsblk -o NAME,TYPE,SIZE,MODEL,MOUNTPOINTS
vmstat 1 10
Если установлен sysstat, iostat -xz 1 60 помогает наблюдать устройства, а mpstat -P ALL 1 60 — отдельные CPU. Список доступных полей зависит от версии. Средняя задержка не показывает все редкие провалы; сопоставляйте её с временами операций. У SSD/NVMe процент util сам по себе не доказывает исчерпание параллелизма.
Для PostgreSQL можно начать с чтения размера текущей БД и накопленной статистики:
SELECT current_database(), pg_size_pretty(pg_database_size(current_database()));
SELECT datname, xact_commit, xact_rollback, temp_bytes, stats_reset
FROM pg_stat_database
WHERE datname = current_database();
Счётчики сравнивают по двум снимкам с одинаковым интервалом и учётом stats_reset. Поля и права уточняют в документации своей версии PostgreSQL. Команды в статье не выполнялись на вашем сервере; результаты не выдумываются.
Три прикладные ситуации: где покупка поможет, а где нет
Тормозит проведение одного документа
Средняя загрузка CPU 20%, одно ядро занято, диски отвечают быстро. Сначала разберите код, запросы и блокировки именно операции. Смена платформы CPU может помочь последовательной части, но добавление десятков ядер без изменений сценария не гарантирует ускорения.
Закрытие месяца вытесняет рабочие данные
Обычный день проходит нормально, во время расчёта растут память, временные файлы и задержки. Вынесите этот сценарий в испытание, уточните рабочий набор, планы запросов и расписание. Расширение RAM должно решать подтверждённую нехватку, а не заменять исправление чрезмерного потребления.
Днём быстро, ночью копирование не успевает
Проверьте чтение массива, сетевой путь, скорость репозитория и конкурирующее обслуживание. Покупка процессора для 1С может никак не ускорить запись на медленное хранилище копий. В приёмку включите ночное окно и восстановление.
Это учебные сценарии, а не описания выполненных клиентских проектов. Подробная диагностика медленной 1С помогает отделить настройки и код от нехватки оборудования.
Администратор или программист: как определить источник задержки
Спор решают наблюдения за одной и той же операцией, а не общая загрузка сервера на следующий день. Во всех примерах ниже симптом — повод проверить гипотезу, а не окончательный диагноз.
Проверить: последовательный код, план запроса и фактическую частоту. Не спешить: покупать больше ядер. Нужен результат операции после изменения кода или производительности ядра.
Проверить: блокирующую сессию и цепочку транзакций, ожидание внешнего сервиса. Не спешить: добавлять RAM без признаков нехватки.
Проверить: log flush/WAL sync, очередь хранилища, кэш контроллера, фоновые копии и здоровье SSD. Не спешить: менять CPU или отключать flush.
Проверить: общий бюджет памяти, планы запросов, объём сортировок и конкуренцию. Не спешить: увеличивать лимиты каждому процессу одновременно.
Проверить: клиентский режим, WAN/VPN, терминальный сервер, потери, печать и перенаправления. Не спешить: считать сервер БД единственным виновником.
Проверить: конкуренцию чтения/записи, CPU сжатия, репозиторий и сетевой тракт. Не спешить: менять всё оборудование без определения общего ресурса.
В общей заявке зафиксируйте версию базы, точную операцию, время начала/окончания, число повторов, параллельные задания и приложенные метрики. Администратор подтверждает инфраструктурные ожидания, разработчик — исполнение прикладного кода и запросов. Если данных пока нет, заключение «конфигурация плохая» или «сервер слабый» преждевременно.
ТЗ и приёмка: что попросить у поставщика
- Точная спецификация: артикулы CPU, платы, DIMM, SSD, backplane, контроллера, сетевых карт и БП; схема установки.
- Условия: версии BIOS/прошивок, ОС, платформы, СУБД, лицензии, политика питания и состав ВМ.
- Сценарии: одинаковая обезличенная копия базы, число исполнителей, фоновые задания, холодный и прогретый запуск.
- Критерии: время операций и его разброс, p95 при достаточном числе повторов, длительность регламентных задач.
- Надёжность: мониторинг, резервирование, проверка восстановления и согласованный порядок сервисного испытания отказов.
- Граница поставки: кто переносит базу, настраивает резервирование, поддерживает сборку и отвечает за приёмку.
Синтетический тест полезен для первичного сравнения, но не предсказывает точно поведение доработанной конфигурации. Не запускайте разрушительные fio/DiskSpd-тесты на рабочих файлах. Сервисные проверки отказов проводят на согласованном стенде с возможностью возврата.
После выбора оборудования переходите к настройке сервера 1С. Для виртуализации пригодится методика сравнения производительности на гипервизорах.
Приёмка не только в идеальном режиме: копирование, обслуживание, отказы
В ТЗ задайте два класса условий: обычная работа и согласованная конкурирующая нагрузка. Не требуйте неизменного отклика при любом отказе: заранее укажите, какое замедление и какой простой допустимы.
- Пользователи + резервная копия. Запустите характерные операции одновременно с копированием; зафиксируйте отклик, длительность бэкапа и влияние сжатия/шифрования.
- Работа + обслуживание. Проверьте допустимое сочетание со статистиками, индексами, vacuum или регламентными расчётами. Онлайн-возможности и блокировки зависят от продукта и редакции; не обещайте отсутствие простоя.
- Рост и заполнение. Тестируйте ожидаемый объём базы и разумное заполнение SSD, а не только пустую новую систему. Учитывайте предусмотренные накладные расходы.
- Восстановление из копии. Поднимите изолированный экземпляр, проверьте вход, документы и необходимые зависимости. Время передачи файла не равно полному RTO.
- Деградированный RAID и rebuild. Только на согласованном стенде по инструкции производителя: проверить время восстановления и отклик при этом. Не выдёргивать рабочий диск ради эксперимента на боевом сервере.
- Потеря узла или питания. Если такая устойчивость входит в проект, испытать переключение/завершение и возврат по отдельному плану с владельцем системы. Два БП сами этот сценарий не закрывают.
Отдельно заложите ресурсы на обслуживание: временную копию базы, миграцию, обновление конфигурации и проверку восстановления. «Все ресурсы заняты рабочими ВМ» означает, что служебные операции будут вытеснять полезную нагрузку. Результат приёмки — протокол с условиями и отклонениями, а не фотография экрана с высоким баллом.
Полный комплект поставки и расширение: что часто забывают
- Платформа: поддерживаемая версия BIOS под выбранный CPU, радиатор нужного TDP, вентиляторы и направляющие воздушного потока.
- Память: точные артикулы, схема каналов, доступная скорость, свободные слоты; стоимость расширения без замены всего комплекта.
- Диски: салазки, backplane, U.2/U.3-совместимость, кабели и свободные линии PCIe. Hot-swap должен поддерживаться всем трактом и процедурой ОС.
- Контроллер: HBA/RAID под выбранную архитектуру, защита кэша, нужные кабели и доступность мониторинга физических SSD.
- Сеть: NIC, подходящий слот, модули/DAC, порты коммутатора и резервный путь при необходимости.
- Обслуживание: салазки стойки, совместимые вводы питания, удалённая консоль и лицензия её нужных функций, доступ к обновлениям и мониторингу.
- Запас и сервис: совместимые сменные SSD/БП/DIMM, срок поставки, условия гарантии, кто выполняет замену и возвращает систему в работу.
Пример ошибки заказа: в предложении есть четыре NVMe, но выбранная корзина рассчитана на другой интерфейс, а нужные кабели и контроллер не включены. Цена комплектующих формально посчитана, рабочая конфигурация — нет. Просите поставщика подтвердить совместимость всей сборки и её схему подключения, включая возможность дальнейшего расширения.
Какие тесты использовать: от железа к реальным операциям
1. Наблюдение за рабочей системой
Технологический журнал и замеры 1С, средства СУБД, PerfMon/Zabbix, CPU по ядрам, память, I/O и сеть. Сопоставьте интервалы с медленной операцией; полное подробное логирование может создавать нагрузку и раскрывать данные, поэтому согласуйте состав и срок хранения.
2. Синтетика отдельных подсистем
DiskSpd для Windows, fio для профилей I/O, iperf3 для сети. Смотрите latency и percentiles при заданных размере блока, глубине очереди, чтении/записи и гарантиях flush, а не только максимальные IOPS.
3. Синтетический тест среды 1С
Тест Гилёва TPC-1C полезен для сравнения однопоточного сценария в одинаковых условиях. Его баллы не равны числу пользователей и не заменяют проверку вашей доработанной конфигурации. Версию теста, платформу, СУБД и состояние базы фиксируют в протоколе.
4. Сценарий вашей компании
На обезличенной копии запускайте типовые операции, тяжёлый отчёт, закрытие месяца и обмены с ожидаемой параллельностью. Измерьте время, p95 при достаточном числе повторов, ошибки, блокировки и Apdex с заранее заданным порогом T. Порог назначает бизнес для конкретной операции: нельзя сравнивать Apdex с разными T.
Результат в IOPS требует условий: 100 000 IOPS по 4 KiB соответствуют примерно 390,6 MiB/с, а не 100 000 МБ/с. Высокая очередь может дать больше IOPS и хуже отклик пользователя. Средняя задержка скрывает хвост, а «1 мс хорошо всем» не является универсальным критерием.
Пример сетевого теста в согласованном стенде
На узле репозитория с отдельным тестовым адресом запустите iperf3, ограничив доступ к порту 5201 нужным источником. Сначала одно соединение, затем несколько:
# На тестовом принимающем узле
iperf3 -s -B 192.0.2.20 -1
# На тестовом источнике, пока сервер ожидает
iperf3 -c 192.0.2.20 -t 30 -P 1
Адрес из документационного диапазона замените реальным разрешённым адресом. Ключ -1 завершает сервер после теста: перед следующей проверкой запустите его заново. Сравните -P 4 и обратное направление -R. Это измерение TCP-пути между узлами, без чтения/записи backup-файла; оно не доказывает скорость резервного копирования.
Пример fio: маленькая синхронная запись на отдельном стенде
Создайте выделенный каталог /srv/io-test на тестовом файловом томе и подтвердите, что он не содержит БД. Команда создаёт/перезаписывает указанный тестовый файл: никогда не подставляйте /dev/nvme..., путь MDF/LDF, PGDATA или файл рабочей ВМ.
fio --name=loglike --filename=/srv/io-test/loglike.bin --size=2G --rw=write --bs=8k --ioengine=psync --iodepth=1 --numjobs=1 --direct=1 --fsync=1 --time_based=1 --runtime=60 --group_reportingЭто упрощённый профиль, а не эмулятор журнала СУБД. psync и очередь 1 задают последовательную работу; fsync=1 запрашивает синхронизацию после каждой записи. Смотрите отдельную статистику sync и полное время итерации, не выдавайте write clat без fsync за задержку подтверждённой транзакции. Другой профиль с большей очередью проверяет другую задачу. На занятом сервере такие испытания могут повлиять на сервисы.
Минимальный протокол сравнения
- Сохранить конфигурацию, версии, BIOS, профиль питания, заполнение дисков и здоровье SSD.
- Зафиксировать профиль теста и гарантии записи; не отключать защиту ради баллов.
- Провести прогрев и несколько одинаковых повторов, сохранить сырые отчёты.
- Сравнить CPU/частоту, память, задержки и время операции, объяснить разброс.
- Подтвердить вывод реальной задачей 1С, копией и восстановлением.
Эти команды здесь не выполнялись на сервере 1С; приложенные схемы не являются отчётами стенда. Для методики важнее воспроизводимость, чем чужая цифра без условий.
Простой калькулятор RAM, RAID, записи и окна бэкапа
Подставьте собственные измерения в калькулятор. Он рассчитывает память с запасом, место с сохранением заданной свободной доли, полезную ёмкость зеркала/RAID 10/RAID 6, DWPD и требуемую сетевую полосу. Работает в браузере без передачи данных и внешних библиотек.
Можно сохранить HTML-файл и пользоваться локально. Калькулятор не запускает бенчмарки, не выбирает число ядер и не прогнозирует количество пользователей. Он не учитывает все накладные расходы массива и файловой системы; рассчитанную ёмкость проверяют по фактическому доступному месту. Корректность исходных замеров остаётся частью инженерной работы.
Два документа перед запросом цены
Паспорт нагрузки 1С
Исходные версии, пики, объёмы, операции и требования к восстановлению.
Скачать паспорт · TXTТЗ и приёмка сервера
Комплектующие, условия теста, критерии и ответственность поставщика.
Скачать проверку · TXTПоможем выбрать ресурсы под вашу 1С
ИТ-аутсорсинг и сопровождение 1С
- Соберём исходные данные и найдём ограничения.
- Подготовим требования к серверу и приёмке.
- Согласуем перенос, мониторинг и резервирование.
Объём работ определяется после знакомства с вашей инфраструктурой.
Обсудить выбор сервераОблачные ресурсы для 1С
- Подберём CPU, память и хранилище под нагрузку.
- Сравним варианты по одинаковым сценариям.
- Согласуем лицензии, копии и сопровождение.
Стоимость и параметры фиксируем по конкретной конфигурации и условиям предоставления.
Обсудить ресурсы в облакеЧастые вопросы о выборе сервера для 1С
Сколько памяти нужно на 50 пользователей 1С?
Число пользователей не определяет объём памяти однозначно. Нужны конфигурация, параллельность, фоновые задачи, СУБД и измерение пиков. Пример 128 ГБ в статье не является нормой на 50 пользователей.
Что лучше для 1С: Xeon или EPYC?
Сравнивайте конкретные поколения и модели на одинаковой базе и сценариях. По названию семейства, частоте или числу ядер победителя определить нельзя.
Нужен ли обязательно двухпроцессорный сервер?
Нет. Второй сокет выбирают под подтверждённые ресурсы и расширение. Он усложняет топологию памяти и может влиять на лицензирование.
Надо ли всю базу помещать в RAM?
Нет универсального требования. Важен активный рабочий набор и поведение запросов. Но постоянное вытеснение полезных данных может означать нехватку памяти.
Можно поставить обычные SSD?
Для загрузки гипервизора возможны небольшие совместимые SSD. Для интенсивной БД нужны подтверждённые гарантии записи, ресурс, задержки и защита питания выбранной модели.
Зеркало заменяет резервную копию?
Нет. Оно не возвращает удалённые или зашифрованные данные и не защищает от потери всей системы. Нужны независимые копии и проверка восстановления.
Достаточно теста Гилёва для покупки?
Он помогает сравнить определённый синтетический сценарий. Приёмка дополнительно должна включать вашу конфигурацию, типовые и тяжёлые операции, параллельность и фоновые задачи.
Вы даёте готовую спецификацию с ценой?
Здесь показана методика и условные расчёты. Точная спецификация и цена требуют замеров, проверки совместимости, лицензий и актуального предложения поставщика.