
Команда du оценивает занятое файлами место. Результат может отличаться от ls, df и размера резервной копии из-за sparse-файлов, hard links, удалённых открытых файлов, снимков и особенностей файловой системы. Для диагностики нужно понять, какую величину вы ищете.
1. Размер каталога, файлов, блоков и всей ФС
У папки нет одного универсального размера
Папка хранит имена и ссылки на объекты. Поэтому ls -ld показывает размер самой структуры каталога, а не сумму документов внутри. Файл, в свою очередь, имеет логическую длину и набор выделенных блоков. Пользователь хочет узнать, сколько данных копировать, администратор — сколько места освободится, storage-инженер — сколько уникальных блоков принадлежит набору. Эти числа могут различаться.
| Величина | Чем посмотреть | Что отвечает |
|---|---|---|
| Логическая длина файла | stat -c %s file | До какого смещения файл имеет данные или «дыры» |
| Выделенные блоки файла | stat -c '%b %B' file | Число блоков и единица их учёта |
| Учтённое du место дерева | du -sx --block-size=1 -- /path | Сумма выделения для обхода дерева на одной ФС |
| Логический объём дерева | du -sx --apparent-size --block-size=1 -- /path | Объём по логическим размерам, с правилами обхода du |
| Заполненность файловой системы | df -hT -- /path | Данные всего тома, включая то, чего не видно в выбранной папке |
| Использование inode | df -i -- /path | Доступность записей файловой системы |
| Уникальное/разделяемое выделение CoW | Инструмент Btrfs/ZFS | Информация, недоступная обычной сумме длин файлов |
GNU-команды ниже проверяются для Linux с GNU coreutils. BusyBox предоставляет меньший набор опций: на Alpine, прошивке или минимальном контейнере сначала откройте du --help. Установка GNU-варианта — отдельное действие, не обязательный первый шаг.
Для одного каталога используйте summarize и human-readable. Ошибки доступа не следует скрывать бездумным перенаправлением stderr.
sudo du -sh -- /var/lib/exampleДвойной дефис завершает параметры и защищает путь, начинающийся с дефиса.
Сначала определите, какую величину измеряете
Для обычного каталога интересуют физически выделенные блоки, для передачи файла — логическая длина, для полного диска — состояние файловой системы. Поэтому du, stat и df отвечают на разные вопросы. В командах ниже /srv/appdata — пример рабочего пути, который нужно заменить проверенным каталогом.
readlink -f -- /srv/appdata
findmnt -T /srv/appdata -o TARGET,SOURCE,FSTYPE,OPTIONS
df -hT -- /srv/appdata
du -sh -- /srv/appdata
Начните без sudo. Если возникают Permission denied, отчёт du неполный; сохраните ошибки и повторяйте с повышенными правами только при наличии разрешения. Размер каталога в ls -ld — размер его структуры, а не сумма всех вложенных файлов. На активно меняющихся данных даже успешный du не является атомарным снимком.
2. Границы измерения: том, mount и контейнер
Сначала определить, что именно вы обходите
Путь /var/lib/app может быть отдельным томом, bind mount или каталогом внутри корневого раздела. Тот же текст пути в контейнере и на хосте может указывать на разные деревья. До длинного сканирования выясните ФС и точку монтирования:
findmnt -T /var/lib/app -o TARGET,SOURCE,FSTYPE,OPTIONS
df -hT -- /var/lib/app
df -i -- /var/lib/app
Пример результата: TARGET /var/lib/app, SOURCE /dev/mapper/data-app, FSTYPE xfs. Тогда измерение / не равно измерению этого data-тома. Опция du -x не пересекает границы других устройств, но не является универсальным запретом обхода всех bind mounts той же ФС. Для сложного дерева дополнительно посмотрите mount topology.
Если команда пишет Permission denied, сумма может быть неполной. Повышайте права только для согласованного дерева; не замалчивайте ошибки перенаправлением всего stderr. Файл, который растёт прямо во время обхода, также делает результат снимком с ограниченной точностью, а не транзакционным отчётом.
--max-depth=1 показывает крупные непосредственные подкаталоги. Сортируйте численно с human-readable ключом.
sudo du -xh --max-depth=1 /var/lib/example | sort -hКлюч -x не переходит на другие файловые системы.
Спускайтесь по дереву постепенно
Сначала первый уровень, затем один найденный крупный подкаталог. Это быстрее и понятнее, чем многократный обход всего /.
du -xh --max-depth=1 -- /srv/appdata | sort -h
du -xh --max-depth=1 -- /srv/appdata/uploads | sort -h
Строка самого /srv/appdata содержит итог и включает подкаталоги; складывать её с вложенными строками нельзя. sort -h понимает K/M/G, обычный sort -n для человекочитаемых единиц даст неправильное сравнение. Для расчётов используйте единые байты и сортировку по числу:
du -x -B1 --max-depth=1 -- /srv/appdata | sort -n-B1 задаёт единицу вывода один байт, но источник величины остаётся выделенными блоками. При долгом обходе сначала оцените число файлов и окно нагрузки; nice снижает приоритет CPU, а не гарантирует отсутствие влияния на хранилище.
3. Точный du и последовательный поиск большого дерева
Почему -h неудобен для расчёта и сравнения
Human-readable вывод округляет размер и меняет единицы. 1.0G не подходит как точное значение для машинного сравнения. Для отчёта можно показывать удобные единицы, а для расчёта хранить байты и время измерения.
# Общая сумма и следующий уровень; путь замените.
du -sx --block-size=1 -- /var/lib/app
du -x --max-depth=1 --block-size=1 -- /var/lib/app | sort -n
Учебный результат 2147483648 /var/lib/app означает 2 GiB в бинарном счёте. Это не обязательно 2 GB в десятичном. -s выводит итог, -x ограничивает переходы между устройствами, --block-size=1 выбирает единицу представления, а не меняет реальную физическую организацию блоков.
Обычно начинают с одного уровня, находят большую дочернюю папку и повторяют команду для неё. Такой подход даёт объяснимое дерево причин: например, /var/lib/app/cache растёт, а /var/lib/app/data стабилен. Запуск рекурсивного поиска всех файлов всего сервера создаёт больше шума и нагрузки.
Размер каталога может быть сосредоточен в одном логе или образе. Не передавайте имена с пробелами через небезопасный цикл.
sudo find /var/lib/example -xdev -type f -printf '%s\t%p\0' |
  sort -z -n |
  tail -z -n 20 |
  tr '\0' '\n'
Найдите файлы без опасного удаления
Команда find из основной инструкции сортирует логическую длину. NUL-разделители сохраняют имена с пробелами на этапе сортировки. После tr вывод снова человекочитаем и неоднозначен для имени с переводом строки; не подавайте его напрямую в rm.
Для адресного поиска больших файлов:
find /srv/appdata -xdev -type f -size +1G -printf '%s\t%p\n'Это список кандидатов, не список разрешённых удалений. Сверьте owner, время и назначение каждого файла через stat -- путь. Большой образ VM, активная база или WAL могут быть необходимы. Для машинной автоматизации сохраняйте -print0 и обрабатывайте NUL, а для очистки используйте штатную процедуру владельца данных.
4. Крупные файлы, inode и формат вывода
Поиск больших файлов: длина, inode и выделение
# GNU find: файл, inode, длина в байтах; табличный вывод для просмотра.
find /var/lib/app -xdev -type f -size +500M -printf '%i\t%s\t%p\n'
# GNU stat для одного выбранного файла:
stat -c 'inode=%i links=%h size=%s blocks=%b block_unit=%B' -- /var/lib/app/example.dat
-size +500M использует семантику размера GNU find и округление его единиц; это поиск кандидатов, а не точный финансовый отчёт. Имя файла может содержать табуляцию или перевод строки, поэтому такой текстовый вывод предназначен человеку и не должен подаваться в команду удаления. Для автоматической обработки используйте NUL-разделение, как в примере ниже в статье.
Поле links помогает заметить hard links: два имени могут ссылаться на один inode. Удаление одного имени при существовании другого не освобождает блоки. Сравнивайте inode внутри одной ФС: одинаковый номер inode на двух разных томах не означает один файл.
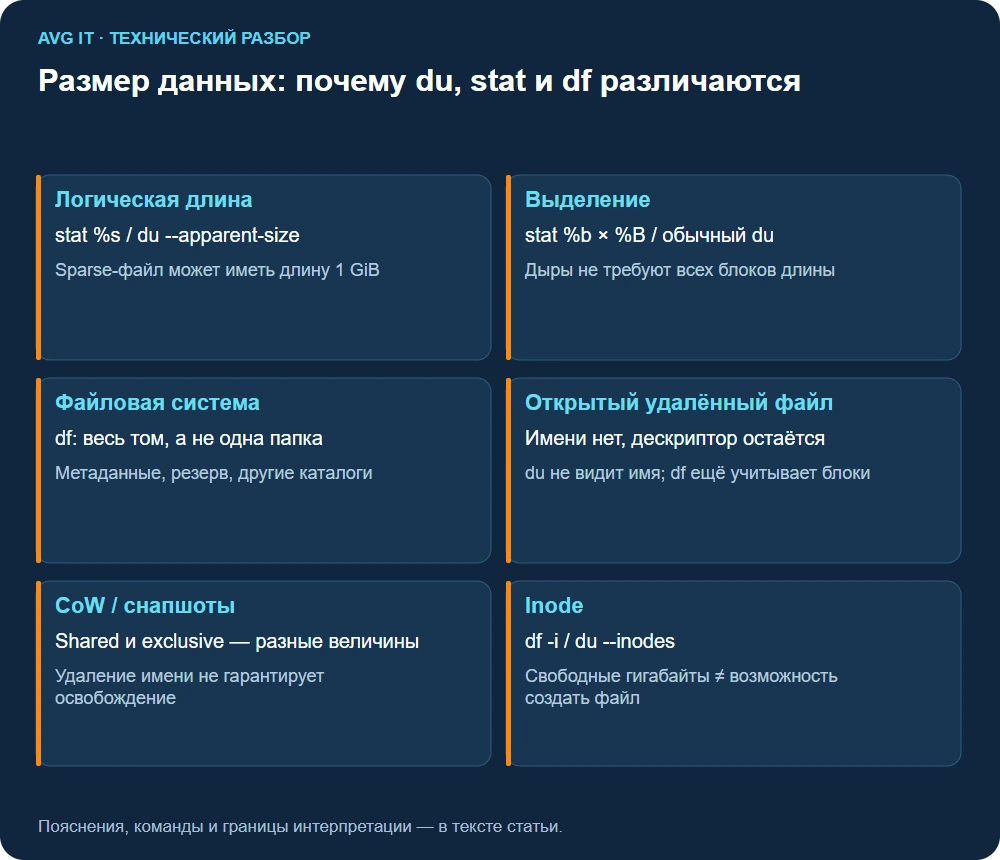
Обычный du считает занятые блоки. du --apparent-size оценивает логический размер. Sparse-файл может иметь большой apparent size и занимать мало блоков.
du -h big.img
du -h --apparent-size big.img
stat big.img
Учебный sparse-файл в отдельном временном каталоге
Следующий опыт создаёт только новый пустой файл в собственном mktemp-каталоге, не трогает production-данные:
lab_dir=$(mktemp -d)
truncate -s 1G "$lab_dir/sparse.img"
stat -c 'bytes=%s blocks=%b block_unit=%B' "$lab_dir/sparse.img"
du -h -- "$lab_dir/sparse.img"
du -h --apparent-size -- "$lab_dir/sparse.img"
На обычной поддерживающей sparse файловой системе logical size будет 1073741824 байта, а выделенных блоков — мало или ноль. %b×%B даёт выделенный объём по stat; %s — логическую длину. Реальный результат зависит от FS. Копирование без сохранения sparse может выделить весь гигабайт; предварительное резервирование, компрессия и CoW тоже меняют расход. После опыта удалите только созданный файл и пустой каталог, сверив путь, без рекурсивной очистки общего /tmp.
5. Логическая длина и sparse-файлы
Sparse file: почему огромный файл занимает мало места
Sparse-файл хранит логическую «дыру» без выделения каждого блока. Виртуальный диск может иметь логическую длину 100 GiB, но содержать только 8 GiB записанных данных. du --apparent-size ближе к длине, обычный du — к учтённому выделению. При копировании инструментом без сохранения sparse-структуры расход на целевом диске может резко вырасти.
Тест ниже создаёт новый файл в отдельной временной папке, не меняет рабочие данные и не заполняет гигабайт физическими данными:
lab_dir=$(mktemp -d)
truncate -s 1G "$lab_dir/sparse-demo.img"
stat -c 'length=%s allocated_blocks=%b unit=%B' "$lab_dir/sparse-demo.img"
du -h -- "$lab_dir/sparse-demo.img"
du -h --apparent-size -- "$lab_dir/sparse-demo.img"
printf 'Temporary example: %s\n' "$lab_dir"
На поддерживающей sparse ФС логическая длина будет 1073741824 байта, а выделение может быть нулевым или небольшим. Конкретные блоки зависят от ФС. Этот файл не является корректным образом гостевой ОС: он только демонстрирует размер. Удалите созданный тестовый файл и пустую папку после проверки. GNU stat.
df показывает использование файловой системы целиком, а du — достижимые файлы. Если df занят сильнее, ищите удалённые, но открытые файлы и snapshot/reserved blocks.
df -hT /var/lib/example
sudo lsof +L1
Не перезапускайте процесс только ради освобождения файла без оценки сервиса.
Почему df больше суммы видимых файлов
Если процесс удалил лог, но продолжает держать его открытым, inode и блоки остаются занятыми до закрытия последней ссылки/дескриптора. du уже не найдёт путь, df продолжит считать занятое. lsof +L1 ищет открытые файлы с числом ссылок меньше 1.
sudo lsof -nP +L1Смотрите PID, FD, SIZE/OFF, устройство и имя с deleted. Не суммируйте все строки как независимые файлы: один inode может быть открыт несколькими процессами. Проверьте, относится ли устройство к исследуемой FS. Не выполняйте truncate /proc/PID/fd/N на неизвестном дескрипторе: можно повредить рабочие данные. Для логов согласуйте reopen/rotation конкретного сервиса. Для БД используйте штатные методы обслуживания.
Другие причины расхождения: snapshots, метаданные, зарезервированные блоки, inaccessible directories и данные, скрытые более поздним mount. Последний случай исследуют на отдельном mount namespace/в окне обслуживания, не размонтируя production-путь вслепую. lsof — первичная man-страница.
6. Почему df и du дают разные цифры
df заполнен, а du не видит данные: четыре причины
Первая причина — удалённый файл всё ещё открыт процессом. Имя исчезло из дерева, но inode и блоки остаются, пока существует ссылка открытого дескриптора. lsof +L1 помогает найти такие объекты. Несколько строк для одного inode могут отражать несколько дескрипторов одного файла, их размеры нельзя складывать как независимые файлы.
Вторая — данные скрыты последующим mount: каталог содержал файлы, сверху смонтировали другой том. Обычный обход видит верхний слой. Для просмотра нижнего содержимого нужна отдельная аккуратная процедура в согласованной среде, а не размонтирование активного production-тома.
Третья — резервирование, метаданные и снапшоты. df описывает всю ФС, а du — обход доступного дерева. Четвёртая — измерения в разных mount namespaces, например host и контейнер. Путь и время должны быть сопоставимыми, иначе спор двух чисел бессмысленен.
При открытом удалённом логе сначала определите владеющую службу и штатный способ reopen/rotation. Перезапуск общей БД ради освобождения файла без оценки транзакций — другой риск. Прямое обнуление /proc/PID/fd/N не является безопасной общей рекомендацией.
Миллионы маленьких файлов могут исчерпать inode при свободных гигабайтах.
df -ih /var/lib/example
sudo du -x --inodes --max-depth=1 /var/lib/example | sort -n
Inode: свободные гигабайты не всегда спасают
Если df -h показывает место, а запись отвечает No space left on device, проверьте df -i и квоты. Миллионы небольших файлов могут исчерпать inode. На FS с динамическими inode смысл и ограничения отличаются; интерпретируйте результат по типу FS.
du --inodes --max-depth=1 показывает количество учитываемых inode в дереве. Разбейте результат по каталогам spool/cache/session и определите владельца. Не удаляйте все session-файлы, если это сорвёт работающие входы. Отдельно проверяйте user/project quota: общий df может быть свободен, а лимит конкретного пользователя уже исчерпан. Команды quota зависят от включённой модели и FS, поэтому сначала определите её через findmnt и документацию.
7. Количество файлов и исчерпание inode
Миллион маленьких файлов: заканчивается не только объём
Для каждого файла требуется inode и метаданные. На некоторых ФС доступные inode задаются при создании тома; свободные гигабайты не гарантируют возможность создать ещё файл. Очередь, кеш сессий или почтовый spool способны исчерпать inode раньше блоков.
df -i -- /var/lib/app
# GNU du: приблизительная локализация по количеству inode.
du -x --inodes --max-depth=1 -- /var/lib/app | sort -n
Посмотрите колонку IUse% и крупные каталоги во втором выводе. Не трактуйте показатель одинаково для всех ФС: некоторые выделяют inode динамически. Удаление миллиона файлов может быть длительной тяжёлой операцией; решение зависит от назначения файлов, retention и нагрузки на метаданные, а не только от команды find.
По умолчанию du не считает один и тот же inode повторно. На Btrfs/ZFS/reflink логические файлы могут делить блоки. Поэтому сумма каталогов не всегда равна физическому расходу.
Hard links, symlinks и разделяемые блоки
Несколько hard links ссылаются на один inode. Обычный du считает его один раз в одном обходе; отдельные вызовы du для разных каталогов способны посчитать общие данные каждый в своей сумме. du -l намеренно считает hard links повторно и для физического расхода обычно не нужен. У symlink по умолчанию считается сама ссылка; du -L начинает следовать целям и может выйти далеко за ожидаемую область.
CoW/reflink и snapshot не равны hard links: разные inode разделяют экстенты. Обычный du не показывает точный эксклюзивный расход. Для Btrfs используйте штатную оценку FS и snapshots, для ZFS — dataset used, referenced, снимки и compression. Сумма логических размеров VM не равна месту, которое освободится при удалении одного файла.
8. Hard links, CoW, Btrfs, ZFS и снапшоты
Hard link, reflink и снапшот освобождают место по-разному
Hard links имеют общий inode. Reflinks имеют разные inode, но могут разделять экстенты данных. Снапшот CoW сохраняет ссылки на старые блоки после удаления файла из текущего дерева. Поэтому сумма du нескольких деревьев может переоценивать физическое выделение, а удаление большого файла из live-набора не обязательно сразу освободит его блоки.
Для Btrfs, при подходящих правах:
sudo btrfs filesystem usage /data
sudo btrfs filesystem du -s /data/app
Команды предполагают, что /data — Btrfs. Смотрите разделение total/exclusive/shared и ограничения конкретной версии инструмента. Для ZFS, если установлен его стек:
zfs list -o name,used,available,referenced,mountpoint
zfs list -t snapshot -o name,used,referenced
used и referenced относятся к dataset и его учёту, а не обычной длине папки. Удаление снапшота меняет возможность возврата; эта статья предлагает диагностику, а не автоматическое уничтожение истории. Btrfs filesystem, ZFS list.
Перед глубоким обходом посмотрите findmnt. Ключ -x удерживает du в одной файловой системе и предотвращает случайный обход NFS, backup или proc.
findmnt -R /var/lib/example
sudo du -xsh /var/lib/example
Ограничение одной FS имеет границы
-x ограничивает переходы на другие filesystem, но не является полной защитой от bind mounts той же FS. Проверяйте mount-дерево и избегайте подкаталогов, которые не относятся к задаче.
findmnt -T /srv/appdata
findmnt -R /srv
Если исходный каталог не является mountpoint, findmnt -R с ним может не показать ожидаемое дерево; запросите содержащую точку монтирования. Нельзя считать пустой вывод доказательством отсутствия вложенных mount. Для одного конкретного нежелательного дерева GNU du поддерживает --exclude, но исключение означает неполный итог: пометьте его в отчёте. findmnt — выбор точки и рекурсивный вывод.
9. Поиск источника роста и штатная очистка
Практический случай: место исчезает каждый день
Сегодня du показывает 40 GiB, завтра — 44 GiB. Запишите два измерения одного пути, с одинаковыми ключами и ошибками доступа. Разница 4 GiB за сутки — средняя скорость по этому интервалу, а не доказательство постоянного роста. Приложение могло создать backup ночью и удалить его позже.
Сопоставьте время с расписанием backup, logrotate, загрузками пользователей и контейнерными образами. На сервере БД отдельно учитывайте журналы транзакций и основной data-набор; удалять WAL/binlog как «старые файлы» без штатной процедуры нельзя. На контейнерном хосте проверяйте слои, volumes и логи по инструментам платформы, а не удаляйте случайные каталоги /var/lib.
Сначала назначение и владелец данных, потом выбранная процедура очистки. Сам du ничего не удаляет и не оценивает бизнес-ценность найденных файлов.
Однократный снимок не показывает источник роста. Снимайте одинаковую команду по расписанию, храните timestamp и сравнивайте топ каталогов. Не запускайте частый полный du на нагруженном storage.
Снимок роста с неизменными условиями
Выполните в Bash один снимок и повторите позднее с тем же каталогом и единицами:
set -o pipefail
printf 'Captured UTC: %s\n' "$(date -u '+%Y-%m-%dT%H:%M:%SZ')"
du -x -B1 --max-depth=1 -- /srv/appdata | sort -n
pipefail не позволяет успешному sort скрыть ошибку du, но команда всё равно может напечатать неполные числа: проверьте exit status и stderr. Для автоматизации сохраняйте timestamp, mount/source, единицы и ошибки. Сравнивайте одни и те же пути; рост общего объёма при смене mount не доказывает рост приложения. Учитывайте ротацию, snapshots, завершение backup и удаление данных между замерами.
10. Проверка результата и повторяемый отчёт
Не удаляйте крупное вручную, пока не определён сервис. Для журналов используйте logrotate/journal retention, для пакетов — менеджер пакетов, для БД — штатную очистку. После изменения повторите du, df и проверку приложения.
Приёмка освобождения места
Сначала согласуйте перечень и retention с владельцем. Для БД проверяйте штатное обслуживание и свободное место для операции; DELETE не обязательно немедленно возвращает блоки ОС. Для контейнеров используйте процедуры платформы, а не удаление внутренних каталогов runtime. Для журналов настройте ротацию и retention вместо ежедневной ручной зачистки.
После операции повторите du, df, inode/квоты и проверку сервиса. Запишите, сколько физического места появилось и не продолжается ли рост. Диагностические команды этой статьи сами не удаляют рабочие данные. Возврат очистки возможен только из заранее проверенной копии/снимка с учётом консистентности приложения; наличие вывода du не является backup. GNU du — параметры в Debian.
Источники: GNU Coreutils — du, GNU Coreutils manual.