
fsck — не универсальный CHKDSK и не средство диагностики физического здоровья накопителя. Сначала определяют устройство, файловую систему и состояние данных, затем делают копию и выбирают проверку конкретного формата. Запуск ремонта на смонтированном разделе может усугубить повреждение.
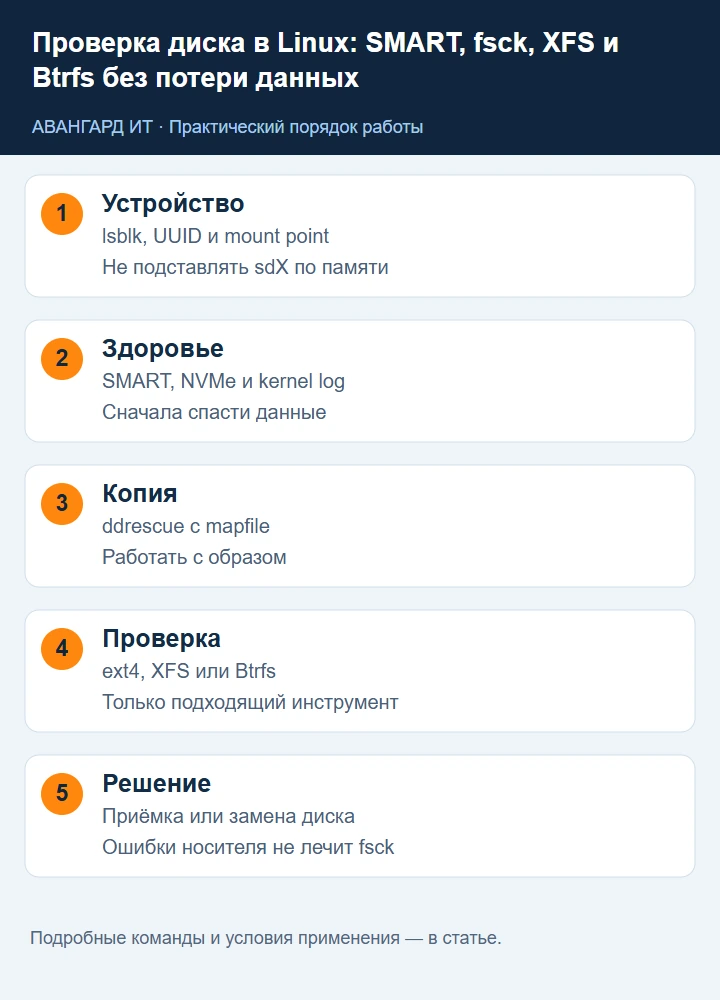
1. Определите устройство и точку монтирования
Не подставляйте /dev/sdX по памяти. Сопоставьте модель диска, раздел, UUID, тип файловой системы и mount point. Для LVM, RAID и шифрования физический диск и проверяемое логическое устройство различаются.
lsblk -o NAME,MODEL,SERIAL,SIZE,FSTYPE,UUID,MOUNTPOINTS
findmnt -o SOURCE,TARGET,FSTYPE,OPTIONS
sudo blkid
Сохраните вывод. Ошибка в имени устройства — главная опасность любых дисковых команд.
Подготовка инструментов и границы проверки
Практический пример относится к Debian/Ubuntu с GNU coreutils, util-linux, e2fsprogs, smartmontools и профильными инструментами. В rescue-среде пакеты и сеть могут отсутствовать: подготовьте носитель и инструменты до окна. Установка пакетов на нестабильный системный диск создаёт записи; при подозрении на отказ загрузитесь с отдельного носителя. На исправном учебном хосте пакеты устанавливают так:
sudo apt-get update
sudo apt-get install smartmontools nvme-cli e2fsprogs xfsprogs btrfs-progs gddrescue lvm2 cryptsetup
command -v smartctl nvme e2fsck xfs_repair btrfs ddrescue
Последняя строка должна вывести пути существующих программ. Отсутствие nvme не мешает проверке SATA, но отсутствие e2fsck блокирует выбранный ext4-сценарий. На RAID-контроллере SMART физического диска может требовать параметр типа устройства, например режима контроллера: не считайте пустой отчёт подтверждением здоровья. smartctl --scan-open помогает определить поддерживаемый доступ. Для виртуальной машины SMART гостевого диска обычно не отражает здоровье физического пула; проверяйте гипервизор и хранилище отдельно.
Как понять цепочку физический диск → раздел → LUKS → LVM → ext4
При шифровании /dev/nvme0n1p3 может содержать LUKS, а не ext4. После открытия контейнера появляются device-mapper устройства; внутри них может находиться PV LVM с несколькими LV. Файловую систему проверяют на последнем логическом слое. Нельзя запускать e2fsck на шифрованном разделе, физическом PV или собранном RAID-компоненте вместо тома.
lsblk -o NAME,TYPE,FSTYPE,SIZE,UUID,MOUNTPOINTS
sudo pvs
sudo vgs
sudo lvs -o lv_name,vg_name,lv_path,lv_size
sudo cryptsetup status cryptdata
Пример ожидаемой цепочки: nvme0n1p3 типа part, FSTYPE crypto_LUKS; cryptdata типа crypt, FSTYPE LVM2_member; vg_data-lv_data типа lvm, FSTYPE ext4. Именно /dev/mapper/vg_data-lv_data передают e2fsck. Если rescue не активировал тома, сначала откройте подтверждённый LUKS-контейнер штатным секретом и активируйте нужную VG. Эти действия не форматируют устройство, но требуют точного имени. Не выполняйте mkfs, pvcreate или cryptsetup luksFormat для «восстановления видимости» старого тома.
2. Проверьте физическое состояние до fsck
Для SATA/SAS/NVMe снимите SMART/NVMe-данные. Растущие media errors, pending sectors или критические предупреждения означают, что приоритетом становится образ, а не многократный ремонт файловой системы.
sudo smartctl -x /dev/sdX
sudo nvme smart-log /dev/nvme0
sudo dmesg --level=err,warn | tail -n 100
fsck не исправляет деградирующую память или механику. При ошибках чтения используйте отдельный носитель и стратегию копирования.
Как читать SMART и почему PASSED недостаточно
В SATA-отчёте полезны Reallocated Sector Count, Current Pending Sector, Offline Uncorrectable и ошибки интерфейса. Названия, шкалы и значение RAW зависят от производителя. Растущий CRC error count при стабильных показателях носителя может указывать на кабель или тракт SATA; растущие pending/uncorrectable вместе с I/O errors — на проблемы чтения. Сравнивайте с предыдущим отчётом, температурой и журналом, а не только строкой общего статуса.
Для NVMe смотрите Critical Warning, Available Spare, Percentage Used, Media and Data Integrity Errors и Error Information Log Entries. Percentage Used оценивает израсходованный ресурс; это не вероятность отказа в процентах. Счётчик ошибок журнала тоже требует контекста: не каждая запись означает потерю пользовательских данных. Критическое предупреждение, исчезновение устройства и ошибки чтения важнее общего «здоров».
На исправном диске короткий самотест помогает получить дополнительный факт:
sudo smartctl -t short /dev/sdX
# Выждите время, которое указала сама программа.
sudo smartctl -l selftest /dev/sdX
В столбце результата ожидается завершение без ошибки, а не «in progress». На деградирующем диске не начинайте длительный тест до спасения данных: он потребляет ресурс и время чтения. Хороший SMART не исключает отказ контроллера, питания, USB-моста или файловой системы.
3. Сделайте резервную копию или образ
Если данные важны, остановите запись и создайте проверяемую копию. Для нестабильного диска предпочтителен ddrescue с mapfile, чтобы продолжать чтение, а не начинать заново. Работайте с копией, когда это возможно.
sudo ddrescue --force --no-scrape /dev/sdX /mnt/recovery/disk.img /mnt/recovery/disk.map
sha256sum /mnt/recovery/disk.img > /mnt/recovery/disk.img.sha256
Целевой диск должен быть другим физическим устройством и иметь достаточно места.
Безопасная работа с образом и журналом ddrescue
Перед запуском проверьте свободное место df -h /mnt/recovery и убедитесь по findmnt, что каталог образа находится на другом носителе. Размер файла образа приближается к размеру исходного устройства, а не только занятому месту. Для образа всего диска нужны также место для рабочей копии и восстановленных файлов. Mapfile храните рядом и включайте в резервирование.
Первый проход --no-scrape старается получить читаемые области без долгого выскребания плохих секторов. Не добавляйте бесконечные повторы при физическом отказе. После копирования сохраните исходный образ, а ремонтируйте отдельный рабочий экземпляр:
cp --reflink=auto /mnt/recovery/disk.img /mnt/recovery/disk-work.img
sudo losetup --find --show --partscan /mnt/recovery/disk-work.img
# Пример выведенного имени: /dev/loop0
lsblk -f /dev/loop0
Reflink ускоряет копирование только на поддерживающей его файловой системе. Если образ был всего диска, проверяют нужный loop0pN; если образ самого LV с ext4, разделов внутри может не быть, и проверяют loop0. Определите это по lsblk, не создавайте таблицу разделов поверх образа. После анализа отмонтируйте все его разделы и выполните losetup -d для фактически полученного loop-устройства. Исходный образ и mapfile не удаляют после первого успешного запуска.
4. Отмонтируйте файловую систему
fsck обычно запускают на отмонтированной файловой системе. Остановите сервисы, использующие каталог, проверьте открытые файлы и отмонтируйте раздел. Для корневой системы загрузитесь в rescue/live-среду.
sudo fuser -vm /srv/data
sudo systemctl stop example.service
sudo umount /srv/data
findmnt /srv/data || true
Не используйте -f, чтобы обойти защиту от проверки используемого устройства.
5. Проверьте ext4 сначала без изменений
fsck является оболочкой для файловых проверяющих. Для ext2/3/4 используйте e2fsck. Ключ -n отвечает «нет» на изменения и подходит для первичной оценки.
sudo e2fsck -fn /dev/mapper/vg_data-lv_data
status=$?
printf 'e2fsck exit=%s\n' "$status"
Коды 0, 1, 2, 4 имеют разный смысл; не трактуйте любой ненулевой код как одинаковую аварию. Ремонт e2fsck -f выполняйте после копии и в окно обслуживания.
Коды e2fsck и решение о следующем шаге
Коды являются битовой маской: 0 — ошибок нет; 1 — исправления сделаны; 2 — исправления требуют перезагрузки; 4 — ошибки остались; 8 — ошибка выполнения; 16 — неверные аргументы; 32 — отмена; 128 — ошибка общей библиотеки. Возможна сумма битов. Проверка с -n оставляет обнаруженные ошибки неисправленными, поэтому ненулевой результат ожидаем и требует чтения отчёта.
Флаг -f принуждает проверку даже при отметке clean, а -n запрещает согласие на исправления. Для actual repair после резервирования используйте интерактивный e2fsck -f, читайте предложенные изменения и сохраняйте отчёт. Безусловный -y не является безопасным универсальным рецептом. Повторная офлайн-проверка после ремонта должна дать согласованный результат. Если сообщения меняются случайно или появляются I/O errors, возвращайтесь к проверке носителя, памяти и тракта хранения.
6. Для XFS используйте xfs_repair
XFS не ремонтируют fsck.xfs: эта команда фактически сообщает, что журнал проигрывается при монтировании. Для офлайн-диагностики используйте xfs_repair -n, затем оцените вывод и резервную копию.
sudo xfs_repair -n /dev/mapper/vg_data-lv_xfs
# После подтверждённой копии и решения о ремонте:
sudo xfs_repair /dev/mapper/vg_data-lv_xfs
Ключ -L очищает журнал и может потерять метаданные; его нельзя добавлять как универсальное решение.
7. Для Btrfs разделяйте scrub и check
scrub проверяет контрольные суммы на смонтированной файловой системе и при наличии избыточности может восстановить повреждённые копии. btrfs check проверяет структуру; по умолчанию используйте read-only. Официальное руководство предупреждает не применять --repair без рекомендации специалиста.
sudo btrfs scrub start -Bd /srv/btrfs
sudo btrfs scrub status /srv/btrfs
sudo umount /srv/btrfs
sudo btrfs check --readonly /dev/mapper/vg_data-lv_btrfs
8. Не запускайте разрушающий badblocks на данных
Официальная man-страница предупреждает: badblocks -w записывает шаблоны во все блоки и стирает данные. Для ext-файловой системы рекомендуется вызывать badblocks через e2fsck -c, а не напрямую. Даже «неразрушающий» тест создаёт нагрузку и не заменяет SMART.
# Только после резервной копии, на отмонтированном ext-разделе:
sudo e2fsck -f -c /dev/sdX1
На SSD/NVMe при медиаошибках обычно планируют замену накопителя, а не ведут список bad blocks.
9. Проверьте корневую систему в rescue-режиме
Для / запланируйте окно и загрузку с recovery/live-среды. Устаревший трюк /forcefsck работает не во всех современных системах. Надёжнее определить реальное устройство, убедиться, что оно не смонтировано на запись, и вызвать проверяющий инструмент вручную.
findmnt /
lsblk -f
# Команда ремонта выполняется из rescue после проверки устройства.
Снимок виртуальной машины не заменяет согласованную резервную копию приложения и базы данных.
Rescue корневого тома и особенности read-only
В live-среде отключите автоматическое монтирование рабочего диска. Проверьте findmnt для каждого целевого устройства; текущая / принадлежит live-среде и не говорит о состоянии установленной системы. Установленный root часто смонтирован в /target или /mnt; его необходимо отмонтировать перед ремонтом. Перед этим остановите процессы, откройте другую рабочую директорию и проверьте вложенные mount points.
Read-only mount ext4 может воспроизвести журнал. Если цель — исключить запись при изучении повреждённой копии, используйте ro,noload для ext4; отказ от replay может показать несогласованное состояние. Для XFS соответствующая диагностическая опция — ro,norecovery, также с ограничениями согласованности. Не копируйте эти опции между форматами. После ремонта штатное монтирование и replay выполняют по принятому регламенту.
На Btrfs режим scrub и структура — разные задачи. Для обычного обслуживания исправной зеркальной системы scrub может исправлять плохую копию из хорошей. Для расследования, где нужна гарантия отсутствия записи, учитывайте: read-only scrub на read-write смонтированной системе не обеспечивает абсолютного отсутствия внутренних записей. Требуется read-only mount или работа на копии. Счётчик uncorrectable после scrub требует восстановления конкретных данных из резервной копии; произвольный --repair не создаст отсутствующую хорошую копию.
10. Примите результат и решите судьбу диска
После ремонта смонтируйте систему сначала read-only, проверьте журналы и контрольные файлы, затем верните сервис. Повторяющиеся ошибки, новые SMART-события или I/O errors — основание заменить накопитель.
sudo mount -o ro,noload /dev/mapper/vg_data-lv_data /mnt/check
sudo journalctl -k -b | grep -Ei 'i/o error|filesystem|nvme|ata'
sha256sum -c /mnt/recovery/critical.sha256
Источники: fsck(8), e2fsck(8), badblocks(8), btrfs check.
Дополнительная документация: Btrfs scrub: документация, Btrfs check: документация, GNU ddrescue: руководство.
Нужна диагностика диска без риска для данных?
Перед исправлением файловой системы важно оценить состояние накопителя и сохранить критичные данные.