
Маркировка Tier помогает обсуждать инфраструктуру дата-центра на языке проверяемых возможностей: какие компоненты можно обслуживать без остановки ИТ-нагрузки и что произойдёт при отказе. Для администратора, архитектора и заказчика это полезнее количества генераторов в презентации. Два ИБП ещё не доказывают независимость питания, два ввода — независимость всей цепи, а высокий уровень ЦОД сам по себе не сохраняет работоспособность приложения с единственным сервером базы данных.
В статье разобраны определения Uptime Institute, расчёт резервной мощности, схемы A/B, охлаждение, сертификаты и практический порядок проверки площадки. Примеры топологии и расчётов учебные: по ним нельзя присвоить объекту Tier. Переключения инженерного оборудования выполняет персонал ЦОД по согласованной процедуре; команды для системного администратора ниже ограничены сбором данных и наблюдением за ИТ-сервисами.
1. Что оценивает Tier и почему он появился
Классификация Uptime Institute возникла как способ сопоставить возможности инженерной инфраструктуры разных площадок. Она описывает результат работы топологии, а не обязательную марку ИБП, конкретную схему генераторов или единственный допустимый проект. В основе — критическая нагрузка, обеспечивающие её компоненты и пути распределения ресурсов. Официальная точка входа: система Tier Uptime Institute.
Для практического анализа разделите три слоя. Первый — физическая площадка: питание, охлаждение и их обеспечивающие подсистемы. Второй — ИТ-инфраструктура: серверы, сеть, хранилища, гипервизоры. Третий — приложение: балансировка, база данных, очереди, DNS, внешние зависимости. Сертификация инженерной площадки не подменяет проверку всех трёх слоёв и не означает, что сервис переживёт ошибку администратора БД.
Предположим, ЦОД допускает обслуживание ИБП без отключения стоек. У клиента при этом один коммутатор доступа и один сервер приложения. Работы с ИБП могут пройти незаметно, а отказ коммутатора остановит сервис. Это два разных риска, требующих разных технических мер. Аналогично второй сервер в той же стойке не устраняет общий PDU, общий канал охлаждения или общий кабельный ввод.
Отдельный важный термин — топология. Это не просто перечень оборудования, а связи между ним: каким путём энергия доходит до блока питания, через какие элементы подаётся холод, что управляет переключением, какие зависимости остаются общими. Именно анализ связей объясняет, почему два одинаковых набора устройств иногда дают меньше устойчивости, чем ожидает заказчик.
2. Tier I, II, III и IV: различия в поведении площадки
Главное различие Tier III и Tier IV — плановое обслуживание против реакции на отказ. Чтобы без остановки обслужить компонент, персонал может заранее перераспределить нагрузку, выполнить переключения и проверить резерв. При внезапном повреждении такого времени может не быть. Поэтому ремонтопригодность без отключения и отказоустойчивость — разные свойства.
| Уровень | Основное свойство | Как понимать практически | Что нельзя выводить из обозначения |
|---|---|---|---|
| Tier I | Базовая инфраструктурная мощность | Для обслуживания или ремонта отдельных частей может требоваться остановка площадки | Наличие ИБП не означает возможность его обслуживания без простоя |
| Tier II | Резервные компоненты мощности | В системе есть резерв, но распределительные пути могут оставаться уязвимыми | N+1 оборудования не устраняет общий распределительный элемент |
| Tier III | Concurrently Maintainable: обслуживание без остановки критической нагрузки | Каждый необходимый компонент мощности и распределительный путь можно планово вывести из работы | Плановая ремонтопригодность не гарантирует отсутствие влияния любого внезапного отказа |
| Tier IV | Fault Tolerant: отказоустойчивость | Дополнительно обеспечивается устойчивость к отдельному отказу оборудования или нарушению распределительного пути в рамках требований стандарта | Это не защита от любых одновременных аварий, катастроф или ошибок приложения |
Определения приведены по описанию классов и сертификации Uptime Institute. Tier IV включает свойство плановой ремонтопригодности. При этом таблица не заменяет нормативный стандарт и программу испытаний конкретного объекта: границы отказа, изоляция и особенности оборудования требуют инженерной проверки.
Практическая ошибка — называть Tier III «любое оборудование можно выключить в любой момент». Плановый вывод предполагает установленный порядок и допустимое исходное состояние. Например, резерв уже может быть занят ремонтом другого компонента. Перед новой работой требуется проверить текущую конфигурацию, мощность и ограничения. Возможность обслуживания в предусмотренном режиме не разрешает произвольные одновременные переключения.
Ещё одна ошибка — присваивать Tier по формуле резервирования: «N+1 — Tier III, 2N — Tier IV». Такие схемы говорят о мощности, но не показывают весь путь и его общие зависимости. Финальная оценка относится к работоспособности топологии, а не к одному арифметическому признаку.
3. N, N+1 и 2N: как считать резервную мощность
N — мощность или количество работающих компонентов, необходимые для заданной нагрузки при заданных условиях. N+1 — один дополнительный компонент сверх необходимого числа. 2N — две мощности, каждая из которых способна обеспечить требуемую нагрузку. В реальном проекте нужно уточнить, к какой подсистеме относится обозначение: ИБП, чиллеры, насосы, генераторы или отдельный распределительный участок.
Учебный пример: критическая нагрузка составляет 240 кВт. Каждый модуль способен отдать 100 кВт номинально, но принятая для данного расчёта допустимая мощность — 90 кВт. Это условие примера, а не универсальный коэффициент для оборудования. Производитель и проект должны подтвердить реальные ограничения по температуре, режиму, высоте, коэффициенту мощности и другим условиям.
Требуемая нагрузка: 240 кВт
Допустимая мощность модуля в рассматриваемом режиме: 90 кВт
N = округление вверх(240 / 90) = 3 модуля
Мощность N: 3 × 90 = 270 кВт
N+1: 4 модуля, всего 360 кВт
После вывода одного: 3 × 90 = 270 кВт >= 240 кВт
После вывода двух: 2 × 90 = 180 кВт < 240 кВт
Последняя строка объясняет важное ограничение: один резервный модуль не обеспечивает одновременно обслуживание одного и потерю ещё одного, если оставшейся мощности недостаточно. Для такого сценария требуется другая конфигурация или меньшая нагрузка. Не объявляйте это универсальным нормативным требованием Tier: сначала определите требуемый сценарий и применимую методику.
| Проверка | Какой вопрос задать | Что использовать в расчёте |
|---|---|---|
| Установленная мощность | Что написано на шильдиках? | Только как исходные данные |
| Доступная мощность | Что реально допустимо в проектном режиме? | Derating, ограничения производителя, качество питания |
| Мощность после отключения | Сколько остаётся при обслуживании или отказе? | Реально доступные независимые компоненты |
| Перераспределение | Не перегрузится ли кабель, автомат, PDU или другой ввод? | Нагрузка каждого участка после перехода |
| Рост | Хватит ли резерва при следующем расширении? | Согласованный прогноз и эксплуатационный запас |
Не смешивайте кВт и кВА. КВт — активная мощность, кВА — полная. При условном коэффициенте мощности 0,9 нагрузка 240 кВт соответствует примерно 266,7 кВА. Оборудование может иметь отдельные ограничения по обеим величинам. Аналогично мощность стойки нужно проверять вместе с током, фазами и допустимым режимом распределения, а не только по сумме паспортных блоков питания.
Полезная форма результата — расчёт для каждого состояния: штатный режим, один компонент в обслуживании, выбранный одиночный отказ, возврат. Если расчёт покрывает лишь штатный режим, утверждение о резерве ещё не проверено.
4. Питание A/B: проследите путь до каждого сервера
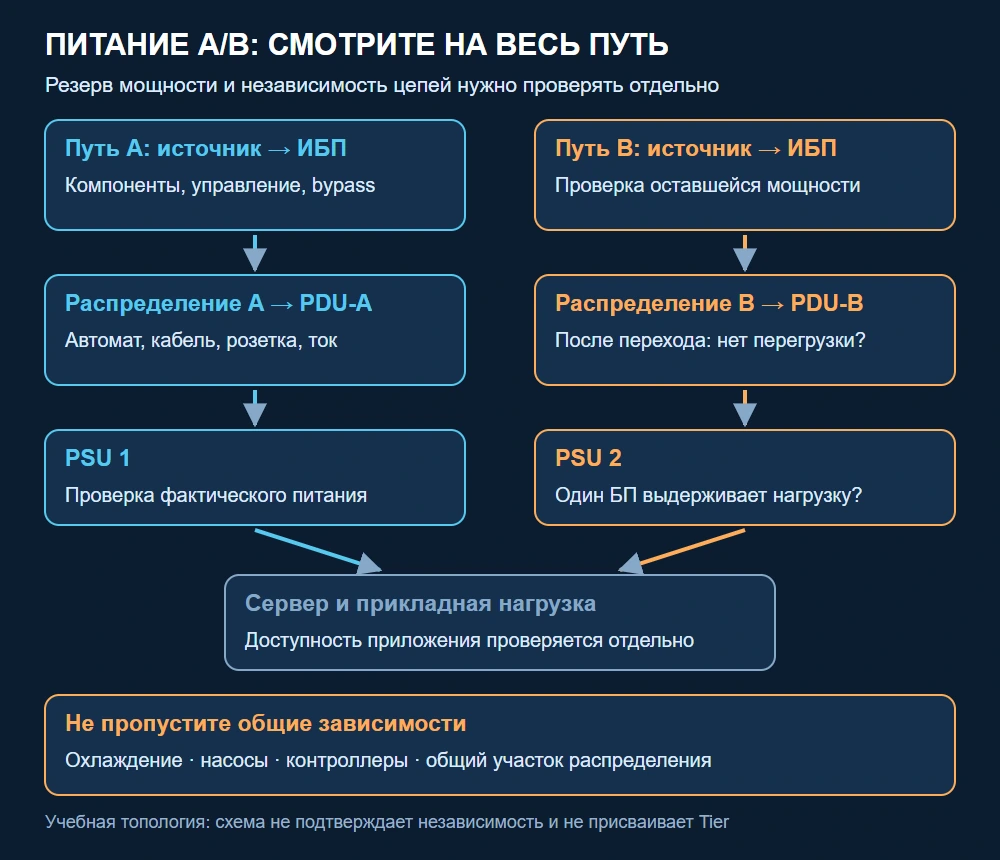
PDU (Power Distribution Unit) распределяет питание в стойке; PSU (Power Supply Unit) — блок питания сервера. Два кабеля в сервере работают как резерв только при корректном подключении и достаточной мощности оставшегося пути. Если оба блока питания включены в один rack PDU, отказ PDU отключит оба. Если два PDU питаются от одного общего автомата без альтернативного пути, цвет кабелей не исправит этот общий элемент.
Составьте карту от входных источников до нагрузки. Для каждого сервера запишите стойку, розетки, PDU, распределительный щит, цепочку ИБП и общие элементы. В документации должны совпадать названия A/B на кабелях, в схеме и в системе мониторинга. Само название «A» не доказывает независимость от «B».
| Объект | Пример данных | Какую проблему выявляет |
|---|---|---|
| Сервер app-01 | PSU1 → PDU-A/R1/07; PSU2 → PDU-B/R1/12 | Оба шнура случайно подключены в один PDU |
| Rack PDU | Серийный номер, ввод, автомат, ток по фазам | Ошибочная маркировка или перегрузка после потери пути |
| ИБП | Выход, bypass, обслуживаемые щиты | Общий bypass или обслуживание, затрагивающее оба пути |
| Генераторная часть | Доступная мощность и порядок запуска | Резерв есть на бумаге, но не готов к нагрузке |
| Управление | Питание контроллеров и схема переключения | Общий управляющий элемент отключает обе ветви |
У двухблочного сервера выясните режим БП: балансировка или резервирование, реальная способность одного БП обеспечить текущую конфигурацию и условия переключения. При потере A ток по B может существенно увеличиться. Проверять нужно весь оставшийся путь, включая розетку и защиту. Статус «PSU present» не означает, что блок реально получает питание и способен принять нагрузку.
Для устройства с одним шнуром может потребоваться подходящее оборудование переключения, например STS (Static Transfer Switch — статический переключатель источников), если это предусмотрено проектом. Его допустимое время перехода сопоставляют с характеристиками нагрузки. Сам STS, его управление и подключение также входят в анализ. Наличие STS не присваивает устройству или площадке Tier IV.
Схема в статье показывает логику двух путей и возможных общих зависимостей. Это пояснение механизма, а не сертифицированная однолинейная электрическая схема. Рабочие схемы объекта должны учитывать защиту, селективность, заземление и нормативные требования; их проверяет профильный инженер.
5. Охлаждение: резерв воздуха без резерва насосов не спасает
Серверы могут продолжать получать электричество от ИБП, пока охлаждение уже остановилось. После потери внешнего питания нужно понять, какие части системы охлаждения работают немедленно, какие ждут генератор и сколько занимает возврат в рабочий режим. Тепловой запас зависит от помещения, нагрузки, потоков и конструкции системы; его нельзя заменить одной универсальной цифрой.
Разложите цепочку: удаление тепла из стойки, подача воздуха или жидкости, насосы, теплообменники, чиллеры или другой источник холода, электропитание, клапаны, автоматика и датчики. Если все резервные охладители зависят от одного насоса или контроллера, общий элемент может ограничить работоспособность всей схемы. Для жидкостного охлаждения дополнительно изучите CDU (Cooling Distribution Unit — узел распределения охлаждающей жидкости), контуры, допустимые температуры и возможность изоляции участка.
Для обслуживания задайте конкретный вопрос: «Можно ли изолировать и обслужить этот насос вместе с его арматурой, сохранив требуемый расход и температуры при текущей нагрузке?» Ответ «насосов два» недостаточен. Нужны схема, доступная мощность второго насоса, положение клапанов и процедура переключения. Для отказа вопрос иной: «Что происходит до вмешательства персонала, когда насос внезапно останавливается?»
Обратите внимание на смешение горячего и холодного воздуха, заглушки в стойке и распределение нагрузки. В среднем по залу температура может быть приемлемой, а на входе в отдельный сервер — выходить за допустимый диапазон. Измерения должны соответствовать местам контроля и ограничениям установленного оборудования.
| Состояние | Что измерять | Как интерпретировать |
|---|---|---|
| Штатный режим | Температуры на входе в оборудование, расход, мощность | Базовый профиль при документированной нагрузке |
| Обслуживание части системы | Те же точки плюс оставшаяся мощность | Не возникли ли локальные перегревы и потеря резерва |
| Потеря питания | Хронология остановки и восстановления охлаждения | Перекрывает ли переходный режим время запуска |
| Возврат оборудования | Стабилизация, alarms, потоки | Нет ли опасного переходного режима при обратном переключении |
Порог остановки испытания берут из утверждённой программы и ограничений оборудования. Не назначайте произвольную «безопасную температуру» по чужой статье. Если неизвестно, где установлены датчики или какова их погрешность, это отдельный дефект исходных данных.
6. Как проверить сертификат: TCDD, TCCF и TCOS
Фраза «сертифицированный Tier III» требует уточнения: что именно сертифицировано, какой объект и какая часть объекта? Документы на проект, построенную площадку и эксплуатацию отвечают на разные вопросы. Сопоставление типов предусмотрено программой сертификации Uptime Institute.
| Обозначение | Предмет подтверждения | Практическая граница |
|---|---|---|
| TCDD — Tier Certification of Design Documents | Проектная документация | Не доказывает, что площадка построена и работает именно так |
| TCCF — Tier Certification of Constructed Facility | Построенная инфраструктура и демонстрация её возможностей | Проверяйте охваченные здания, очереди, помещения и изменения после проверки |
| TCOS — Tier Certification of Operational Sustainability | Эксплуатационные процессы | Не подменяет подтверждение построенной топологии и не описывает архитектуру приложения клиента |
Проверка проходит последовательно. Найдите объект в официальном реестре выданных awards. Сверьте юридическое или публичное название, площадку, город, тип подтверждения и уровень. Затем сравните область сертификата с помещением и очередью, где планируется ваша стойка. Если имя здания похоже, но фаза строительства другая, соответствие ещё не установлено.
Попросите актуальный документ и уточнение по расширениям, переоборудованию и изменениям топологии. Условия и границы awards описаны в правилах Uptime Institute. Не переносите сертификат одной части кампуса на все его помещения. Дата, срок применимости и текущий статус проверяются по конкретному типу документа и действующим условиям, а не по общей таблице из старой презентации.
TCCF включает проверку построенного объекта и функциональные демонстрации; описание доступно на странице Construction Certification. Формулировка «построено по требованиям Tier» без независимого подтверждения остаётся заявлением поставщика. Это не обязательно означает плохую площадку, но требует другой глубины технических доказательств и не равнозначно официальной сертификации.
7. Техническое обследование перед размещением: какие данные запросить
Администратору не обязательно самостоятельно пересчитывать весь электрический проект, но он должен связать условия площадки с рисками своей системы. Запрашивайте сведения под конкретную нагрузку: число стоек, кВт на стойку, рост, типы блоков питания, потребность в охлаждении и сроки обслуживания. Предложение «до 10 кВт на стойку» нужно расшифровать: выделенная мощность, лимит каждого ввода, учёт резервирования и действия при превышении.
Первый комплект документов: схема питания до вашей стойки, описание режимов A/B, лимиты и точки измерения; схема охлаждения и переходного режима; программа обслуживания и журналы существенных работ; порядок аварийных уведомлений; описание физического доступа; договорной SLA. Для внешних каналов отдельно запросите трассы и операторов — количество договоров с провайдерами не доказывает разнесение кабельных вводов.
Сведите сведения в реестр конкретных зависимостей. Ниже пример заполнения, а не универсальные требования сертификации:
| Наблюдение | Риск для вашей системы | Что запросить или изменить | Критерий завершения |
|---|---|---|---|
| Оба кабеля firewall в PDU-A | Потеря PDU отключает периметр | Подключение по согласованной карте A/B | Карта и фактическое подключение совпадают |
| Для одного ввода допустимо 5 кВт, стойка потребляет 8 кВт | После перехода оставшийся ввод перегружен | Перераспределение или увеличение доступной мощности | Расчёт и контролируемая проверка принятия нагрузки |
| Два провайдера идут через общий кабельный участок | Одна механическая авария отключает оба канала | Документированное разнесение или другой путь | Подтверждены реальные трассы |
| Есть TCDD, построенная очередь не подтверждена | Проектный статус принят за состояние объекта | Документы и результаты испытаний нужной очереди | Область подтверждения соответствует размещению |
| Не определено время уведомления об аварии | Команда поздно начинает восстановление | Регламент и контакты 24×7 | Проверен тестовый цикл уведомления |
Не путайте отсутствие полученных доказательств с доказанным дефектом. Запись «независимость не подтверждена» точнее, чем категоричное «пути общие», если схемы ещё не предоставлены. Но решение о размещении должно явно учитывать эту неопределённость.
Если серверная инфраструктура уже работает, проведите сверку инвентаризации: сервер → PSU → кабель → розетка → PDU → ввод. Исправление маркировки и случайных подключений часто даёт более понятный результат, чем абстрактный спор о номере Tier.
8. Контролируемое испытание: программа, измерения и критерии остановки
Испытание выполняется под руководством ответственного за инженерную инфраструктуру. Системный администратор согласует прикладные проверки и наблюдает за нагрузкой. Самостоятельное отключение вводов «для проверки резерва» может вызвать реальный простой и не даёт корректного результата без исходных условий.
В программе должны быть указаны цель, начальная топология, текущая нагрузка, отключаемый элемент, порядок действий, исполнители, точки измерения, условия прекращения, возврат и коммуникация. Состояние резерва проверяют до начала: неисправный второй путь делает сценарий принципиально другим. Не объединяйте обслуживание и аварийные воздействия без рассчитанной программы.
Пример тестового случая: плановый вывод ветви питания A для конкретной группы стоек. Цель — подтвердить непрерывность питания соответствующей ИТ-нагрузки через B и отсутствие перегрузки B. Предварительные условия — утверждённая схема, исправный резерв, допустимая нагрузка, готовность охлаждения и согласование владельцев сервисов. Действия инженерного персонала описываются в его утверждённом MOP (Method of Procedure — пошаговая процедура конкретной работы), а не заменяются командой из статьи.
Соберите базовый профиль: токи, мощность, температуры, состояния PSU, доступность приложений и ошибки. Для Linux-хоста с уже установленным и настроенным ipmitool можно запросить локальные датчики:
sudo ipmitool sdr elist
sudo journalctl -k --since '15 minutes ago' --no-pager
Первый вызов требует поддерживаемого локального интерфейса BMC и соответствующих прав; состав SDR зависит от модели. Сверяйте датчик с документацией сервера. Present и OK нужно интерпретировать в контексте конкретного sensor, а не как универсальный вывод о резервировании. Журнал ядра помогает найти события устройства, но отсутствие PSU-сообщения не доказывает отсутствие переключения. Если локальный интерфейс не поддерживается, используйте штатный мониторинг BMC; не публикуйте его пароль в командной строке.
Прикладную проверку можно выполнить из согласованной контрольной точки. Адрес ниже — место для вашего разрешённого endpoint:
curl --fail --silent --show-error --max-time 5 \
  --output /dev/null \
  --write-out 'http=%{http_code} total=%{time_total}\n' \
  https://app.example.net/health
--fail делает HTTP-ошибку ненулевым завершением, --max-time ограничивает ожидание. Параметры описаны в официальном руководстве curl. Не добавляйте -k: неверный сертификат тоже является проблемой проверки. Ответ 200 подтверждает только выбранный endpoint; дополнительно могут требоваться тестовая транзакция, запись в БД, состояние очереди и проверка из клиентской сети.
Во время воздействия фиксируйте общий timestamp и изменения каждого измерения. Прекращайте тест по заранее определённым инженерным порогам, потере требуемого резерва, появлению критических alarms или прикладной деградации согласно программе. После возврата сравните с baseline и убедитесь, что резерв восстановлен. Отчёт должен содержать фактический результат, а не только отметку «тест проведён».
9. Tier, uptime, SLA, RTO и RPO: разные величины
Старые таблицы с «Tier III = 99,982%» и фиксированным числом часов простоя не следует использовать как гарантию. Uptime Institute указывает, что в 2009 году исключил ожидаемый годовой простой из стандарта; современная классификация топологии не присваивает уровням прогноз доступности. Это прямо разъяснено в официальной статье о системе Tier.
SLA определяется договором: какая услуга доступна, откуда измеряется, за какой период, как учитываются работы и какие исключения есть. Доступность электропитания, виртуальной машины и выполнения пользовательской операции — три разных метрики. Проверьте также время реакции, устранения и уведомления: процент доступности не заменяет эти обязательства.
Для простой иллюстрации процента, без привязки к Tier:
Доступность = (время наблюдения − учитываемый простой) / время наблюдения × 100%
Окно 365 суток: 365 × 24 × 60 = 525 600 минут
При 99,95%: 525 600 × 0,0005 = 262,8 минуты простоя за год
Окно 30 суток: 43 200 минут
При тех же 99,95%: 43 200 × 0,0005 = 21,6 минуты за месяц
Это арифметика условного SLA при полном календарном окне. Реальный договор может иначе определять учитываемое время. Годовое и месячное окно также дают разные ограничения: один большой инцидент может вписаться в годовой бюджет и нарушить месячный.
RTO — целевое время восстановления выбранного сервиса; RPO — допустимая потеря данных по времени. Ни Tier IV, ни второй ИБП не создают резервную копию и не гарантируют RPO. Репликация может быстро перенести ошибочное удаление на вторую площадку. Для восстановления нужны подходящие копии, проверка восстановления и понятная последовательность запуска зависимостей.
Для сервиса с малым допустимым простоем оценивайте несколько failure domains: сервер, стойка, зал, площадка, общая сеть, DNS, identity provider, управляющая система. Две зоны могут разделять общие зависимости; это выясняется по архитектуре. Межплощадочный failover дополнительно требует контроля консистентности, quorum, защиты от split-brain и испытаний. Его нельзя заменить обещанием «у нас две площадки».
10. Как выбрать площадку под задачу и сохранить её свойства
Начните с параметров конкретной системы. Например, внутреннему архиву может быть допустим согласованный останов на выходных, а приём заказов требует круглосуточной работы и ограниченного времени восстановления. Для обоих систем нужны защищённые данные и проверенные резервные копии, но требования к непрерывности питания и обслуживанию будут различаться.
Пример исходных требований для обсуждения, а не готовый стандарт для любой компании:
| Параметр | Пример требования | Что он меняет в проекте |
|---|---|---|
| Критический сервис | Приём заказов и запись в основную БД | Проверка всей транзакции вместо одного ping |
| Плановые работы | Без остановки при обслуживании питания и охлаждения | Нужны подтверждённые режимы вывода компонентов |
| RTO | 30 минут для восстановления бизнес-функции | Подготовленный runbook и необходимые ресурсы |
| RPO | 5 минут для транзакционных данных | Частота и механизм сохранения/репликации |
| Нагрузка | Две стойки по 6 кВт с ростом до 8 кВт | Расчёт обоих вводов и охлаждения после перехода |
| Уведомление | Дежурная команда получает событие за 10 минут | Контакты, регламент и проверка маршрута уведомлений |
Дальше сопоставьте требования с доказательствами площадки, архитектурой приложения и ценой устранения оставшихся рисков. Если требуется обслуживание без остановки, изучайте подтверждённую ремонтопригодность. Если нужны дополнительные сценарии отказа, формулируйте их отдельно и проверяйте возможности площадки и приложения. Покупка самого высокого номера без такого сопоставления не делает проект автоматически рациональным.
После размещения поддерживайте соответствие фактической конфигурации: карта подключений, нагрузка, мощность резерва, процедуры и обучение персонала. Изменение стойки, пути, автоматики или охлаждения может затронуть ранее подтверждённые свойства. Uptime Institute отдельно предупреждает об этом в разборе распространённых заблуждений о Tier.
Удобный итог обследования — не один номер, а комплект: проверенная область сертификации, карта зависимостей, расчёты сценариев, фактические протоколы, договорные обязательства и список непокрытых рисков с ответственными. Такой комплект позволяет объяснить руководителю, что произойдёт при конкретном отказе, сколько займёт восстановление и какие действия действительно уменьшают риск простоя.
Нормативные определения и программа подтверждения описаны в Tier Standard: Topology. Для проектирования и официального подтверждения используйте применимую актуальную редакцию стандарта и профильных специалистов; учебные примеры статьи помогают читать и проверять инженерные решения, но не заменяют эту работу.