

Настройка кластера 1С на ПРОФ начинается с распределения ролей и измерений, а не с увеличения числа rphost. Один сервер может быть хорошим решением для умеренной нагрузки. Несколько узлов помогают разделить работу, но требуют понятных правил, достаточных ресурсов и проверки отказов.
Ниже — практический порядок обследования уже установленного кластера и настройки допустимых ТНФ. Техническая опора — документация платформы 8.3.27, проверенная 12 ноября 2026 года. Для другой сборки сверяйте состав полей и справку инструментов. Серверного стенда в рамках подготовки статьи не было: команды приведены как примеры, схемы не являются снимками действующего кластера.
Что получим после настройки
Узлы, процессы, базы, порты и лицензии.
Допустимые назначения без лишних запретов.
Фактическое размещение, замеры и возврат.
Рабочий результат — не «консоль выглядит аккуратно», а воспроизводимая схема: известно, где обрабатываются сеансы, какие сервисы закреплены, что произойдёт при перезапуске и как вернуть прежний вариант. В карточке изменения должны быть исходное состояние, действие, ожидаемый эффект и критерий остановки работ.
ragent, rmngr и rphost: кто за что отвечает
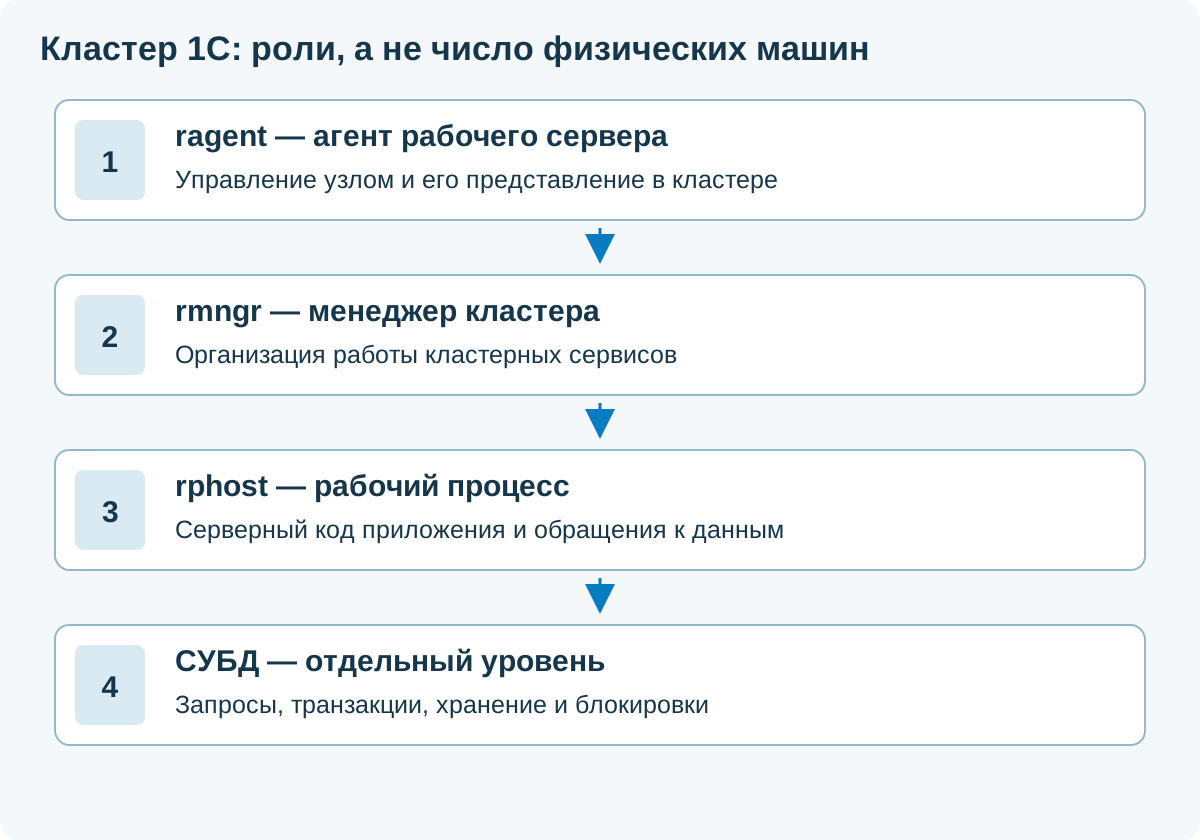
Кластер — логическая система, а не обязательно несколько физических машин. 1С описывает его как компонент взаимодействия клиентов и СУБД. Клиентский код, серверный код приложения и хранение данных следует различать при поиске узкого места.
- ragent: представляет рабочий сервер и обеспечивает управление им.
- rmngr: менеджер кластера, организующий работу кластерных сервисов.
- rphost: рабочий процесс, выполняющий серверную часть приложения и обращающийся к СУБД.
Такое разделение показано в обзоре архитектуры 1С. Оно помогает читать диагностику: большой rphost не означает, что «сломался агент», а перенос приложения на другой узел не устраняет блокировки одной и той же базы данных.
Не завершайте процессы только по величине памяти в диспетчере задач. Сначала сопоставьте PID с рабочим процессом, базами и пользователями, определите причину роста и согласуйте влияние на текущую работу. Повторяющееся ручное завершение скрывает причину и мешает расследованию.
Граница ПРОФ: что разрешено, а что требует КОРП
В руководстве 8.3.27 ПРОФ допускает ТНФ, если во всех правилах пусты «Имя информационной базы» и «Значение дополнительного параметра». Можно выделять определённые кластерные сервисы. Фильтрация по конкретной базе, приложению или виду фонового задания относится к полной функциональности КОРП.
Важное практическое следствие
«Сервис лицензирования должен работать на выбранном узле» — подходящий предмет настройки ПРОФ. «Фоновые задания ERP выполняются на узле B, а Бухгалтерии — на C» — другая задача, требующая проверки прав КОРП. Нельзя выдавать вторую схему за бесплатную возможность ПРОФ.
Дополнительно учитывают лицензионные ограничения: для стандартного ПРОФ — до 500 пользовательских сеансов на базу и до 12 используемых ядер на каждом рабочем сервере. Исторические поставки проверяют отдельно. Выбор уровня и РКЛ разобраны в предыдущей статье.
Производство, отчёты и фоновые задания: три варианта архитектуры
Предположим, предприятие хочет, чтобы выпуск продукции и проведение документов не задерживались из-за управленческих отчётов и обменов. Желание разумное, но сначала нужно уточнить: речь об одной информационной базе или о нескольких связанных системах. От этого зависит способ разделения.
Вариант А. Одна база, один кластер ПРОФ, несколько рабочих серверов
Рабочие узлы предоставляют общий ресурс приложения. Платформа распределяет работу в рамках допустимых настроек, а администратор наблюдает фактическую нагрузку. Можно получить пользу от нескольких узлов, но нельзя обещать, что на APP01 всегда только производство, на APP02 только отчёты, на APP03 только фоновые вычисления. Для такого адресного отбора в ТНФ нужны дополнительные признаки, которые ограничены уровнем лицензии.
Практически это означает: увеличить доступные ресурсы приложения, проверить запас каждого узла, разнести тяжёлые задания по времени и исправить проблемные запросы. Если узкое место в блокировке СУБД, добавление rphost на другом сервере само по себе её не устранит. Именно этот вариант подходит, когда устраивает общий пул без гарантированной изоляции каждой роли.
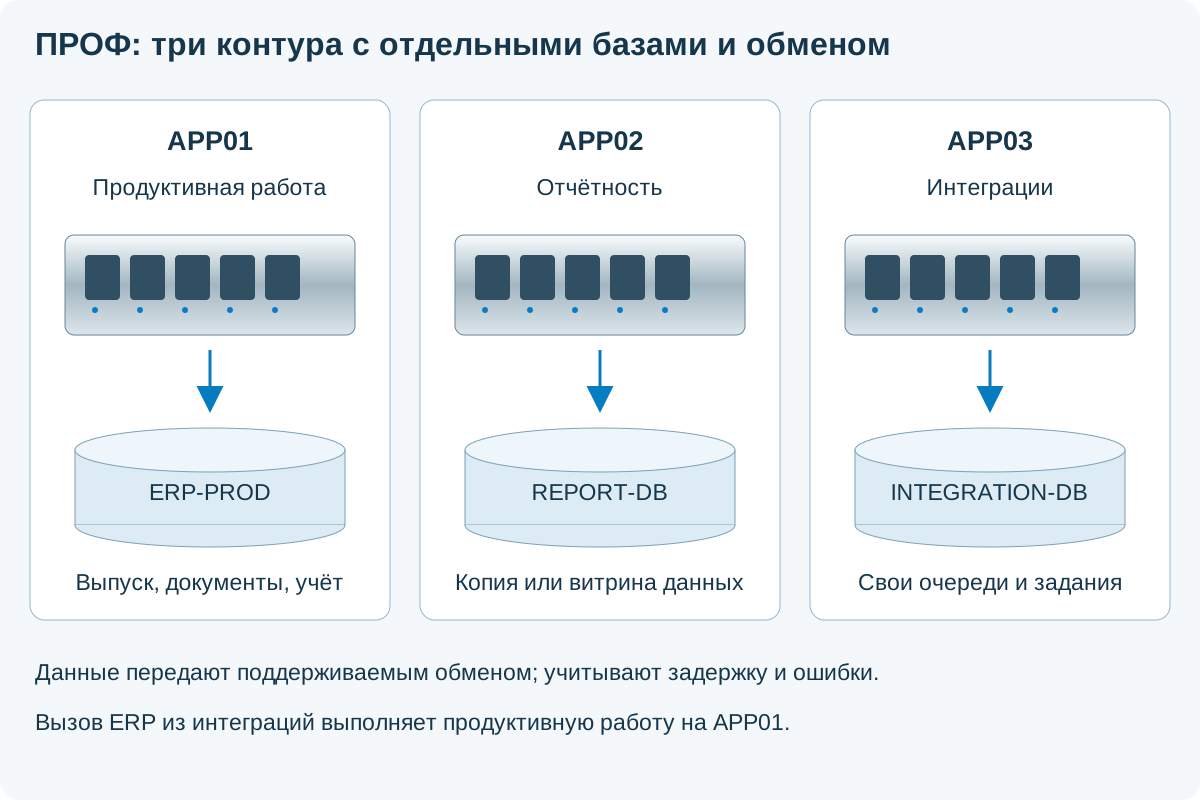
Вариант Б. ПРОФ и отдельные информационные базы для разных задач
APP01 / ERP-PROD: продуктивная база, выпуск продукции, документы и оперативный учёт. APP02 / REPORT-DB: отдельная отчётная база или витрина, получающая нужные данные по поддерживаемому обмену. APP03 / INTEGRATION-DB: отдельная интеграционная база и её собственные задания: подготовка файлов, обращения к внешним сервисам, обработка очереди.
У каждого контура — своя база и согласованное размещение; при необходимости это отдельные экземпляры или кластеры. Это архитектурное разделение приложений и данных, а не адресная маршрутизация одной ERP средствами ПРОФ. Для каждой поставки проверяют права, серверные и клиентские лицензии, ограничения конфигурации и допустимость обмена.
Цена разделения: задержка актуальности отчётов, дополнительные копии данных, сопровождение обмена, контроль ошибок и прав. Отчётная база не должна незаметно стать вторым местом оперативного ввода. На ней запрещают ненужные регламентные действия, отправку писем, ЭДО и другие внешние эффекты средствами соответствующей конфигурации. Данные для отчётов передают с проверкой полноты и момента среза.
Задание, выполняющееся в INTEGRATION-DB, не становится фоновым заданием продуктивной ERP автоматически. Если оно вызывает API ERP для проведения документа, серверная работа этого вызова остаётся в продуктивном контуре. Для очереди нужны идентификатор операции, безопасный повтор и контроль того, что сообщение не потерялось и не обработалось дважды.
Что нельзя считать способом разделения
Нельзя зарегистрировать одну и ту же физическую базу СУБД в нескольких независимых кластерах и объявить это изоляцией на ПРОФ. Раздельные менеджеры состояния и блокировок создают риск некорректной работы. Также нельзя превратить обычную реплику SQL в готовую отчётную базу 1С одним переключением строки соединения: нужен поддерживаемый механизм и проверка поведения конфигурации.
Вариант В. Одна база и адресные правила при наличии КОРП
Если нужны единые актуальные данные и управляемое распределение соединений или видов заданий, проектируют полные ТНФ КОРП. Прикладной отчёт при этом не обязательно распознаётся платформой как самостоятельный тип соединения: может понадобиться отдельный маршрут запуска, поддерживаемая конфигурацией маркировка и доработка. Даже КОРП не даёт готовой кнопки «все отчёты на сервер №2».
Выбор прост: общий пул — вариант А; допустимы отдельные данные и задержка — вариант Б; нужна адресная изоляция одной базы — исследовать вариант В и реальные признаки маршрутизации. Во всех трёх случаях отдельно оценивают общую СУБД, диски и сеть.
Три сервера приложения: одна база или три?
Возможны оба варианта, но это разные архитектуры. На предыдущей схеме с ERP-PROD, REPORT-DB и INTEGRATION-DB показаны самостоятельные базы. В обычном многосерверном кластере иначе: несколько рабочих серверов 1С могут обслуживать одну информационную базу в одной СУБД. Между этими рабочими серверами не нужно синхронизировать три экземпляра бизнес-данных, потому что экземпляр данных один.
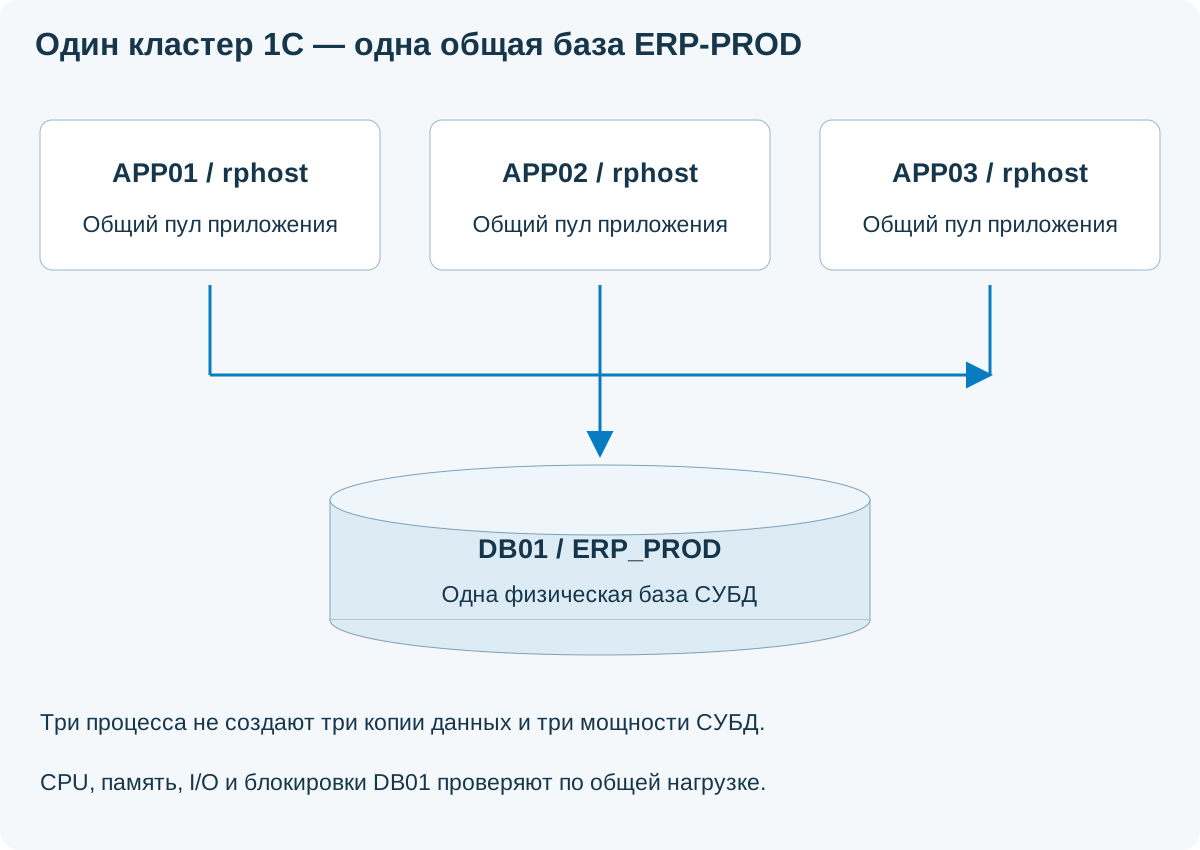
Например, в одном кластере зарегистрирована ERP-PROD с адресом DB01 и именем SQL-базы ERP_PROD. На APP01, APP02 и APP03 работают процессы rphost. Процесс, обслуживающий сеанс или задание этой базы, обращается к ERP_PROD на DB01. Проведённый документ виден другим пользователям через общую базу с учётом транзакций и правил приложения. Никаких отдельных «копий APP01» и «копий APP02» здесь нет.
Что даёт эта схема: больше ресурсов серверного кода, распределение сеансов, возможность обслуживания узлов в рамках поддерживаемой процедуры. Чего она не даёт: трёхкратного увеличения мощности СУБД, независимых дисков для каждой роли и автоматической изоляции отчётов от проведения документов. На ПРОФ названия APP01/02/03 также не закрепляют за ними бизнес-роли; это общий пул допустимых исполнителей.
Важно различать два случая: одна база обслуживается рабочими серверами одного согласованного кластера — нормальная архитектура; та же физическая база отдельно зарегистрирована в независимых кластерах — не способ распределения нагрузки. У второго случая нет общего управляющего состояния приложения, поэтому его нельзя предлагать как обход ограничений ПРОФ.
Ещё одна путаница: три базы в одном экземпляре PostgreSQL или SQL Server — это не три независимые СУБД. Они могут делить CPU, память, диски и фоновые операции одного сервера. Три экземпляра СУБД на одном гипервизоре и одном массиве также продолжают конкурировать за общие ресурсы. Разделение имён необходимо, но само по себе не обеспечивает физическую изоляцию.
Не перегрузят ли три сервера 1С одну СУБД?
Могут. Если приложение раньше упиралось в CPU одного узла, дополнительные узлы начнут быстрее генерировать запросы. Следующим ограничением станут CPU СУБД, чтение, запись журнала транзакций, временные данные либо блокировки. Это не ошибка кластеризации: узкое место переместилось на следующий общий ресурс.
Число серверов не задаёт нагрузку напрямую. Важнее число одновременно выполняемых операций, сложность запросов, объём данных и время транзакций. Три почти свободных rphost могут быть легче одного процесса с тяжёлым закрытием месяца. Поэтому нельзя назначить лимит «одна СУБД выдерживает не больше двух серверов 1С» без измерений.
- CPU и параллелизм: смотрите загрузку СУБД, отдельные тяжёлые запросы и конкуренцию за процессор, а не только APP01.
- Память: рабочий набор данных, кэш СУБД, память сортировок и хеширования, временные выгрузки на диск. Память приложения на другом узле не заменяет память СУБД.
- Хранение: задержки чтения и записи, журнал транзакций, временные файлы, место, пиковый поток WAL или transaction log. Отдельные тома на одном занятом пуле не обязательно дают независимую производительность.
- Блокировки: кто кого ждёт, длительность транзакции, конкуренция за один регистр или набор строк. Добавление клиентов к блокировке увеличивает очередь.
- Соединения: фактическое число подключений от процессов приложения, их активность и допустимый предел. Суммарную потребность считают по всем узлам, с резервом на обслуживание.
- Фоновые работы: обслуживание СУБД, контрольные точки, vacuum для PostgreSQL, копирование, обновление статистики и выгрузки. Их расписание сопоставляют с пиками бизнеса.
Условный пример проверки
Днём идут проведение документов и выпуск продукции. В 14:00 одновременно стартуют три тяжёлых отчёта и обмен большого пакета. После добавления APP03 процессор приложения свободен, но выросли ожидания диска DB01 и время проведения. Вывод — приложение перестало быть ограничителем, а общий ресурс данных перегружен. Следующий шаг: измерить запросы, развести допустимые по времени задачи и проверить разгрузку аналитики. Покупка APP04 без этого может увеличить очередь.
Нагрузочное испытание проводят ступенями: обычная работа, затем отчёты, затем задания, затем их сочетание. На каждом этапе фиксируют время типовых операций, ошибки и показатели DB01. При неприемлемом росте задержек останавливают увеличение нагрузки. Сравнение «до/после» должно учитывать одинаковый объём данных и сопоставимый прогрев кэша.
Если запас СУБД отсутствует, ограничивайте параллельный запуск прикладных заданий там, где это поддерживает конфигурация, пересматривайте запросы и расписание. Не увеличивайте вслепую число соединений: больше одновременно ожидающих запросов не означает больше завершённых операций в секунду.
Как разгрузить отчётность: копия платформы, отдельная 1С или витрина
1. Механизм копий базы данных платформы 1С
Механизм копий позволяет поддерживать нужные данные в другой физической базе и использовать их для подходящих аналитических запросов. Это отдельная функция платформы, а не резервная копия и не второй независимый вход в ту же SQL-базу. Выбирают состав данных, механизм обновления и допустимую актуальность.
В методическом описании 1С показаны условия перенаправления запросов и работа с актуальностью. Запись и транзакционная обработка остаются на основной базе. Не любой отчёт автоматически уйдёт в копию: совместимость запросов, полноту таблиц и фактическое место выполнения нужно проверять. Версию, режим совместимости и лицензионную доступность выбранного варианта подтверждают отдельно.
2. Самостоятельная отчётная информационная база
Здесь APP02 действительно работает со своей REPORT-DB. Данные поступают прикладным обменом, предусмотренным конфигурацией, либо специально разработанной интеграцией. Возможен механизм РИБ, если конкретная конфигурация и задача его поддерживают: это обмен между узлами информационной системы, а не универсальная SQL-репликация. Пример использования РИБ в продуктах 1С приведён в описании розничного ИТ-ландшафта.
Нельзя выбрать РИБ только потому, что у компании появились три сервера. Сначала определяют состав объектов, узлы-владельцы, права изменения, правила разрешения конфликтов и обновления конфигураций. Для отчётного контура часто достаточно односторонней передачи; двусторонний ввод увеличивает сложность и требует бизнес-правил.
3. Аналитическая витрина для BI
Для управленческих показателей отдельная копия всей ERP может быть избыточной. ETL/ELT-процесс получает согласованный набор данных через поддерживаемые интерфейсы, преобразует и загружает его в аналитическую СУБД. BI читает витрину, а не запускает тяжёлый отчёт внутри продуктивной ERP.
Проектируют ключи объектов, изменения и удаления, повторную загрузку, контрольные суммы или бизнес-итоги, момент среза и восстановление после сбоя. Начальная массовая выгрузка сама создаёт нагрузку на продуктивную систему. Прямое чтение внутренней структуры таблиц 1С, а тем более запись в них, нельзя считать стабильным прикладным API: обновление конфигурации может изменить схему и смысл данных.
Для всех трёх вариантов определяют честное обещание пользователю: «данные на 14:00», «отставание до пяти минут при нормальной работе» или «отчёт только по завершённому ночному срезу». Время последней успешной загрузки и реальная задержка должны быть видны. Настройка расписания каждые пять минут ещё не гарантирует пятиминутную актуальность, если очередь обрабатывается полчаса.
Несколько СУБД: что и зачем реплицировать
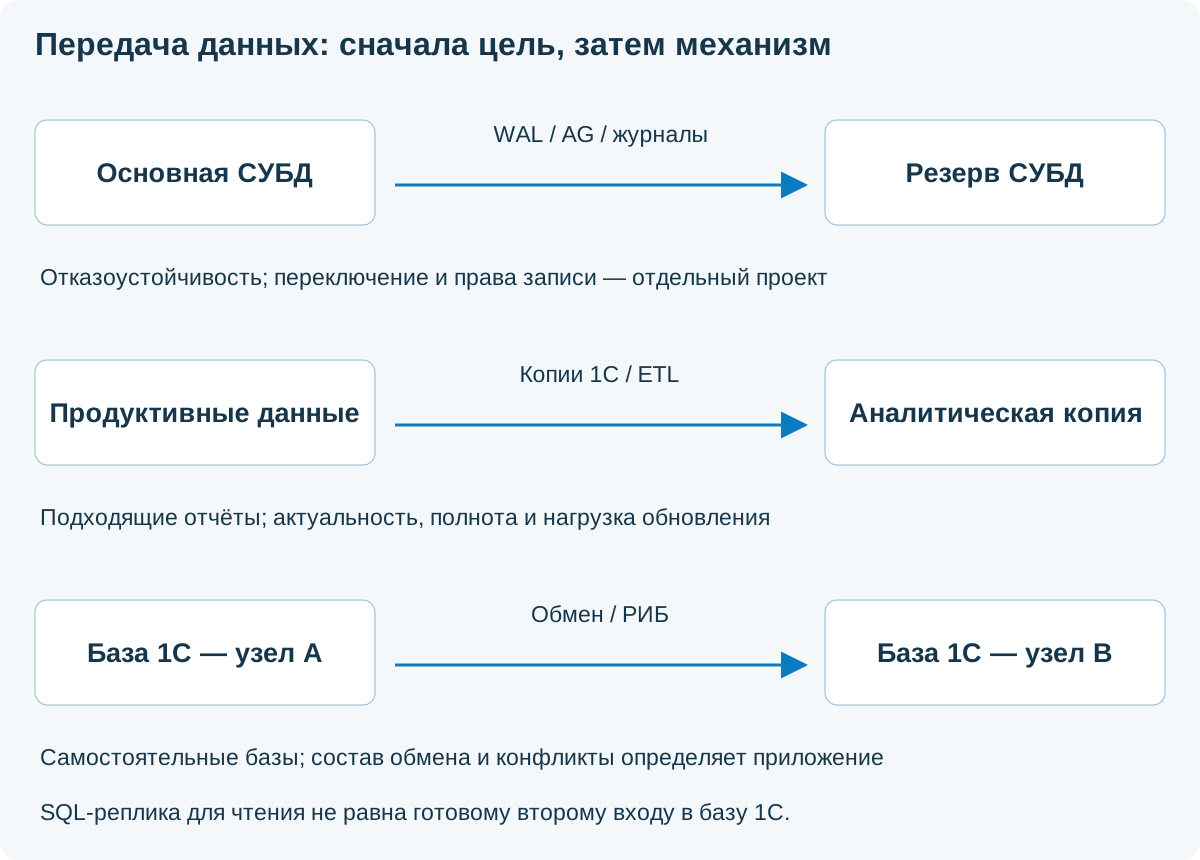
Сначала выберите цель: пережить отказ DB01, разгрузить чтение или синхронизировать самостоятельные прикладные базы. Одним словом «репликация» нельзя заменить три разных проекта. Второй экземпляр СУБД может быть резервом, копией для чтения или самостоятельным хранилищем, и права записи у них различаются.
| Задача | Возможный механизм | Что нельзя обещать автоматически |
|---|---|---|
| Резерв PostgreSQL | Физическая потоковая репликация WAL, согласованный процесс переключения | Автоматическое безопасное переключение и работу обычного клиента 1С на standby |
| Резерв SQL Server | Always On Availability Groups; для иных требований — Log Shipping | Одинаковые функции во всех редакциях, мгновенное переключение и отсутствие потерь при любом режиме |
| Отчётное чтение на SQL-уровне | PostgreSQL hot standby или readable secondary SQL Server | Совместимость любого отчёта 1С с read-only-узлом и нулевую задержку |
| Раздельные базы 1С | Поддерживаемая синхронизация, РИБ или прикладная интеграция | Согласованную двустороннюю запись без правил владения и конфликтов |
| Выбранные данные для аналитики | Копии платформы, ETL/ELT, подходящий CDC или логическая репликация | Готовую работоспособную копию всей ERP и автоматическое сопровождение её структуры |
PostgreSQL: основной узел и физический резерв
Streaming replication передаёт WAL на standby. Асинхронный режим допускает отставание и потерю ещё не переданных изменений при аварии. Синхронный режим меняет условия подтверждения транзакции и способен добавить сетевую задержку или ожидание недоступного резерва. Выбранные подтверждения и настройки определяют фактические гарантии.
Проверяют совместимость сборок и major-версий, начальную копию, пропускную способность и хранение WAL. Репликационный слот при отставании потребителя способен удерживать WAL и заполнять диск. Отслеживают передачу и применение, а переключение проектируют с защитой от одновременной записи на двух основных узлах. Для конкретной сборки PostgreSQL под 1С сверяют её документацию; приведённая ссылка PostgreSQL 18 не является рекомендацией установить эту версию для любой платформы 1С.
Hot standby допускает чтение, но конфликт долгого запроса с применением WAL может приводить к отмене запроса или задержке восстановления. Поэтому отчётная нагрузка способна ухудшить готовность резервного узла. Если совмещать резерв и аналитику, оба требования испытывают вместе.
PostgreSQL: логическая репликация — другой инструмент
Публикации и подписки не переносят автоматически DDL и состояние последовательностей; есть и другие ограничения. При изменении структуры получатель может перестать применять изменения. Это не универсальный способ скопировать ERP и разрешить запись на обоих концах. Для аналитического проекта заранее задают набор таблиц, идентификацию строк, обработку схемы и удаления, контроль задержки и переинициализацию.
SQL Server: Always On и Log Shipping
Readable secondary в Always On позволяет разгружать подходящее чтение; запись в пользовательскую вторичную базу не разрешается. Поддержка чтения, маршрутизации и топологии зависит от редакции, версии и лицензий SQL Server. Само наличие listener не направляет произвольный отчёт 1С на правильный узел: нужны поддерживаемый способ доступа, корректные свойства подключения и испытание запроса.
Log Shipping переносит и восстанавливает резервные копии журнала транзакций. Здесь есть расписание и задержка, а переключение не превращается в автоматическое только из-за включения доставки. Режим восстановления и возможное чтение согласуют с окнами применения журналов.
Read-only СУБД не равна готовому отчётному серверу 1С. Даже операция, кажущаяся пользователю чтением, может сопровождаться записью служебных или прикладных данных. Обычный запуск базы на standby нельзя предлагать без подтверждённого механизма поддержки. И любой резерв быстро получает ошибочное изменение или удаление с основного узла: репликация не заменяет резервные копии и проверку восстановления.
Как выбрать и внедрить схему для предприятия
- Описать операции: выпуск продукции, проведение, отчёты, обмены; кто работает и какие задержки допустимы.
- Нарисовать адреса данных: для каждого APP указать информационную базу, экземпляр СУБД, физическое хранилище и разрешённые операции. Отметить общий гипервизор и массив.
- Снять исходный профиль: длительность операций, блокировки, CPU, память, I/O и объём журналов в рабочем пике.
- Выбрать способ разделения: общий пул приложения; поддерживаемая аналитическая копия; самостоятельная отчётная база; BI-витрина; отдельно — резерв СУБД.
- Проверить поддержку и права: платформа, конфигурация, ПРОФ/КОРП, СУБД, редакция, клиентские права, СЛК и резервные узлы.
- Настроить передачу: начальная загрузка, направление, расписание, допустимое отставание, очередь, повтор и контроль полноты.
- Испытать нагрузку и сбои: продуктивные операции вместе с отчётами; разрыв обмена, накопление очереди, догоняющую загрузку и потерю узла.
- Принять результат: замеренное время, актуальность данных, воспроизводимый возврат и ответственные за сопровождение.
Пример обоснованного выбора
Производству нужны актуальные остатки при каждом проведении, руководству допустим управленческий отчёт с задержкой 15 минут, внешняя интеграция обрабатывает очередь. Сначала оставляют продуктивную ERP на основной БД. Для аналитики проверяют поддерживаемую копию или витрину на отдельном ресурсе. Интеграционные задачи выносят в самостоятельный контур там, где это снижает вычисления, но учитывают оставшуюся нагрузку API на ERP. Физический резерв основной СУБД проектируют независимо от этих двух решений.
Приёмка должна включать не только свежую копию в спокойный момент. Проверьте отставание во время закрытия месяца, нагрузку восстановления связи и поведение отчёта при неполных данных. Оповещение «служба репликации запущена» не подтверждает, что все нужные данные дошли и отчёт отражает согласованный срез.
Выбираем схему под задачу
| Вариант | Когда рассматривать | Что проверить |
|---|---|---|
| Один узел приложения, отдельная СУБД | Умеренная нагрузка, понятное сопровождение | Пиковую память, время операций, резерв и окно восстановления |
| Два рабочих узла приложения | Рост нагрузки, обслуживание узлов, распределение работы | Сеть, лицензии, запас при отказе, фактическое распределение |
| Узел приложения и выделенный узел лицензирования | Нужен управляемый контур выдачи программных клиентских лицензий | Привязку лицензий, доступность узла и сценарий его потери |
| Адресное разделение баз и видов заданий | Разные профили нагрузки и требования изоляции | Необходимость КОРП, права клиентов и поддержку выбранных функций |
Выделенный сервис не является самостоятельной целью. При небольшом количестве пользователей отдельная ВМ добавляет обслуживание и новую зависимость. При сложной инфраструктуре она может упростить контроль изменений. Решение принимают по текущей проблеме, а не по количеству прямоугольников на схеме.
Для каждого узла запишите, какая работа должна остаться доступной при его потере. Если единственный сервер лицензирования недоступен, наличие свободного CPU на другом узле само по себе не гарантирует запуск новых пользователей. Отказ приложения, СУБД, лицензирования и сети проверяют раздельно.
Шаг 1. Снимите исходное состояние
- Запишите полную сборку платформы, ОС, архитектуру и установленные инструменты администрирования.
- Зафиксируйте центральные и рабочие серверы, их адреса, порты и каталоги служебных данных.
- Сохраните свойства кластера, список баз, ТНФ и порядок правил на каждом узле.
- Соберите пиковые сеансы по базам, процессы, память и длительность ключевых операций.
- Проверьте права на развёртывание и фактически получаемые лицензии.
- Подготовьте проверенную копию базы и согласованный способ восстановления служебного состояния.
Скриншоты свойств дополняют реестр, но не заменяют его. Внесите также настройки службы ОС: от чьего имени запускается агент, какие параметры ему переданы, где временные файлы и что запускается после перезагрузки. Для каждого неизвестного поля сначала выясните назначение, затем решайте, менять ли его.
Не называйте копию открытого каталога кластера гарантированно согласованной резервной копией. Порядок сохранения и восстановления служебных данных зависит от состояния процессов и выбранного способа. Снимок ВМ без проверки базы и лицензий тоже не доказывает возможность восстановления.
Шаг 2. Найдите службу и процессы в Windows
Выполняйте диагностические команды на нужном сервере из PowerShell с достаточными правами. Get-CimInstance читает сведения ОС; команды ниже не меняют службу.
Get-CimInstance Win32_Service |
  Where-Object { $_.PathName -match 'ragent' } |
  Select-Object Name, State, StartName, PathName
Зачем: найти реальное имя службы, учётную запись и команду запуска. Результат: одна или несколько строк. Несколько экземпляров требуют сопоставления портов и каталогов, а не удаления «лишнего» процесса.
Get-CimInstance Win32_Process |
  Where-Object { $_.Name -in @('ragent.exe','rmngr.exe','rphost.exe','ras.exe') } |
  Select-Object Name, ProcessId, ExecutablePath, CommandLine
Зачем: связать PID со сборкой и экземпляром. Результат: реальные пути и параметры, если права позволяют их прочитать. Пустое поле не доказывает отсутствие процесса; проверьте права и контекст запуска.
Get-Process -Name ragent,rmngr,rphost -ErrorAction SilentlyContinue |
  Select-Object Id, ProcessName, CPU,
    @{Name='WorkingSetMiB';Expression={[math]::Round($_.WorkingSet64 / 1MB, 1)}}
Зачем: получить быстрый снимок процессов. CPU здесь — накопленное процессорное время в секундах, а не текущая загрузка в процентах. WorkingSetMiB — рабочий набор; он не заменяет анализ committed/private memory и общего давления на память. Один снимок не показывает динамику.
Linux: найдите фактический unit, каталог и владельца
Имя службы зависит от пакета и установки. Сначала найдите его, затем подставьте в переменную; не копируйте чужое имя из старой инструкции.
systemctl list-unit-files --type=service --no-pager | grep -Ei '1c|srv1cv8'
ps -eo user,pid,ppid,etime,args | grep -E '[r]agent|[r]mngr|[r]phost|[r]as'
Первая команда ищет установленные unit-файлы, вторая показывает процессы, владельцев и аргументы. Совпадения имени нужно проверить вручную. Сведения о systemctl доступны в документации systemd.
cluster_unit='ИМЯ_НАЙДЕННОЙ_СЛУЖБЫ.service'
systemctl status "$cluster_unit" --no-pager
systemctl cat "$cluster_unit"
systemctl show "$cluster_unit" -p User -p Group -p ExecStart -p Environment
Зачем: увидеть состояние, исходный unit и drop-in, фактический запуск и окружение. Результат: параметры для карты экземпляра. Вывод окружения может содержать внутренние сведения; перед передачей наружу его проверяют. Из этих команд не следует необходимость редактировать поставляемый unit.
sudo ss -ltnp
df -h
df -i
free -h
Проверьте слушающие TCP-порты, свободное место, inode и память. Нехватка места в каталоге временных файлов или журналов способна выглядеть как проблема 1С. Отдельно убедитесь, что служебная учётная запись имеет нужный доступ к своему каталогу; универсальное разрешение всем на запись не является исправлением.
Шаг 3. Проверьте имена и весь путь подключения
В типовой схеме используются 1540 для агента, 1541 для менеджера и динамический диапазон 1560–1591; их можно изменить. Это исходные значения из документации, а не предписание открывать их всем. Фактические порты берут из запуска и свойств экземпляра.
Resolve-DnsName app01.example.internal
Test-NetConnection app01.example.internal -Port 1541
Test-NetConnection app02.example.internal -Port 1561
Последняя команда — только пример для реально назначенного порта рабочего процесса; сначала найдите его. Test-NetConnection подтверждает TCP-доступность, а не вход в базу. Проверьте подключение с пользовательского сегмента и связь между узлами: доступ к начальной точке не гарантирует доступ к адресу, который будет выдан клиенту дальше.
Административный доступ вынесите в управляемый сегмент или VPN. Разрешения строят по матрице источников и назначений: пользователи, узлы приложения, СУБД, администраторы, мониторинг. Утилита ras не должна становиться общедоступной точкой управления. Учётные записи администраторов агента, кластера, базы и ОС — разные уровни доступа.
ras и rac: проверка управления без изменения кластера
1С описывает ras/rac как кроссплатформенные инструменты. Для этой инструкции выбирайте инструменты той же сборки, что и сервер. Пример предполагает уже настроенный ras; его запуск и публикация порта требуют отдельного решения.
$rac = 'C:\Program Files\1cv8\8.3.xx.xxxx\bin\rac.exe'
& $rac help
& $rac help cluster
Замените каталог на установленную сборку. Первая команда выводит общую справку, вторая — помощь по режиму cluster, если такой формат поддерживает ваша версия. Справка позволяет проверить синтаксис до выполнения административных действий.
& $rac cluster list 'localhost:1545'
$racExitCode = $LASTEXITCODE
$racExitCode
Для уже работающего локального ras с таким адресом ожидается список кластеров, включая их идентификаторы; код 0 означает успешное завершение команды. Ошибка соединения, ошибка прав и отсутствие ожидаемого кластера — разные результаты. Порт 1545 приведён как пример. При требуемой аутентификации используйте штатный способ вашей сборки; не отключайте защиту ради получения списка.
Пароли не следует превращать в литералы опубликованного сценария. Даже ввод пароля через переменную не гарантирует, что он не окажется в аргументах процесса. Для работы с защищённым кластером выберите согласованный административный способ; визуальные действия с ТНФ ниже выполняются после штатной аутентификации.
Шаг 4. Подготовьте дополнительный рабочий сервер
- Установите совместимую серверную сборку, создайте служебную учётную запись и каталоги.
- Сверьте DNS, время, маршруты, межузловые разрешения и связь с СУБД.
- Откройте консоль администрирования, подключитесь к нужному агенту и кластеру.
- В списке рабочих серверов добавьте узел с его фактическим именем, портом агента и диапазоном рабочих портов.
- Проверьте, что появился именно нужный узел, а новые процессы используют ожидаемую сборку и каталоги.
- Только после этого планируйте ТНФ и проверку нагрузки.
Не смешивайте «центральный сервер» как роль в кластере с самым мощным физическим сервером. Состав центральных узлов проектируют с учётом отказов и доступных механизмов конкретного релиза. Для учебного примера ниже APP01 обслуживает приложение, LIC01 выделен под лицензирование; это разделение ролей, а не обещание отказоустойчивости.
До добавления узла проверьте остаток RAM и CPU на гипервизоре, конкуренцию с СУБД и резерв на обслуживание. Удвоение количества ВМ на перегруженном хосте не удваивает доступные ресурсы. Отдельно согласуйте лицензирование ОС, СУБД и платформы для принятой схемы.
ТНФ: поля, смысл и приоритет
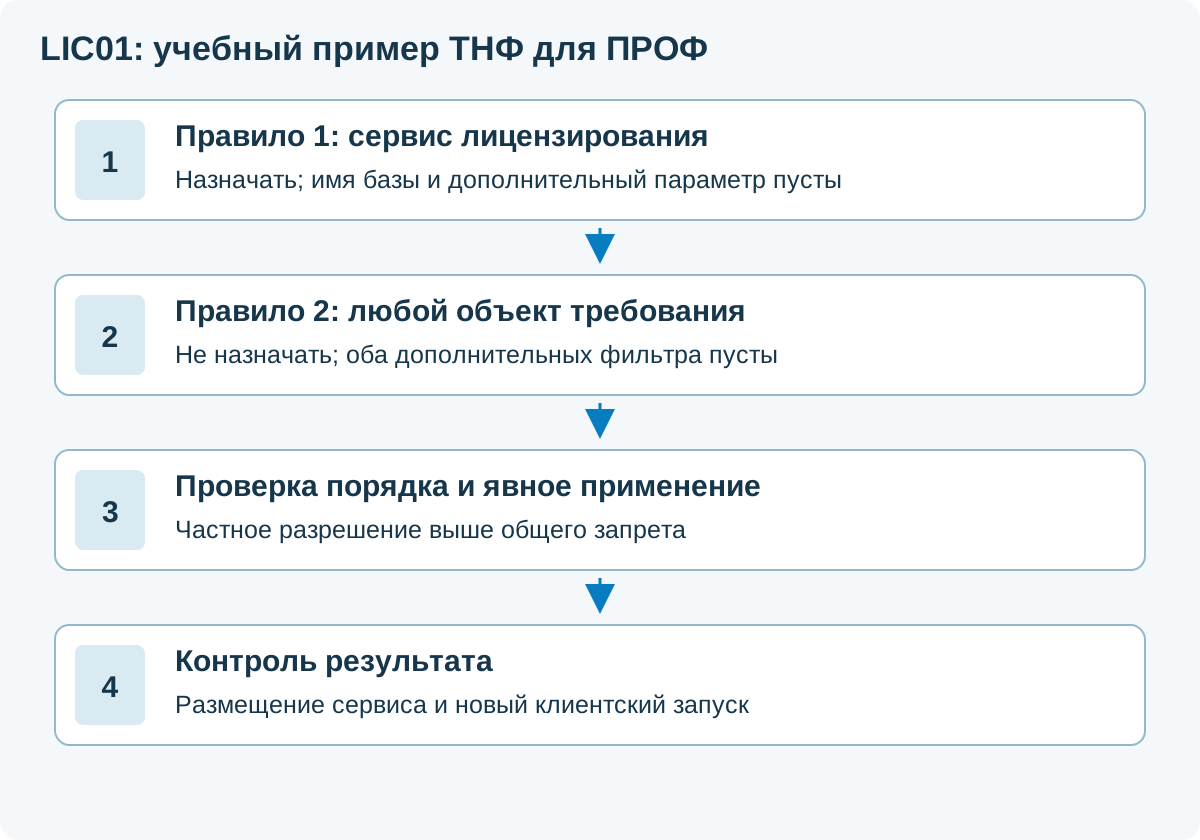
ТНФ — требования назначения функциональности. Для ПРОФ в этом примере оба дополнительных фильтра оставляются пустыми. Объект выбирают по точному наименованию в консоли установленной сборки, а не по похожему слову в статье.
| Поле | Что означает | Что записать в проект |
|---|---|---|
| Объект требования | Какую работу рассматриваем | Конкретный сервис либо общий объект |
| Тип требования | Назначать / не назначать / авто | Почему выбран этот тип и кто остаётся кандидатом |
| Имя информационной базы | Дополнительная адресация | В примере ПРОФ — пусто |
| Значение дополнительного параметра | Уточнение вида работы | В примере ПРОФ — пусто |
| Номер / приоритет | Порядок рассмотрения | Специальное правило выше общего запрета |
В руководстве 8.3.27 меньший номер означает более высокий приоритет; правила требуется явно применить. Нажать «ОК» в форме недостаточно. После изменения проверьте весь список конкретного узла: общий запрет, случайно оказавшийся раньше частного разрешения, меняет смысл схемы.
«Авто» не означает гарантию назначения на этот сервер. При проектировании нужно проверить набор допустимых кандидатов и взаимодействие правил на всех узлах. Не создавайте симметричный запрет на каждом сервере только ради красивой схемы — работа может остаться без места выполнения.
Пример ПРОФ: отдельный узел лицензирования
Условие примера: LIC01 уже добавлен, доступен и выбран как место выдачи программных клиентских лицензий. На нём создайте два правила в указанном порядке:
- Сервис лицензирования → назначать. Имя базы и дополнительный параметр пусты.
- Любой объект требования → не назначать. Оба фильтра также пусты.
Этот вариант приведён в руководстве 8.3.27. Перед переносом проверьте регистрацию и привязку программных лицензий: назначение сервиса не перепривязывает их автоматически. Для остальных узлов сверяют действующие правила, чтобы они соответствовали проекту и не создавали непредусмотренную альтернативу.
Рекомендуемый порядок проверки:
- Сохранить прежние списки правил и сведения о лицензировании.
- Создать частное разрешение, затем общий запрет; проверить порядок и пустые фильтры.
- В согласованном окне явно применить требования штатной командой консоли.
- Обновить сведения о менеджерах и размещении сервиса.
- Проверить новый клиентский запуск и сведения о полученной лицензии.
- Зафиксировать, что произойдёт при недоступности LIC01 и как восстанавливается работа.
Сервис выдачи лицензий и серверный код приложения — разные вещи. Не переносите на LIC01 тяжёлую обработку «раз он простаивает», не изменив проект. Резервный способ выдачи и привязки планируют отдельно; перенос ВМ на другой хост тоже проверяют на предмет лицензионных последствий.
Почему нельзя обещать разделение любых фоновых заданий в ПРОФ
Сервис заданий управляет их выполнением, а серверный код задания создаёт нагрузку приложения и СУБД. Перенос управляющего сервиса не равен переносу всех вычислений выбранной обработки. Для адресации по виду задания нужен дополнительный отбор — это выходит за рамки показанного ПРОФ-сценария.
Практический путь без выдуманных настроек:
- Составить расписание обменов, закрытия месяца, индексации и массовых обработок.
- Найти пересечения с пиком интерактивной работы.
- Измерить отдельно CPU, память приложения, запросы и блокировки СУБД.
- Перенести разрешённые по бизнес-процессу операции в другое окно.
- Если этого мало — обосновать адресное размещение, права КОРП и изменение алгоритмов.
Изначально медленное задание после переноса может продолжить блокировать ту же таблицу на той же СУБД. Поэтому итог проверяют по пользовательским операциям и обменам, а не только по загрузке узла приложения.
Перегружен один узел: как балансировать без обрывов
Автоматическое распределение платформы не равно равномерному CPU на всех серверах. Один сеанс может выполнять тяжёлую операцию, а двадцать других почти ничего не делать. Внутренняя «доступная производительность» рабочего процесса помогает кластеру выбирать исполнителей, но не является ни Apdex, ни измерением времени бизнес-операции.
- Определить ресурс: CPU одного ядра или всего узла, память, диск, сеть, ожидание СУБД либо внешнего сервиса.
- Сопоставить нагрузку: база, сеанс, PID, пользовательская операция, задание, время начала.
- Проверить альтернативу: есть ли свободный допустимый узел, хватает ли RAM и не общий ли у них перегруженный гипервизор.
- Устранить ограничение: расписание, алгоритм, запрос, ресурсы либо допустимые назначения. Менять один фактор за раз.
- Проверить новые соединения и существующую работу: изменение схемы не обещает мгновенно перенести уже выполняющийся длинный вызов.
Для обслуживания узла сначала сохраняют настройки, проверяют запас остальных серверов и используют поддерживаемую своей версией процедуру вывода из работы. В руководстве 8.3.27 описан общий запрет назначения на выводимый рабочий сервер с высоким приоритетом, явное применение и ожидание закрытия соединений перед удалением. Это адресная административная операция, а не автоматическая реакция на любой всплеск CPU. Для центрального узла дополнительно проверяют сохранение управляющей роли.
Не ставьте сценарий «CPU > 80% — убить rphost». Краткий пик может быть нормальной полезной работой. Оповещение должно учитывать длительность, задержки операций и запас ресурсов. Если все узлы ждут одну блокировку в SQL, перенос соединений между ними не устранит её причину.
Число процессов и соединений: больше не всегда лучше
Избыточное число рабочих процессов увеличивает расход памяти и служебные затраты. Слишком плотная упаковка разных нагрузок затрудняет изоляцию и сопровождение. Универсального числа rphost для любой 1С нет: сначала фиксируют базы, сеансы и профиль работы.
Не копируйте рекомендацию «одна база на процесс» как обязательную настройку ПРОФ. Состав доступных полей и условия их изменения зависят от версии и уровня лицензии. Параметры числа баз, соединений и специальных алгоритмов балансировки проверяют по документации конкретного релиза; недоступное поле не обходят ручной правкой реестра.
Как ставить эксперимент
Выберите один параметр, запишите исходное значение и причину изменения. Повторите одинаковые операции при сопоставимом числе сеансов. Сравните память всех процессов, время ответа, частоту перезапусков и нагрузку СУБД. Если эффект не подтверждён или ухудшилась устойчивость — верните исходное значение.
Для небольшого контура оставление поддерживаемых исходных настроек после проверки бывает разумнее сложной «оптимизации». Для нагруженного — нужен журнал измерений и несколько воспроизводимых вариантов, а не набор значений из чужого скриншота.
Память и перезапуск: настройка по фактам
В изменениях платформы 8.3.16 описана доступность в ПРОФ критического и временно допустимого объёмов памяти процессов и периода превышения. В ПРОФ это связано с перезапуском процессов; КОРП дополнительно управляет прерыванием тяжёлых вызовов. Не смешивайте эти механизмы.
Перед выбором порога определите реальный запас RAM. Например, условный узел с 64 ГиБ, где ОС и сопутствующие службы требуют 8 ГиБ, не даёт права назначить 56 ГиБ каждому из четырёх процессов. Нужно оставить общий резерв и проверить пик, а при совместном размещении учесть ещё СУБД и другие приложения. Это иллюстрация логики, а не рекомендуемый лимит.
- Замерьте память в обычное время и в пике.
- Сопоставьте рост с заданиями, отчётами и обновлениями.
- Определите допустимое влияние перезапуска на сеансы.
- Настройте оповещение до критического состояния.
- Проверьте поведение и сохраните условия возврата.
Плановый перезапуск может быть частью регламента, но не лечением утечки памяти. Если рост начался после доработки, сохраняйте диагностические данные до перезапуска и передавайте разработчику конкретный сценарий воспроизведения.
Что мониторить: от доступности до задержки операции
У мониторинга два результата: вовремя обнаружить ухудшение и сохранить историю для расследования. Используйте Zabbix или другую принятую систему; название продукта менее важно, чем правильные метрики, единое время и проверенные оповещения. Сбор серверных показателей не заменяет прикладной тест входа и выполнения операции.
| Уровень | Что собирать | Что это помогает различить |
|---|---|---|
| Пользователь | Успех входа, время типовой операции, ошибки, p95, Apdex | Реальное ухудшение работы, даже когда служба запущена |
| Процессы 1С | PID, CPU, память, время старта, перезапуски, сеансы и соединения | Рост одного процесса, массовый сбой, смену исполнителя |
| ОС и гипервизор | CPU по ядрам, доступная память, подкачка, дисковые задержки, сетевые потери, конкуренция за CPU | Нехватку ресурсов и влияние соседних ВМ |
| СУБД | Активные запросы, ожидания, блокирующие сессии, I/O, журналы, обслуживание | Работу CPU приложения и ожидание ответа базы |
| Задания и обмены | Длительность, успешность, очередь, время последнего успеха | Накопление отставания при формально работающих службах |
| Лицензии | Доступность источников, фактическую занятость, отказы, запас | Исчерпание пула и потерю одного из источников выдачи |
Пример прикладного контроля: каждые несколько минут специальный пользователь выполняет безопасный сценарий чтения. Записываются успех и время. Проведение документов таким тестом без специально подготовленной процедуры недопустимо: контроль не должен создавать хозяйственные операции.
Пример Apdex по спецификации 1.1: заранее выбраны порог T и граница терпимого ожидания 4T. Из 100 операций 80 уложились в T, 15 — в интервал больше T и до 4T, 5 были медленнее либо завершились ошибкой. Индекс: (80 + 15 / 2) / 100 = 0,875. Ошибки нельзя выбрасывать из выборки ради красивого результата. Для входа, отчёта и проведения нужны свои пороги; один общий индекс способен скрыть проблему конкретного действия.
Сначала соберите нормальный профиль за рабочий цикл, затем выбирайте предупреждения и аварийные пороги. «Нет свободных лицензий», «обмен не завершался час» и «диск заполнится через сутки» требуют разных действий. Каждое оповещение должно иметь ответственного и понятную первую проверку.
Лаги и фризы: короткий порядок расследования
- Зафиксировать точный эпизод: время с часовым поясом, пользователь, база, операция, параметры, начало и конец ожидания.
- Определить масштаб: один компьютер, одна база, один рабочий процесс, узел или все пользователи.
- Отделить интерфейс от серверного ожидания: локальная загрузка, RDP, канал, внешняя компонента, ответ сервера.
- Сопоставить сеанс и PID: клиент, рабочий процесс, запросы и блокировки СУБД в этот момент.
- Сохранить доказательства до перезапуска: временную линию метрик и подходящие журналы; дамп — только при необходимости и с учётом содержащихся в нём данных.
- Воспроизвести и сравнить: тот же сценарий с одним изменением и понятным результатом.
CPU низкий, а проведение «висит»
Проверьте ожидания и блокирующую транзакцию в СУБД, сеть и внешние вызовы. Добавление ядер не обязательно сократит ожидание чужой блокировки. Не завершайте блокирующую сессию, пока не выясните, что она делает и каковы последствия отката.
Средний CPU 15%, один отчёт очень медленный
Посмотрите нагрузку отдельных ядер и запрос конкретного сеанса. Последовательная операция может упираться в одно ядро, а среднее по большому серверу останется низким. Для отчёта проверьте объём выборки, план запроса и обращения к данным.
Фризы каждую ночь в одно время
Сопоставьте резервное копирование, обслуживание индексов, антивирусное сканирование, обмены и снимки ВМ. Перенос расписания может помочь, но окончательный вывод делают по повторному измерению. Не отключайте защиту и копирование без замены нужной функции.
Технологический журнал с одним EXCP из раздела выше не объяснит все эти случаи. Для каждого расследования выбирают целевые события, отборы и период сбора, оценивают объём записи и влияние на диск. Подробный SQL и длительная трассировка могут содержать коммерческие данные; доступ и хранение ограничивают.
Мониторинг и журналы: чтобы расследовать, а не только заметить
Сохраняйте не только текущее «работает/не работает», но и временную линию: нагрузка, PID, создание процессов, изменения правил, перезапуски, ошибки клиентов, задания и состояние СУБД. Синхронизация времени позволяет сопоставить источники.
Короткий диагностический фрагмент для технологического журнала может выглядеть так; это пример для отдельного согласованного сбора, а не команда перезаписать действующий logcfg.xml:
<?xml version="1.0" encoding="UTF-8"?>
<config xmlns="http://v8.1c.ru/v8/tech-log">
  <log location="D:\1C-TechLog" history="24">
    <event><eq property="Name" value="EXCP"/></event>
    <property name="all"/>
  </log>
</config>
Здесь собираются исключения EXCP; путь должен существовать и быть доступным служебной учётной записи, history задаёт глубину хранения в часах. Перед добавлением изучите действующую конфигурацию журналирования, место её чтения вашей сборкой и объём свободного диска. Схема logcfg.xml показана в методическом материале 1С. Для медленных запросов нужен иной целевой набор событий и отборов; EXCP не показывает всю производительность.
Журнал регистрации базы, технологический журнал, логи ОС и аудит доступа отвечают на разные вопросы. Чтобы выяснить, кто вошёл и что изменил, недостаточно графика CPU. Чтобы понять, почему выросла задержка, недостаточно одной записи об успешном входе. Сроки хранения, доступ и очистку согласуют заранее.
Шаг 5. Докажите фактическое размещение
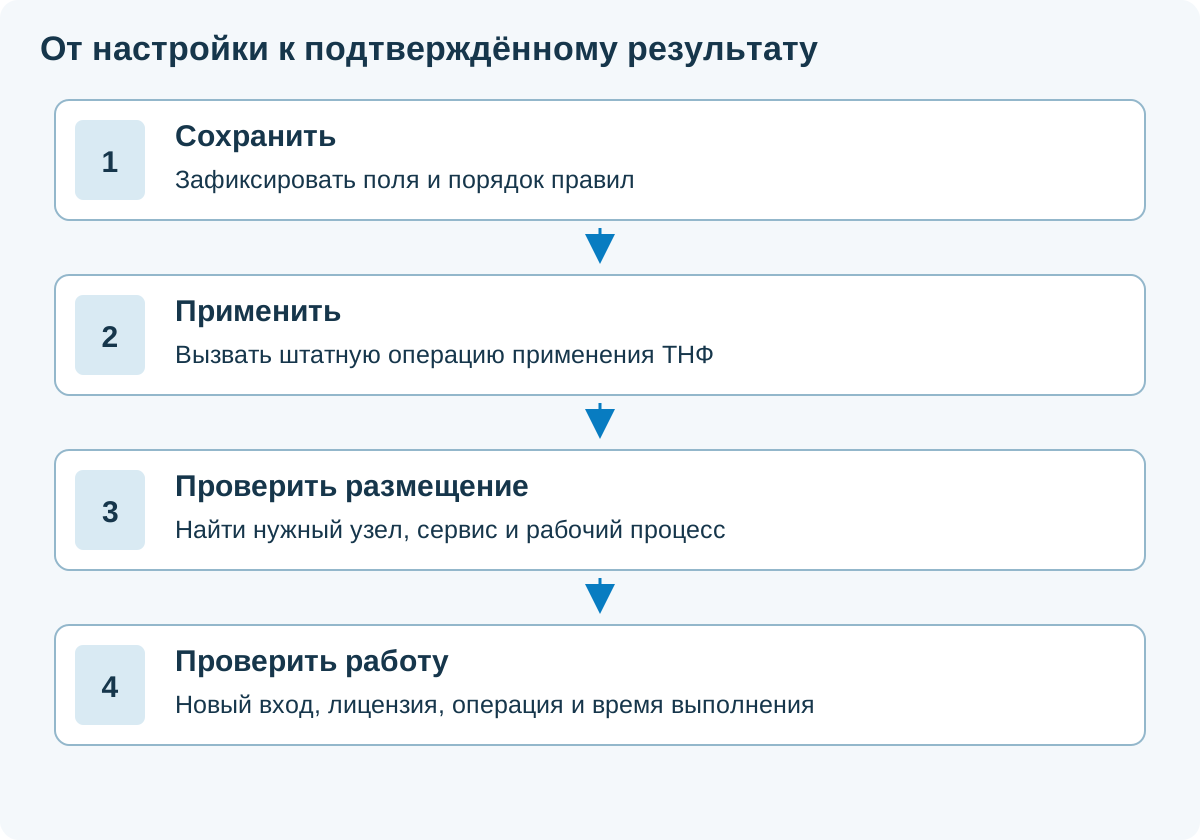
- Откройте свойства и порядок ТНФ, убедитесь, что требования применены.
- Проверьте узел и менеджер, где размещён нужный сервис.
- Создайте новый тестовый сеанс штатным способом и проверьте его рабочий процесс.
- Сопоставьте процесс с PID, адресом и диагностикой ОС.
- Проверьте результат бизнес-операции, а не только отсутствие ошибки входа.
- Сохраните время, исходные данные и вывод, включая обнаруженные ограничения.
Перемещение работы не обязательно выглядит как мгновенное исчезновение всех прежних процессов. Не используйте ожидание «через секунду rphost должен исчезнуть» как критерий успеха. Если наблюдение не соответствует проекту, разберите активные соединения, правила и поддерживаемую процедуру переназначения своей версии.
Для сравнения возьмите несколько знакомых операций: вход, открытие списка, проведение документа, отчёт и обмен. Запишите количество повторений, объём базы и параллельную нагрузку. Иначе ускорение может оказаться следствием прогретого кэша или того, что пользователи ушли на обед.
Типовые проблемы после изменения
Новое правило есть, эффекта нет
Проверьте применение, приоритет, правильный узел и объект. Убедитесь, что оцениваете новую работу, а не только старый сеанс. Не перезапускайте весь кластер до проверки этих условий.
Пользователи подключаются выборочно
Сопоставьте выданный адрес рабочего процесса с DNS и сетевыми разрешениями. Проверьте каждый узел, клиентский сегмент и фактические порты, а не только APP01:1541.
После выделения LIC01 не выдаются лицензии
Проверьте размещение сервиса, привязки, права на файлы и административные изменения. Открытый TCP-порт сам по себе не подтверждает получение лицензии. При необходимости возвращайте согласованную схему.
Память растёт, процессы часто перезапускаются
Сравните лимиты с общим бюджетом памяти и заданиями в этот момент. Сохраните журналы, исследуйте тяжёлые операции. Не увеличивайте порог бесконечно и не уменьшайте его до постоянного обрыва работы.
Отказоустойчивость: кластер приложения — только один слой
Механизмы кластера помогают переносить работу и переживать определённые отказы. Они не резервируют автоматически СУБД, хранилище, DNS, сеть и выдачу лицензий. Две ВМ на одном гипервизоре не защищают от потери этого гипервизора.
Для проекта проверьте три вопроса: какие компоненты дублируются, хватает ли оставшихся ресурсов и какой результат увидит пользователь. Развитие отказоустойчивости сервиса заданий зависит от механизмов конкретного релиза; старое обещание «пользователь ничего не заметит» нельзя превращать в гарантию для всей инфраструктуры.
При испытании согласуйте окно и тип отказа: завершение одного процесса, остановка узла и потеря сетевой связи — разные тесты. Проверяйте повторное подключение, отсутствие непредусмотренного повторения бизнес-действий, целостность результата и время возврата. Не начинайте проверку с отключения питания рабочего сервера.
Возврат и приёмка
- Зафиксируйте, какое новое правило или параметр дал нежелательный результат.
- Восстановите прежний список и порядок ТНФ, затем явно примените его.
- Верните изменённые свойства по карточке, не затрагивая остальные настройки.
- Проверьте размещение, новый вход, лицензирование и контрольные операции.
- Если требуются действия со служебными файлами или восстановление, используйте согласованную процедуру с нужным состоянием служб.
- Сохраните журналы инцидента и обновите документацию.
Не удаляйте реестр кластера как универсальный способ отмены. Возврат виртуального снимка может затронуть лицензии, состояние базы и соседние изменения; его применимость проверяют до работ. Успех означает, что выполнены критерии приёмки, а не просто появилась зелёная строка службы.
Смешанный набор USB-ключей и программных лицензий
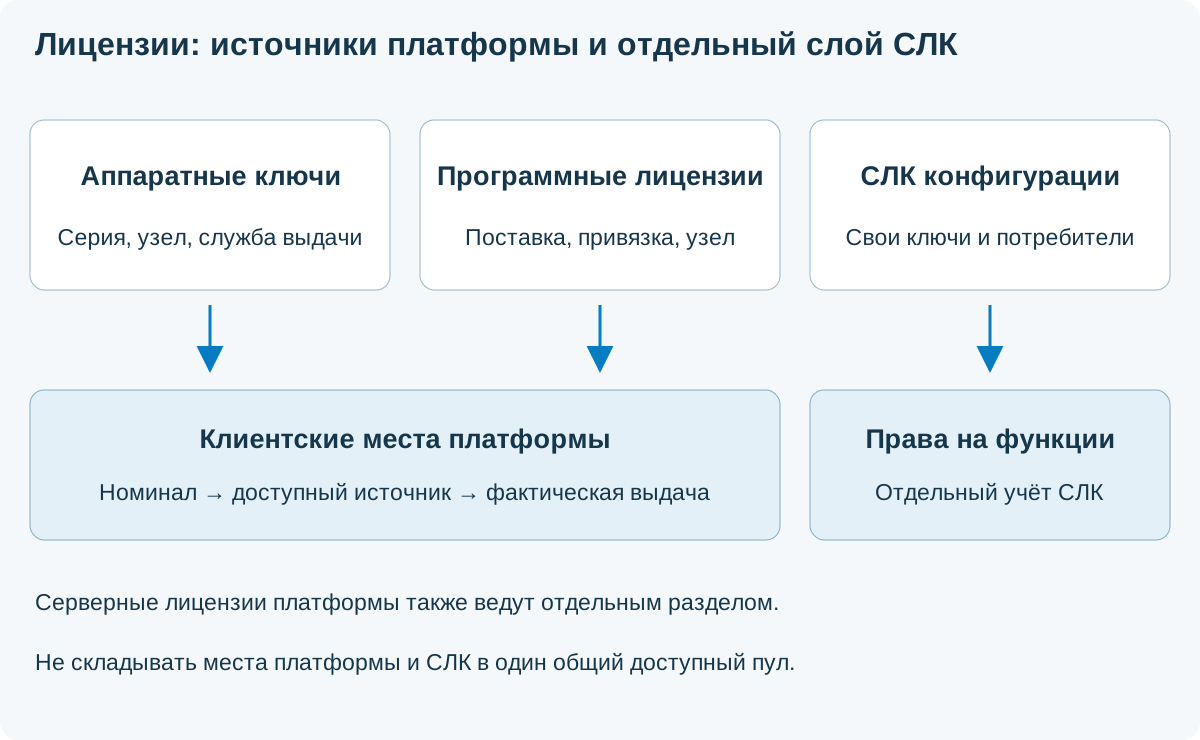
1С допускает совместное использование программных и аппаратных лицензий. Но общей суммы чисел на коробках недостаточно: нужно понять, кто, откуда и каким способом получает каждую лицензию. Серверные права, клиентские места платформы и защита конфигурации учитываются отдельно.
Сначала инвентаризация: назначение, регистрационный номер, уровень ПРОФ/КОРП, количество мест, тип защиты, серия аппаратного ключа, компьютер размещения, служба выдачи и потребитель. Сетевой ключ, локальный ключ и программная лицензия на терминальном сервере — разные способы получения прав. При переносе сервиса лицензирования нельзя считать, что все USB-ключи в сети «переехали» вместе с ним.
Для традиционных аппаратных ключей 1С HASP действует ограничение серии: официальная инструкция описывает не более одного ключа одной серии на компьютер. Поэтому два ключа 50 + 50 нельзя без проверки воткнуть в один USB-хаб и обещать 100 мест. Разнесение источников или официальный обмен проектируют по поколениям ключей и действующей системе защиты. Это правило нельзя автоматически переносить на отраслевые ключи СЛК.
Несколько программных лицензий также не требуют механического объединения в один файл. Их совместное использование и допустимый обмен проверяют по условиям поставок; подробнее — в статье о ключах 1С.
Условный пример: имеются сетевые аппаратные ключи на 50 и 20 мест и программный пакет на 30. Это 100 номинальных клиентских мест платформы, но доступный конкретному пользователю пул может оказаться меньше из-за размещения, прав и способа получения. А одновременный сеанс в отраслевом приложении может дополнительно требовать место СЛК. Одни и те же места нельзя повторно записывать как отдельный резерв для каждого из трёх контуров.
Способ получения влияет и на расход: локально полученная клиентом лицензия и выдача сервером на сеансы имеют разные правила учёта нескольких запусков. Не переводите число сотрудников в число лицензий по коэффициенту «один человек — одно место» без проверки. Снимите реальную занятость в пиковые периоды и разберите повторные сеансы, тестовые базы, интеграции и терминальные подключения.
Как контролировать выдачу и запас лицензий
- Для каждого источника: подтвердить доступность службы, ключа или программной лицензии и соответствие реестру.
- Для каждого контура: проверить новый запуск с типового рабочего места и фактический источник полученной лицензии доступными средствами своей версии.
- В пике: записать занятость, свободные места и отказы; разделить истощение пула и потерю источника.
- При отказе: сохранить журнал поиска лицензии и диагностический вывод, а не только текст «не найдена».
- При изменении: проверить восстановление после перезагрузки, миграции ВМ, замены узла и обновления платформы.
Для 8.5.4 правила отличаются от базового примера 8.3.27
В 8.5.4 введены менеджер лицензий и функция «Управление лицензиями», показывающая доступные и занятые лицензии и приложения-потребители. Инструкция перехода требует для сетевых ключей нового rmlic; при параллельной работе старых версий описан режим сосуществования с HASP License Manager. Не останавливайте старую службу до проверки всех потребителей.
Для 8.3.27 используют средства этой версии и установленного менеджера аппаратных ключей; новую функцию 8.5.4 нельзя обещать в старой сборке. Не путайте rmlic, кластерный сервис лицензирования, HASP License Manager и отраслевой сервер СЛК: названия похожи, назначение и диагностические данные различаются.
Запас лицензий назначают под измеренный пик и согласованный сценарий отказа, а не произвольные 20% для любой компании. Если потеря одного источника оставляет 30 свободных мест при потребности 60, второй сервер приложения эту нехватку не исправит. Права на использование и техническая доступность источника должны подтверждаться отдельно.
СЛК: дополнительный слой отраслевого лицензирования
1С:СЛК — система лицензирования и защиты конфигураций. Она применяется поставщиками прикладных решений и не заменяет ни клиентскую, ни серверную лицензию платформы. Наличие свободных мест 1С не гарантирует право запуска защищённого отраслевого модуля.
Для каждой конфигурации выясните, используется ли СЛК, какое поколение компонентов требуется, где сервер и ключи, какие функции защищены и как расходуются дополнительные места. Требования берут из документации именно этого решения: нельзя объявлять одинаковые порты, драйверы и правила суммирования ключей для всех отраслевых программ.
В реестре заведите отдельный раздел СЛК: продукт и поставщик, серия и назначение ключа, основной/дополнительный, количество мест, узел, версии сервера и компонентов, журнал ошибок и ответственный. Проверьте доступ с каждого рабочего сервера, где может выполняться защищённая функция, а также с клиента, если этого требует архитектура решения.
Характерный инцидент: пользователь вошёл в базу, обычные формы работают, отраслевой расчёт выдаёт ошибку защиты. Исследовать надо не только платформенный пул, но и доступность СЛК, нужную лицензию функции и совместимость компонентов. При резервировании приложения учитывают этот слой отдельно; USB-переадресация и перенос ключей требуют проверки поддержки и условий поставки.
Шаблоны для настройки и проверки
Настроим и будем сопровождать инфраструктуру 1С
ИТ-аутсорсинг
- Обследование кластера и нагрузки.
- Изменения с проверкой и возвратом.
- Мониторинг, журналы и резервные копии.
Согласуем задачи и измеримые критерии результата.
Обсудить сопровождение 1СОблачные ресурсы
- Ресурсы под приложение и СУБД.
- Тестовый контур до переноса.
- План доступности и восстановления.
Подберём ресурсы и отдельно проверим лицензионные условия.
Подобрать облачные ресурсыВопросы и ответы
Кластер означает минимум два сервера?
Нет. Логический кластер может работать и на одном узле. Число узлов выбирают под нагрузку и требования доступности.
В ПРОФ совсем нет ТНФ?
Есть ограниченный вариант с пустыми именем базы и дополнительным параметром. Полную адресную маршрутизацию не следует выдавать за возможность ПРОФ.
Сохранение правила сразу меняет размещение?
Правила необходимо явно применить, затем проверить результат. Одной сохранённой формы недостаточно.
Нужно ли всегда делать отдельный узел лицензирования?
Нет. Это проектное решение с собственными зависимостями и расходами, а не обязательный шаг для каждого клиента.
Можно ли всем rphost дать почти всю RAM?
Нет. Бюджет общий для процессов, ОС и других служб. Порог выбирают по измерениям и проверяют поведение при превышении.
Перенос сервиса заданий разгружает СУБД?
Не обязательно. Управляющий сервис и выполнение прикладного задания различаются; запросы и блокировки нужно исследовать отдельно.
Что доказывает TcpTestSucceeded?
Только успешную TCP-проверку указанного адреса и порта. Это не подтверждение входа в базу, лицензии или выполнения операции.
Эти схемы — результат настройки реального сервера?
Нет. Это учебные схемы и примеры команд. Проверка действующего кластера выполняется отдельно на доступном стенде или в согласованном контуре.
Можно на ПРОФ закрепить отчёты и задания одной базы за разными узлами?
Показанные адресные ТНФ с дополнительными фильтрами требуют КОРП. На ПРОФ рассматривают общий пул либо самостоятельные базы с поддерживаемым обменом, учитывая задержку и стоимость разделения.
50 + 20 аппаратных и 30 программных мест всегда дают 100 доступных мест?
Это 100 номинальных мест. Доступность зависит от типов ключей, размещения, пути выдачи и прав. Реальный расход проверяют отдельно; СЛК ведут своим пулом.
Что смотреть, когда CPU низкий, но 1С зависает?
Масштаб проблемы, блокировки и ожидания СУБД, сеть, внешние вызовы и клиентский интерфейс. Низкий средний CPU не исключает ожидание или загрузку одного ядра.
Чем СЛК отличается от лицензии платформы?
СЛК защищает функции конкретного прикладного решения. Она не заменяет клиентские и серверные права платформы, её доступность проверяют отдельно.